在CDA(Certified Data Analyst)数据分析师的能力体系中,线性回归 是连接描述性统计与预测性分析的关键桥梁,也是CDA二级认证的核心必考模块,更是企业业务分析、数据建模 、决策支撑场景中应用最广泛的基础算法。不同于相关系数 仅能衡量变量间的线性关联程度,线性回归 能够精准量化自变量对因变量的影响方向与边际效应,同时实现对连续型数值的预测,兼具归因分析与趋势预测双重核心价值。
对CDA数据分析师而言,线性回归 不仅是一项建模技能,更是一套严谨的数据分析方法论:从业务问题拆解、变量筛选,到数据预处理 、模型构建、假设检验 、优化迭代,再到最终的业务解读与决策落地,全程贴合CDA“严谨、规范、落地”的专业要求。相比于复杂的机器学习 算法,线性回归 解释性强、计算高效、结果易懂,无需高深算法功底即可落地,完美适配零售、电商、金融、互联网等多行业的日常分析需求。本文结合CDA认证大纲与企业真实实战场景,系统拆解线性回归 的核心原理、建模全流程、经典假设检验 、模型评估 优化及业务落地技巧,助力CDA从业者熟练掌握这项核心技能,实现从数据关联 到业务价值的跨越。
一、核心认知:CDA视角下线性回归 的本质与核心价值 线性回归 是一种基于最小二乘 法,构建连续型因变量 与一个或多个自变量 之间线性关系的统计模型,核心是通过拟合 最优线性方程,量化自变量对因变量的影响,同时实现对因变量的预测。根据自变量数量,可分为简单线性回归 (单个自变量)与多元线性回归 (两个及以上自变量),其中多元线性回归 是CDA考核与职场实操的重点。
其标准数学模型为:
式中,
1. CDA分析师的核心应用价值
精准归因,量化影响 :通过回归系数清晰判断各自变量对因变量的影响方向与边际效应,比如“广告投入每增加1万元,销售额平均增加6.2万元”“商品单价每提升10元,日均销量下降80件”,彻底摆脱模糊的定性分析,为业务优化提供精准数据依据。
科学预测,辅助规划 :基于已知自变量取值,预测未来因变量的数值,比如根据下月营销预算、促销计划,预测月度销售额;根据用户特征 数据,预测用户消费金额,助力企业制定预算、规划目标、管控风险。
变量筛选,聚焦核心 :通过模型显著性检验与系数检验,从众多影响因素中筛选出核心显著变量,剔除无关或干扰因素,帮助分析师聚焦关键业务抓手,避免无效资源投入。
门槛低、解释性强 :模型原理易懂,结果直观,非技术背景的业务方也能快速理解,便于跨部门沟通汇报,符合CDA分析师“数据赋能业务”的核心定位。
2. 适用场景(CDA高频业务场景) 线性回归 适用于因变量为连续数值型 的场景,核心包括:销售额/利润预测、广告投放效果归因、用户消费能力预估、运营指标影响因素分析、成本管控与预算制定、房屋/商品定价等;不适用于分类变量预测(如用户是否流失、是否购买,此类场景需用逻辑回归 )。
二、CDA标准建模流程:从业务问题到模型落地六步法 CDA数据分析师开展线性回归 建模,必须遵循标准化、可复现的流程,兼顾业务逻辑与统计严谨性,杜绝盲目建模,全程贴合认证规范与职场实操要求,具体分为六大核心步骤:
1. 拆解业务问题,明确变量定义 建模的起点是业务而非数据,首先将模糊的业务问题转化为明确的建模目标,精准定义因变量与自变量,避免变量混淆。
因变量Y :核心业务目标,必须是连续数值型,如“月度销售额”“用户日均消费金额”;
自变量X :选取理论上与Y相关的影响因素,优先选择可量化、可获取、可优化的指标,如广告费用、促销力度、用户活跃度、商品价格等,同时避免纳入逻辑重复的变量。
示例 :业务问题“分析影响电商店铺销售额的核心因素,并预测下月销售额”,定义Y=月度销售额,X1=广告投放费用、X2=促销活动频次、X3=日均访客数、X4=商品均价。
2. 数据预处理 (建模关键前提) 数据质量 直接决定模型效果,CDA分析师需完成全面数据清洗 ,重点处理以下问题:
缺失值 处理缺失值 ;
变量类型转换 :将分类型变量(如用户等级、渠道类型)通过哑变量编码转换为数值型变量,纳入模型;
多重共线性初步排查 :通过相关系数 矩阵,剔除高度相关(|r|>0.8)的冗余变量,避免后续模型失真。
3. 相关性初步检验 建模前通过散点图 直观观察自变量与因变量的线性趋势,结合相关系数 判断线性关联强度,无线性趋势的变量无需纳入模型,保障模型的线性基础,这也是CDA认证中强调的前置步骤。
采用最小二乘 法(OLS)拟合模型,该方法通过最小化残差平方和,求解最优回归系数,是CDA要求掌握的核心估计方法。实操中无需手动计算,通过Excel数据分析插件、Python(Statsmodels/Scikit-learn)、SPSS即可快速建模,输出回归方程与各项检验指标。
5. 模型显著性与经典假设检验 (CDA核心考点) 模型构建完成后,必须进行双重检验,确保模型有效且符合统计规范,这是区分专业建模与盲目拟合的关键,也是CDA二级认证的重点考核内容。
(1)模型与系数显著性检验
F检验(模型整体显著性) :判断所有自变量联合起来对因变量是否有显著影响,p<0.05说明模型整体显著,具备统计意义;
t检验(单个系数显著性) :判断每个自变量对因变量是否有独立显著影响,p<0.05说明该变量影响显著,保留;p≥0.05说明影响不显著,剔除后重新建模。
(2)经典线性假设检验 (四大核心假设) 线性回归 成立需满足四大经典假设,违反假设会导致模型系数偏差 、结果不可靠,CDA分析师必须掌握检验与优化方法:
线性假设 :自变量与因变量存在线性关系,通过残差图检验,若呈现随机无规律分布则满足;
独立性假设 :样本数据相互独立,残差无自相关,避免时间序列数据的序列相关性;
多重共线性假设 :自变量间无高度线性相关,通过方差 膨胀因子(VIF)检验,VIF<10说明无严重共线性,VIF>10需剔除冗余变量。
通过核心指标评估模型拟合效果,针对性优化迭代,提升模型可靠性与预测精度 :
拟合优度R² :衡量模型对因变量变异的解释程度,取值0-1,数值越大拟合效果越好;多元线性回归 优先用调整后R²,避免自变量过多导致虚高;
优化方向 :剔除不显著变量、处理多重共线性、修正异方差 、转换非线性变量,反复迭代至模型通过所有检验、拟合效果达标。
三、CDA核心解读:回归系数与模型结果业务化翻译 CDA分析师建模的核心不是输出数学方程,而是将统计结果转化为业务语言,让非技术人员读懂并指导决策,回归系数是核心解读对象:
系数符号 :正号代表自变量与因变量正相关,变量提升则因变量上升;负号代表负相关,变量提升则因变量下降;
系数数值 :代表边际效应,即自变量每变动1个单位,因变量平均变动的数值,比如广告费用系数为6.2,即广告投入每增1万元,销售额平均增6.2万元;
系数显著性 :仅显著(p<0.05)的系数具备业务解读意义,不显著系数无统计价值,无需解读。
示例:某电商店铺销售额回归模型:
业务解读:固定其他因素,广告投入每增1万元,销售额增6.2万元;促销频次每增1次,销售额增3.8万元;商品均价每增1元,销售额降0.5万元,模型整体显著,可用于销售额预测。
四、CDA常用工具实操:快速构建线性回归 模型 CDA分析师根据数据量级与场景,灵活选用工具,操作贴合认证要求与职场效率需求:
1. Excel(入门首选,轻量数据) 通过【数据分析】插件选择【回归】,输入因变量和自变量区域,勾选残差图、拟合优度等选项,一键输出完整模型结果、系数检验表、残差图,无需编程,适合快速完成基础建模与汇报。
2. Python(专业高效,海量数据) 用Statsmodels构建专业线性回归 模型,输出完整检验结果,是CDA二级认证重点考核工具,核心代码如下:
import pandas as pdimport statsmodels.api as sm"sales_data.csv" )"advertising" ,"promotion" ,"price" ]]"sales" ]五、CDA避坑指南:线性回归 常见误区与规避方法
误区1:忽视经典假设,盲目建模 :未检验共线性、异方差 ,直接解读系数,导致结果偏差 。规避:建模后必做假设检验 ,违反假设及时修正。
误区2:混淆相关与因果 :将回归系数的关联关系等同于因果关系,比如冰淇淋销量与溺水人数正相关,实则均受气温影响。规避:结合业务逻辑判断因果,不单纯依赖模型结论。
误区3:过度追求高R² :盲目添加自变量提升拟合优度,导致模型过拟合 ,预测能力下降。规避:优先保证模型显著与假设成立,兼顾拟合度与简洁性。
误区4:变量筛选随意 :纳入逻辑无关、数据劣质的变量,干扰模型结果。规避:基于业务逻辑初选变量,结合显著性检验逐步筛选。
误区5:误用分类因变量 :用线性回归 预测分类变量(如是否购买、是否流失),模型完全失效。规避:分类因变量改用逻辑回归 ,连续型因变量才用线性回归 。
六、结语:线性回归 ,CDA分析师的预测分析入门基石 线性回归 是CDA数据分析师进入预测性分析领域的必修课,也是最具实用性的基础建模工具。它没有复杂的算法原理,却能解决企业80%的常规连续值预测与归因问题,是分析师从数据整理、描述分析,进阶到专业建模、决策支撑的核心标志。
对CDA从业者而言,掌握线性回归 的关键,不在于死记公式,而在于理解“业务问题—数据预处理 —模型构建—检验优化—业务解读”的完整逻辑,牢记经典假设与检验规范,始终立足业务场景转化模型结果。无论是CDA认证备考,还是职场实战,吃透线性回归 ,就能快速搭建起数据建模 的核心思维,精准挖掘变量影响、科学预测业务趋势,为企业预算制定、策略优化、风险管控提供专业、可靠的数据支撑,成长为兼具统计功底与业务思维的优质CDA数据分析师。
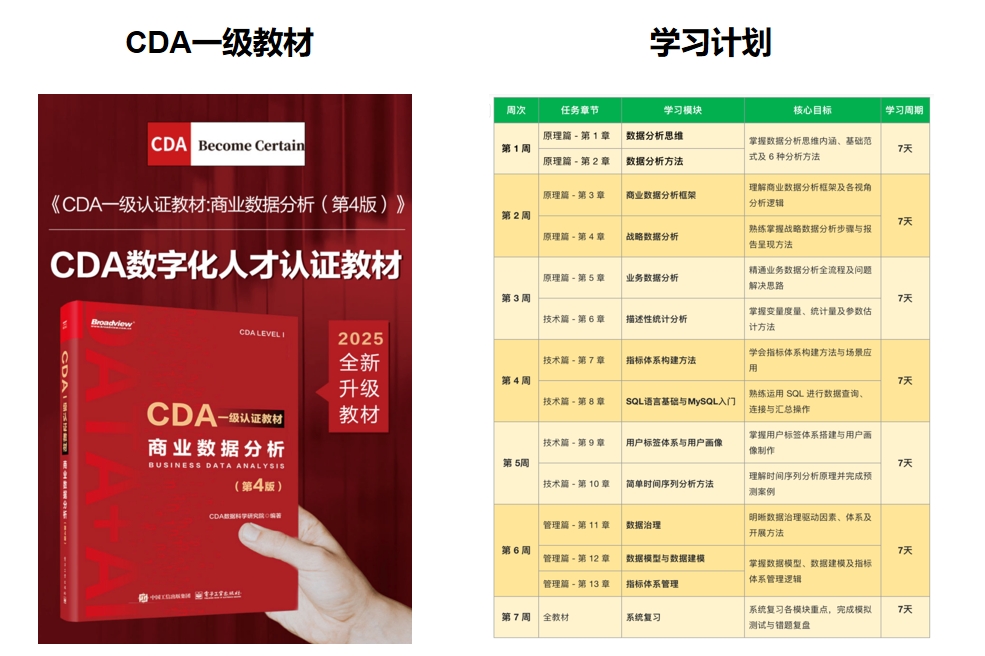
推荐学习书籍 《CDA一级教材 》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ ! 


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330