在数据分析全流程中,数据处理是基础,图形可视化是核心呈现手段——前者负责将杂乱无章的原始数据转化为干净、规范、可分析的格式,后者则将抽象的数据规律转化为直观、易懂的图形,两者相辅相成,共同支撑数据分析结论的得出与传递。Python凭借其丰富的开源模块生态,成为数据处理与可视化的首选工具,其中Pandas、NumPy作为数据处理的核心模块,Matplotlib、Seaborn作为图形可视化的主流工具,已广泛应用于学术研究、业务分析、数据建模等各类场景。
无论是前文提及的“调整数据减小p值”,还是日常的数据分析任务,都离不开数据处理模块的支撑的图形可视化的辅助——数据处理为后续的统计检验、参数调整提供干净的数据基础,图形可视化则能直观呈现数据分布、变量关联,帮助研究者快速发现数据规律、验证分析假设。本文将系统拆解Python数据处理与图形可视化的核心模块,详解各模块的核心功能、实操方法及联动应用,结合具体案例,帮助开发者快速掌握Python数据处理与可视化的核心技能,提升数据分析效率与结果呈现质量。
一、数据处理核心模块:Pandas与NumPy,筑牢数据分析基础
数据处理的核心目标是“清洗数据、整合数据、转换数据”,剔除无效信息、规范数据格式,为后续的统计分析、可视化呈现奠定基础。Python中,NumPy负责数值计算与数组操作,Pandas则专注于表格数据的处理,两者协同工作,可高效完成从原始数据到规范数据的全流程处理,也是前文“调整数据减小p值”中,异常值处理、缺失值填补、数据转换等操作的核心工具。
1. NumPy:数值计算的基石,高效处理数组数据
NumPy(Numerical Python)是Python数值计算的核心模块,底层由C语言编写,具备高效的数组运算能力,主要用于处理一维、二维甚至多维数组,提供了丰富的数值计算函数,能够快速完成数据的统计、转换、运算等操作,解决Python原生列表运算效率低下的问题[1]。其核心优势在于“向量化运算”,可避免繁琐的循环操作,大幅提升数据处理速度,尤其适合大规模数值数据的处理。
核心功能与实操案例
- 数组创建与基础运算:可快速创建一维、二维数组,支持加减乘除、矩阵运算、统计运算等,替代Python原生列表的低效循环。
示例:创建二维数组并计算均值、标准差,为后续数据分布分析提供基础。
import numpy as np
data = np.array([[12, 15, 18], [10, 14, 16], [8, 11, 13]])
mean_total = np.mean(data)
mean_row = np.mean(data, axis=1)
mean_col = np.mean(data, axis=0)
std_data = np.std(data)
- 异常值识别与处理:结合NumPy的条件索引,可快速识别异常值,为数据清洗提供支撑,对应前文“优化数据质量”的核心需求。
示例:用Z-score法识别异常值(Z-score绝对值大于3视为异常值)。`
z_score = (data - np.mean(data)) / np.std(data)
outliers = np.abs(z_score) > 3
data_clean = data[~outliers]`
- 数据转换:提供对数转换、平方根转换等函数,可快速完成数据分布调整,适配统计检验的前提假设,助力p值合理减小。
示例:对偏态分布数据进行对数转换,使其更接近正态分布。`
skewed_data = np.array([1000, 1200, 1500, 2000, 5000, 8000, 10000])
transformed_data = np.log1p(skewed_data)
2. Pandas:表格数据处理神器,适配复杂数据分析场景
Pandas基于NumPy开发,专注于表格数据(类似Excel表格)的处理,提供了DataFrame这一核心数据结构,可轻松实现数据的读取、清洗、筛选、分组、聚合等操作,是日常数据分析中最常用的模块[2]。无论是缺失值填补、数据分组,还是干扰变量控制,Pandas都能提供简洁高效的解决方案,尤其适合处理结构化数据,也是前文“调整数据减小p值”中,样本量调整、干扰变量控制的核心工具。
核心功能与实操案例
- 数据读取与预处理:支持CSV、Excel、JSON等多种格式的数据读取,快速将原始数据转化为DataFrame,同时提供便捷的缺失值、重复值处理功能。
示例:读取Excel数据,处理缺失值与重复值,优化数据质量。
import pandas as pd
df = pd.read_excel("data.xlsx")
print(df.isnull().sum())
df["数值字段"] = df["数值字段"].fillna(df["数值字段"].median())
df["分类字段"] = df["分类字段"].fillna(df["分类字段"].mode()[0])
df = df.drop_duplicates()`
- 数据筛选与分组:可根据条件筛选有效样本,或按干扰变量分组,控制干扰因素,强化核心变量关联,助力p值减小。
示例:按年龄分组,分析不同年龄段的学历与收入相关性,控制年龄干扰。`
df_grouped = df.groupby(pd.cut(df["年龄"], bins=[24, 30, 40], labels=["25-30岁", "31-40岁"]))
for group_name, group_data in df_grouped:
corr = group_data["学历"].corr(group_data["收入"])
print(f"{group_name} 学历与收入相关性:{corr:.3f}")`
- 样本量调整:可快速筛选有效样本、补充样本(结合外部数据),实现样本量的合理扩大,提升统计检验功效。
示例:筛选有效样本,确保样本量达到预设要求,助力p值降至显著性水平。`
df_valid = df[(df["收入"] > 0) & (df["学历"].notna())]
print(f"有效样本量:{len(df_valid)}")
二、图形可视化核心模块:Matplotlib与Seaborn,让数据规律可视化
图形可视化的核心目标是“将抽象数据转化为直观图形”,帮助研究者快速发现数据分布、变量关联、异常值等关键信息,同时也能清晰呈现数据分析结果,增强结论的说服力。Python中,Matplotlib是最基础、最通用的可视化模块,可绘制各类基础图形;Seaborn基于Matplotlib开发,简化了复杂图形的绘制流程,且自带美观的样式,更适合统计可视化场景,两者结合可满足绝大多数数据分析的可视化需求。
在“调整数据减小p值”的场景中,可视化模块可发挥重要作用:通过图形呈现数据分布(如正态性检验图)、异常值(如箱线图)、变量关联(如散点图),帮助研究者判断数据调整的方向,验证调整效果,确保数据调整的科学性与合理性。
1. Matplotlib:基础可视化工具,灵活绘制各类图形
Matplotlib是Python可视化的基础模块,提供了丰富的图形绘制接口,可绘制折线图、散点图、直方图、箱线图、柱状图等各类图形,支持自定义图形样式、标签、颜色等,灵活性极高,适合各类场景的可视化需求[3]。其核心优势在于“灵活可控”,可根据需求定制各类复杂图形,是后续Seaborn模块的基础。
核心图形与实操案例
示例:绘制收入数据的箱线图,直观识别异常值。
import matplotlib.pyplot as plt
plt.rcParams['font.sans-serif'] = ['SimHei']
plt.rcParams['axes.unicode_minus'] = False
plt.figure(figsize=(8, 4))
plt.boxplot(df["收入"], patch_artist=True, boxprops=dict(facecolor='lightblue'))
plt.title("收入数据箱线图(异常值识别)")
plt.ylabel("收入(元)")
plt.grid(axis='y', linestyle='--', alpha=0.7)
plt.show()
- 直方图/QQ图:检验数据分布,辅助数据转换,确保数据贴合统计检验假设。
示例:绘制收入数据的直方图与QQ图,检验是否符合正态分布。`
plt.figure(figsize=(12, 4))
plt.subplot(1, 2, 1)
plt.hist(df["收入"], bins=10, color='lightgreen', edgecolor='black')
plt.title("收入数据直方图")
plt.xlabel("收入(元)")
plt.ylabel("频数")
from scipy import stats
plt.subplot(1, 2, 2)
stats.probplot(df["收入"], plot=plt)
plt.title("收入数据QQ图(正态性检验)")
plt.tight_layout()
plt.show()
- 散点图:呈现两个变量的关联关系,直观判断变量间的相关性,辅助验证p值调整效果。
示例:绘制学历与收入的散点图,直观呈现两者的相关性。`plt.figure(figsize=(8, 5))
plt.scatter(df["学历"], df["收入"], color='orange', alpha=0.6)
plt.title("学历与收入相关性散点图")
plt.xlabel("学历(1=专科,2=本科,3=硕士及以上)")
plt.ylabel("收入(元)")
plt.grid(alpha=0.3)
plt.show()
2. Seaborn:统计可视化工具,简化复杂图形绘制
Seaborn基于Matplotlib开发,继承了Matplotlib的灵活性,同时简化了代码编写流程,自带美观的默认样式,且专注于统计可视化,可快速绘制相关性热力图、分组箱线图、回归图等,尤其适合多变量分析、统计检验结果的可视化[4]。在“调整数据减小p值”的场景中,Seaborn可快速呈现分组数据的差异、变量间的相关性,帮助研究者优化调整策略。
核心图形与实操案例
- 相关性热力图:直观呈现多变量间的关联关系,帮助识别干扰变量。
示例:绘制多变量相关性热力图,识别影响核心关联的干扰变量。
import seaborn as sns
variables = ["学历", "收入", "年龄", "工作年限"]
corr_matrix = df[variables].corr()
plt.figure(figsize=(8, 6))
sns.heatmap(corr_matrix, annot=True, cmap='coolwarm', fmt='.3f', linewidths=0.5)
plt.title("多变量相关性热力图")
plt.show()
- 分组箱线图:控制干扰变量后,呈现核心变量的分组差异,验证调整效果。
示例:按年龄分组,绘制收入的箱线图,观察不同年龄段的收入差异。`plt.figure(figsize=(10, 5))
sns.boxplot(x="年龄分组", y="收入", data=df, palette='Set2')
plt.title("不同年龄段收入箱线图")
plt.xlabel("年龄分组")
plt.ylabel("收入(元)")
plt.grid(axis='y', alpha=0.3)
plt.show()
- 回归拟合图:呈现核心变量的回归关系,直观判断效应大小,辅助评估p值调整的实际意义。
示例:绘制学历与收入的回归拟合图,呈现两者的线性关系及效应大小。`plt.figure(figsize=(8, 5))
sns.regplot(x="学历", y="收入", data=df, color='green', line_kws={'color':'red'})
plt.title("学历与收入回归拟合图")
plt.xlabel("学历(1=专科,2=本科,3=硕士及以上)")
plt.ylabel("收入(元)")
plt.grid(alpha=0.3)
plt.show()
三、数据处理与可视化的联动应用:完整实操案例
数据处理与图形可视化并非孤立存在,而是紧密联动的——数据处理为可视化提供干净、规范的数据,可视化则为数据处理提供方向指导,两者结合可形成“数据处理→可视化分析→优化调整→再可视化验证”的闭环,尤其适合“调整数据减小p值”这类需要反复优化的场景。以下结合具体案例,详解两者的联动应用流程。
案例:调整数据使“学历与收入相关性”的p值减小
- 步骤1:数据读取与初步处理(Pandas+NumPy)
读取原始数据,处理缺失值、异常值,优化数据质量:
import pandas as pd
import numpy as np
df = pd.read_excel("学历收入数据.xlsx")
df["收入"] = df["收入"].fillna(df["收入"].median())
df["学历"] = df["学历"].fillna(df["学历"].mode()[0])
z_score = (df["收入"] - df["收入"].mean()) / df["收入"].std()
df = df[np.abs(z_score) < 3]
- 步骤2:可视化分析,发现问题(Matplotlib+Seaborn)
通过散点图、热力图,分析变量关联与干扰因素:
import matplotlib.pyplot as plt
import seaborn as sns
plt.rcParams['font.sans-serif'] = ['SimHei']
plt.figure(figsize=(8, 5))
sns.scatterplot(x="学历", y="收入", data=df)
plt.title("学历与收入散点图(初始数据)")
plt.show()
corr_matrix = df[["学历", "收入", "年龄", "工作年限"]].corr()
sns.heatmap(corr_matrix, annot=True, cmap='coolwarm')
plt.show()
- 步骤3:优化数据调整,控制干扰变量(Pandas)
按年龄分组,控制干扰变量,同时扩大有效样本量:
df["年龄分组"] = pd.cut(df["年龄"], bins=[24, 30, 40], labels=["25-30岁", "31-40岁"])
df_valid = df[(df["收入"] > 0) & (df["学历"].notna())].head(80)
- 步骤4:可视化验证调整效果,统计检验(Matplotlib+Seaborn+scipy)
绘制分组散点图,验证关联增强效果,计算调整后的p值:
plt.figure(figsize=(10, 5))
sns.scatterplot(x="学历", y="收入", hue="年龄分组", data=df_valid)
plt.title("学历与收入分组散点图(调整后)")
plt.show()
from scipy.stats import pearsonr
corr, p_value = pearsonr(df_valid["学历"], df_valid["收入"])
print(f"调整后学历与收入相关性:{corr:.3f},p值:{p_value:.3f}")
四、核心注意事项
模块选型要适配场景:NumPy适合大规模数值计算,Pandas适合表格数据处理;Matplotlib适合自定义复杂图形,Seaborn适合统计可视化,避免过度使用复杂模块导致代码冗余。
数据处理优先于可视化:可视化的前提是数据干净、规范,若原始数据存在大量噪声、缺失值,需先通过Pandas、NumPy处理,再进行可视化,否则会导致可视化结果失真,误导分析判断。
可视化要贴合分析目标:绘制图形时,需明确分析目标(如识别异常值、呈现相关性、验证调整效果),选择合适的图形类型,避免盲目绘制,确保图形能够传递有效信息。
避免可视化误导:绘制图形时,需合理设置坐标轴范围、刻度,避免人为放大或缩小数据差异;同时,图形标注要清晰、准确,确保读者能够正确理解数据规律。
五、总结:Python数据处理与可视化,赋能高效数据分析
Python的Pandas、NumPy、Matplotlib、Seaborn四大核心模块,构建了完整的数据处理与可视化体系——Pandas与NumPy负责筑牢数据基础,实现数据的清洗、转换、整合,为后续的统计分析、p值调整提供支撑;Matplotlib与Seaborn负责将抽象数据转化为直观图形,帮助研究者发现数据规律、验证调整效果、传递分析结论。
无论是前文提及的“调整数据减小p值”,还是日常的数据分析任务,这四大模块都是不可或缺的工具。其核心价值在于“高效、便捷、灵活”,无需复杂的代码编写,就能完成从原始数据到规范数据、从抽象数据到直观图形的全流程处理,大幅提升数据分析效率与结果呈现质量。
对于研究者而言,掌握这些核心模块的实操方法,不仅能解决“数据杂乱、分析低效、结果难呈现”的问题,更能形成“数据处理→可视化分析→优化调整”的科学分析思维,让数据分析更具严谨性与说服力。随着Python生态的不断完善,这些模块的功能也在不断优化,未来将进一步赋能各类数据分析场景,帮助研究者从数据中挖掘更多有价值的信息,为学术研究、业务决策提供可靠支撑。
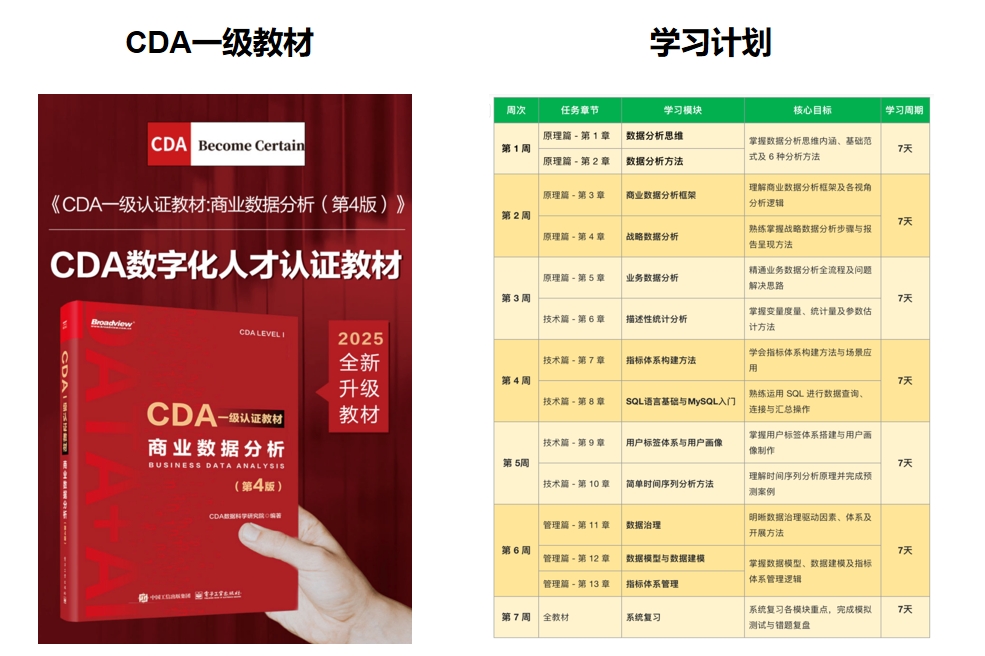
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330