很多数据分析师沉迷于复杂的机器学习算法,却忽略了数据分析最基础也最核心的能力——描述性统计。事实上,80%的商业分析问题,用描述性统计就能解决。
”
引言:为什么描述性统计是数据分析的“基本功”?
小张是一名刚入行的数据分析师,第一次拿到公司销售数据时,面对数万行密密麻麻的数字,他感到无从下手。客户满意度是上升还是下降?销售业绩的波动大不大?哪个客户群体贡献最高?
这些问题看似简单,但在数据面前,如果没有方法,就只是一堆数字。
描述性统计分析,正是解决这一困境的核心能力。描述性统计分析要对调查总体所有变量的有关数据做统计性描述,主要包括数据的频数分析、集中趋势分析、离散程度分析、分布形态描述以及一些基本的统计图形。它不涉及推断或预测,其核心目的是“用简洁的方式呈现数据的核心特征”,将杂乱的原始数据转化为可理解的信息,回答“数据是什么样的”这一基础问题。
一、描述性统计的三大核心维度:数据画像的“三棱镜”
描述性统计的核心是通过量化指标揭示数据“是什么”,而非“为什么”,其指标体系可分为三大维度:集中趋势、离散程度和分布形态。
(一)集中趋势——数据的“中心锚点”
集中趋势反映数据的平均水平,是分析师判断数据整体特征的首要工具。它回答了“数据的典型值是多少”这个问题。常用的集中趋势指标包括:
均值(Mean) ——所有数据的算术平均,适用于数据呈对称分布且无异常值的场景。例如,某电商平台日均订单量的均值为5000单,可作为基础运营目标的参考。在CDA考点提示中,均值对异常值敏感,若存在极端大值(如单日大促订单远超正常水平),需结合中位数修正结论。
中位数(Median) ——将数据排序后位于中间位置的数值,适用于偏态分布或含异常值的数据。例如,某公司员工薪资分布呈右偏(少数高管薪资极高),此时中位数比均值更能反映普通员工的薪资水平。
众数(Mode) ——数据中出现频率最高的数值,适用于分类数据或离散数据。例如,某快消品牌的产品规格中,某种规格的销量占比达60%,众数指标直接指导生产备货。
此外,分位数也是重要的描述工具。四分位数(Quartiles)通过Q1(25%分位数)、Q2(中位数,50%分位数)、Q3(75%分位数)将数据划分为四个等份,是描述数据分布形态和识别异常值的有效工具。
(二)离散程度——数据的“波动范围”
离散程度衡量数据的分散程度,反映各变量值远离其中心值的程度。它回答了“数据之间的差异有多大”这个问题。离散程度是“风险评估”“稳定性分析”的关键环节。
常用的离散程度指标包括:
极差——最大值与最小值的差值,是离散程度最简单的测度值,可快速判断数据跨度。例如,某产品的最高月销售额为100万元,最低为50万元,极差为50万元。极差的缺点是极易受极端值影响,且未考虑数据的分布情况。
平方差、方差与标准差——方差是先计算一组数据的平均数,再计算各数据与平均数之差的平方和,最后用所得平方和除以这组数据的个数,能反映一组数据与平均数的偏离程度。标准差是方差的平方根,是衡量离散程度最常用的测度值,反映了各变量值与均值的平均差异。例如,某连锁超市的日销售额标准差为2000元(均值5万元),说明销售额波动可控;若标准差达1万元,则需排查门店运营问题。
离散系数(变异系数) ——标准差与均值的比值,用于比较不同量纲数据的离散程度,消除单位影响。例如,比较员工薪资与年龄的离散程度时,离散系数能提供统一的比较标准。
四分位距(IQR) ——Q3与Q1的差值,IQR=Q3-Q1,可有效识别异常值(超出Q1-1.5IQR或Q3+1.5IQR的数值)。CDA实践案例:某金融平台通过四分位距筛选出“贷款金额超过Q3+1.5IQR”的客户,作为高风险群体重点审核。
平均差(Mean Deviation) ——各数据点与算术平均数之间差异绝对值的平均数,是另一种度量数据离散程度的重要指标。
(三)分布形态——数据的“形状密码”
分布形态是描述性统计分析中较为进阶的内容,它回答了“数据是如何分布的”这个问题。在统计研究中,常常需要利用偏度和峰度来判断数据分布是否符合正态分布假设。
偏态(Skewness) ——指数据分布偏斜的程度,即数据分布不对称的方向和程度。观察数据分布的偏态可通过数据分布图进行判断,看分布图的“尾巴”在哪里:
- 若偏态系数>0,数据呈右偏分布(正偏),此时均值>中位数>众数
- 若偏态系数<0,数据呈左偏分布(负偏),此时众数>中位数>均值
峰态(Kurtosis) ——指数据分布尖峭或平坦的程度,相对于标准正态分布而言:
- 峰度>0表示分布比正态分布更尖峭,数据更集中于均值附近
一组数据的分布形状可通过直方图将该数据分布在数轴上拟合出一条曲线,将曲线的尖峭程度和对称性与正态分布曲线相比较。
二、描述性统计的图表工具——让数据“可视化”
除了数值指标,描述性统计还离不开图表工具。
直方图——查看数值型数据的分布情况时是最优选择,能够显示数据在不同区间内的频率分布情况,直观反映出数据的集中趋势、离散程度以及是否存在偏态或异常值等信息。
箱型图——展示数据的五数概括和异常值,快速识别异常值,判断数据对称性。在业务描述性分析中,箱型图可以快速确认数据的分布以及数据的中位数、四分位数,是数据初探阶段非常实用的可视化工具。
折线图——展示数据随时间的变化趋势,是时间序列分析的核心图表。
饼图/柱状图——展示各类别占总体的比例(饼图)或比较不同类别的数值大小(柱状图)。
在实际分析中,建议先用描述性统计数值指标(均值、标准差、偏度等)快速了解数据的基本特征,再用图表(直方图、箱型图)直观呈现分布形态,两者结合才能全面把握数据的“画像”。
三、描述性统计与常用分布的关系
描述性统计与概率分布紧密相关。
正态分布——最常见、最重要的连续型概率分布,许多自然和社会现象都近似服从正态分布(如身高、考试成绩等)。正态分布的形态呈“钟形曲线”,对称分布在均值两侧,具有“中间高、两头低”的特点。在描述性统计中,通过计算样本的均值、标准差和偏度/峰度,可以判断数据是否近似服从正态分布。在正态分布中,均值、中位数、众数三者相等,都位于曲线的中心。
两点分布(伯努利分布) ——最简单的离散型概率分布,只有两种可能的结果(成功/失败、是/否),是二项分布的基础。
二项分布——n次独立的两点分布试验之和,描述在n次试验中成功次数k的概率分布。二项分布是描述性统计分析中理解“分类变量”分布形态的重要理论支撑。
在描述性统计分析中,还有两个重要的概念需要掌握。
数据标准化值——也称为Z分数,是将原始数据转化为以标准差为单位表示其与均值差异的量值。标准化值能够消除不同量纲对数据比较的影响,是进行跨指标比较的重要工具。
自由度——统计学中的基础概念,是指在计算统计量时能够自由取值的变量个数。在计算样本方差时,分母通常使用n-1,这体现了自由度在统计计算中的实际应用。
五、实战演练:从一份“用户行为数据”完成描述性统计分析
背景
某电商平台运营团队需要了解用户的行为特征,以便制定精准营销策略。他们收集了1000名用户的以下信息:
| 变量 |
变量类型 |
说明 |
| 用户ID |
分类变量 |
唯一标识,不用于统计 |
| 性别 |
分类变量 |
男/女 |
| 会员等级 |
顺序变量 |
普通/银卡/金卡/钻石 |
| 年龄 |
数值变量 |
岁 |
| 月均消费金额 |
数值变量 |
元 |
| 月均登录天数 |
数值变量 |
天 |
任务:通过描述性统计分析,回答以下问题:
完整分析流程
第一步:识别变量类型与数据准备
检查数据质量:年龄为负数或大于120岁需要处理。确认会员等级为顺序变量,有等级关系但差值不一定相等。
第二步:频数分析与分类变量描述
对会员等级等分类变量使用频数分析:
| 会员等级 |
频数 |
百分比 |
解读 |
| 普通 |
320 |
32% |
占比最高 |
| 银卡 |
280 |
28% |
|
| 金卡 |
250 |
25% |
|
| 钻石 |
150 |
15% |
占比最低 |
结论:普通会员占比最高,钻石会员占比最低——提示运营资源应向会员升级转化倾斜。
第三步:集中趋势分析——用户月均消费金额
| 指标 |
数值 |
业务解读 |
| 均值 |
1250元 |
平均每位用户月消费1250元 |
| 中位数 |
980元 |
50%的用户月消费低于980元 |
| 众数 |
500元 |
最常见的月消费金额为500元 |
发现:均值>中位数,数据呈右偏分布,说明存在少数高消费用户拉高了平均值。运营应重点关注“腰部用户”,而非被少数高消费用户的数据迷惑。
第四步:离散程度分析
- 变异系数=580/1250=0.464,说明数据分散度较高
- 四分位距(IQR)=Q3-Q1,若超过特定阈值可用于识别异常消费行为
第五步:分组对比分析
按性别分组对比月均消费:
| 性别 |
频数 |
均值 |
中位数 |
标准差 |
| 男 |
520 |
1320元 |
1100元 |
620元 |
| 女 |
480 |
1180元 |
950元 |
540元 |
结论:男性用户的平均消费略高于女性,但中位数差距更大,说明男性用户中的高消费群体更突出。
第六步:分布形态分析
- 绘制年龄分布的直方图,发现呈现左偏分布,年轻人(20-30岁)是主力用户群体
第七步:综合分析与业务建议
通过以上分析,可以得出以下业务建议:
- 消费能力方面:用户月均消费1250元,但中位数仅980元,存在高端消费群体拉高平均值,建议分层运营——对高消费用户提供VIP服务,对腰部用户设计升级激励。
- 会员体系方面:普通会员占32%,钻石会员仅15%,建议设计会员升级路径,引导普通会员向更高等级转化。
- 目标人群方面:用户年龄集中在20-30岁,男性消费略高于女性,营销内容应突出年轻化和个性化。
这就是一套完整的“变量识别 → 频数分析 → 集中趋势分析 → 离散程度分析 → 分组对比 → 分布形态分析”的描述性统计分析实战流程。
”
结尾:从“会用指标”到“用统计做分析”
很多数据分析师会算均值、标准差,但当被问到“均值和中位数分别适用什么场景”“如何判断数据的分布形态”“不同变量类型应该用哪些统计指标”时,却答不上来。
描述性统计是CDA数据分析师的“基本功”,其价值不在于复杂的计算,而在于从基础指标中挖掘业务痛点。通过掌握集中趋势、离散程度、分布形态的核心逻辑,结合图表等辅助工具,分析师可将零散数据转化为决策依据,为企业的精细化运营奠定基础。
如果你想系统掌握从原始数据到商业洞察的完整描述性统计方法论,并获得行业认可的专业能力证明,可以考虑了解CDA数据分析师认证。LEVEL Ⅰ考试完整覆盖了本文提到的所有知识点,通过系统的教材和官方模拟题训练,帮助你真正把“统计知识”变成“数据分析能力”。
???? 下一步行动:
- 用描述性统计方法(频数分析、集中趋势、离散程度、分布形态)快速了解数据的核心特征
数字是杂乱的,但掌握描述性统计的人能让它们说出真相。
”
图文含有广告内容
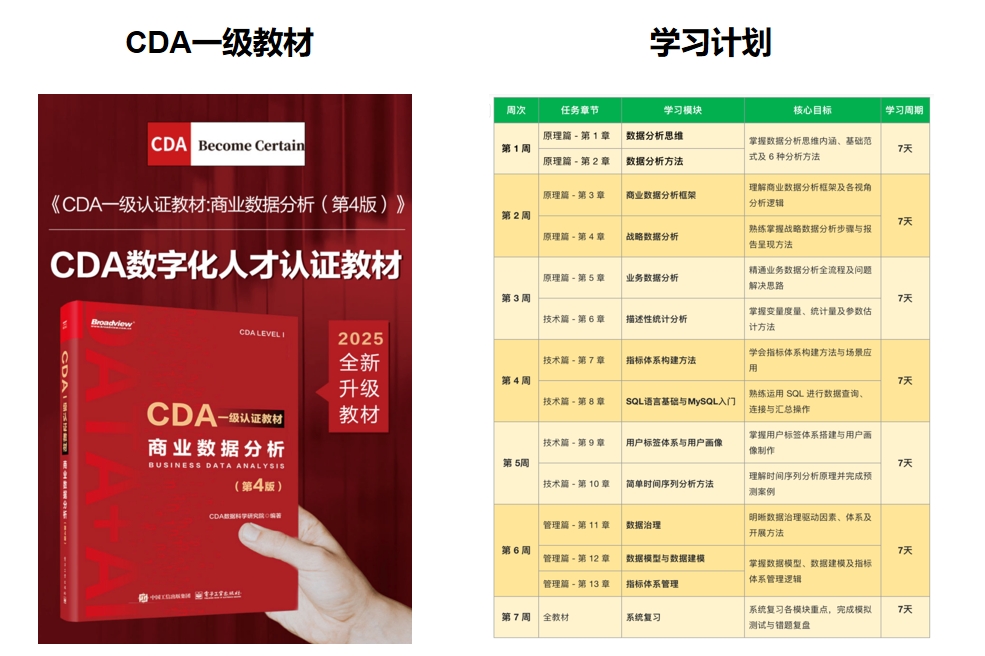
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330