CDA 备考干货:Python 在数据分析中的核心应用与实战技巧
在 CDA 数据分析师认证考试中,Python 作为数据处理与分析的核心工具,贯穿 LevelⅠ 到 LevelⅢ 的全级别考核内容。无论是基础的数据清洗、可视化,还是进阶的建模分析,Python 都以其高效的库支持和灵活的语法成为考生必须掌握的技能。本文将聚焦 CDA 考试重点,拆解 Python 的核心知识点、实战技巧及备考策略,助力考生快速突破技能瓶颈。
一、CDA 考试中的 Python 核心库与应用场景
Python 在数据分析中的优势,很大程度上源于其丰富的第三方库。CDA 考试对这些库的考察侧重 “实用性”,即能否用最少的代码解决实际问题。以下是高频考点库及对应场景:
- 数据处理基石:Pandas
Pandas 是 CDA LevelⅠ 的核心考点,也是所有数据分析工作的基础。考试重点包括:
数据结构操作:Series 与 DataFrame 的创建、索引切片(如loc/iloc的区别)、行列转换(stack/unstack)。
- 数据清洗:缺失值处理(dropna/fillna,尤其注意按业务逻辑填充的技巧)、重复值识别(duplicated)、数据类型转换(astype,如将字符串日期转为 datetime 格式)。
- 分组与聚合:groupby函数的多层分组、聚合函数(agg)的灵活使用(如同时计算均值、中位数和标准差)。
- 实战陷阱:考试常考 “链式操作的警告”(如df.dropna().groupby(...)可能导致的视图与副本问题),需掌握inplace=True的正确用法。
- 数值计算核心:NumPy
NumPy 为数据分析提供高效的数值计算支持,在 CDA 考试中多与 Pandas 结合考察:
- 数组操作:多维数组的创建(array/reshape)、广播机制(不同维度数组的运算规则)。
- 统计函数:均值(mean)、标准差(std)、分位数(percentile)的计算,这些是后续假设检验、建模的基础。
- 数据可视化工具:Matplotlib 与 Seaborn
CDA 考试对可视化的要求不仅是 “画图”,更强调 “通过图形传递数据结论”,LevelⅡ 尤其注重- 图表与业务场景的匹配:
- Matplotlib 基础:画布设置(figure/subplot)、坐标轴刻度调整(xticks/yticks)、图例与注释(legend/annotate),需掌握如何用plt.subplots()创建多子图并统一风格。
- Seaborn 进阶:分类数据可视化(countplot/boxplot)、相关性分析(heatmap,常与corr()函数结合)、时间序列趋势图(lineplot)。
- 考试加分项:能根据数据类型选择图表(如离散数据用柱状图、连续数据用直方图),并添加业务标签(如在折线图中标记 “政策实施时间点”)。
- 建模分析工具:Scikit-learn(LevelⅡ/Ⅲ 重点)
对于 LevelⅡ(如商业数据分析方向)和 LevelⅢ,Scikit-learn 是机器学习建模的核心库,考察聚焦 “流程化应用”:
- 数据预处理:特征标准化(StandardScaler)、归一化(MinMaxScaler)、类别变量编码(OneHotEncoder/LabelEncoder的区别)。
- 经典算法实现:线性回归(LinearRegression)、逻辑回归(LogisticRegression,注意参数C的正则化作用)、决策树(DecisionTreeClassifier),需掌握模型训练(fit)、预测(predict)及评估(accuracy_score/roc_auc_score)的完整流程。
- 考试易错点:混淆 “特征矩阵(X)” 与 “目标变量(y)” 的格式(X 需为二维数组,y 为一维数组)。
二、CDA 考试高频题型与 Python 实战技巧
CDA 考试中的 Python 题目多以 “场景化案例” 呈现,如 “用 Python 分析某电商用户购买数据,计算复购率并绘制趋势图”。掌握以下技巧可大幅提升解题效率:
代码简洁性:用一行代码解决常规问题
CDA 考试对代码效率有隐性要求,能用内置函数解决的问题,避免手动循环。例如:
计算每个用户的平均购买金额:
df.groupby('user_id')['amount'].mean()(替代手动遍历用户 ID 的循环)。
筛选出消费金额前 10% 的用户:
df[df['amount'] >= df['amount'].quantile(0.9)](利用quantile函数快速定位分位数)。
数据清洗技巧:批量处理异常值
考试中常出现 “包含异常值的数据集”(如年龄 = 200、销售额 =-100),需用 Python 快速识别并处理:
def remove_outliers(df, col):
q1 = df[col].quantile(0.25)
q3 = df[col].quantile(0.75)
iqr = q3 - q1
return df[(df[col] >= q1 - 1.5*iqr) & (df[col] <= q3 + 1.5*iqr)]
for col in df.select_dtypes(include=['int64', 'float64']).columns:
df = remove_outliers(df, col)
可视化高分技巧:突出业务洞察
CDA 考试的可视化题目不仅考察绘图能力,更看重 “能否通过图表说明业务问题”。例如:
在用户留存率折线图中,用plt.axvline(x=30, linestyle='--', color='red')标记 “新用户活动上线时间”,并添加注释说明活动对留存的影响。
绘制地区销售额柱状图时,用plt.text()在柱子上方标注具体数值,避免读者猜测数据大小。
建模题得分关键:流程完整性
LevelⅡ 的建模题需体现完整的分析逻辑,Python 代码应包含:
数据拆分(train_test_split划分训练集与测试集)。
模型训练与参数调优(如GridSearchCV进行交叉验证)。
结果评估与解释(用confusion_matrix或roc_curve可视化结果,而非仅输出分数)。
三、CDA Python 备考资源与效率提升建议
针对性学习资源
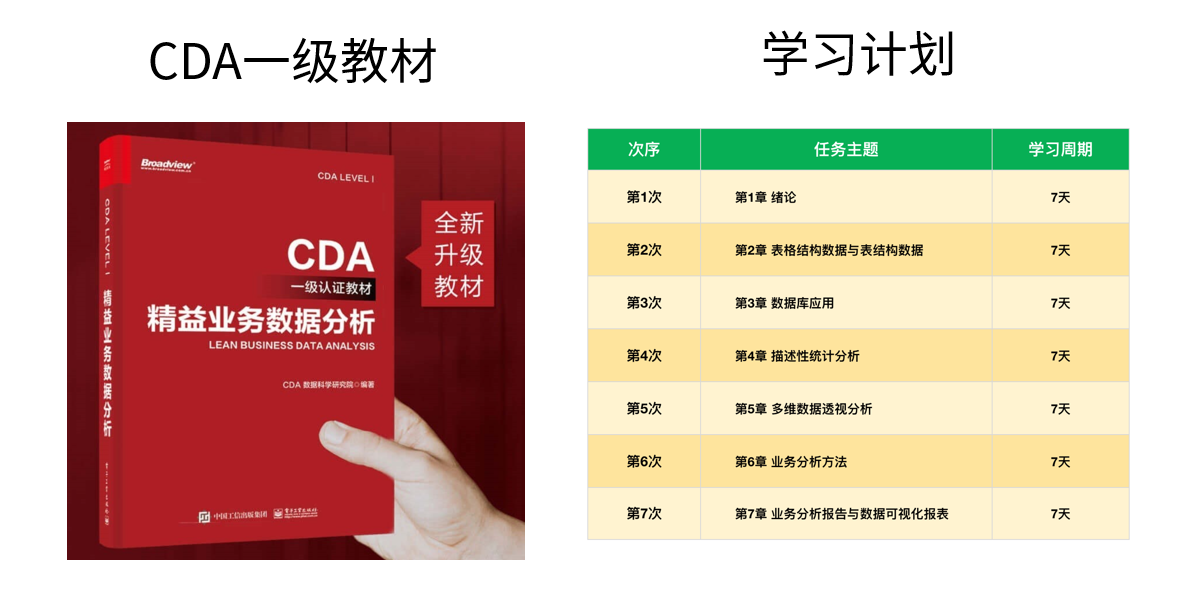
- 官方教材:《CDA教材一级:精益业务数据分析》侧重考点梳理,适合构建知识框架。
- 实战平台:Kaggle 的 “入门级数据集”(如 Titanic、Iris)可模拟 CDA 案例题场景,推荐每周完成 1 个完整分析项目。
- 工具手册:熟记 Pandas 官方文档中的 “常用方法速查表”(如df.transform与df.apply的区别),减少考试中对语法的纠结。
高效备考方法
模块化训练:按 “数据读取→清洗→分析→可视化→建模” 的流程拆分知识点,每天聚焦 1 个模块的 3-5 个函数(如 Day1 专攻pd.read_csv的参数设置:sep/na_values/parse_dates)。
错题复盘:建立 “代码错题本”,记录错误类型(如索引越界、数据类型不匹配)及对应解决方案,尤其注意 CDA 考试中易混淆的函数(如df.merge与df.join的区别)。
- 模拟实战:用 CDA 历年真题的数据集进行限时训练,要求 30 分钟内完成 LevelⅠ 的基础分析题,1 小时内完成 LevelⅡ 的建模案例题,提升时间把控能力。
结语:Python 是工具,思维是核心
CDA 考试对 Python 的考察,本质是检验 “用技术解决业务问题” 的能力。考生需避免陷入 “死记语法” 的误区,而是通过大量实战理解 “为什么用这个函数”“如何让代码更易读、更高效”。记住:在数据分析中,Python 是实现想法的工具,而清晰的逻辑与业务洞察,才是通过 CDA 考试并胜任实际工作的关键。按模块突破、聚焦实战、复盘总结,Python 技能将成为你 CDA 备考中的 “加分项” 而非 “拦路虎”。
题库入口:https://edu.cda.cn/goods/show/2845?targetId=4486&preview=0

 免费加入阅读:


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330