在CDA(Certified Data Analyst)数据分析师的核心能力体系中,“通过数据建立模型、实现预测与归因”是进阶关键——比如“预测下月销售额”“分析哪些因素对用户消费金额影响最大”“评估营销策略对销量的贡献度”。线性回归 作为最基础、最实用的预测与归因模型,能精准量化自变量与因变量的线性关系,将“数据关联 ”升级为“可解释、可预测”的业务洞察,是CDA连接数据与决策的核心工具。本文将从核心认知、标准化实操流程、工具选型、实战案例及避坑要点展开,助力CDA高效掌握线性回归 的实战应用,赋能业务决策。
一、核心认知:线性回归 的本质与CDA常用类型 线性回归 的本质是“建立因变量(业务目标变量)与一个或多个自变量(影响因素变量)之间的线性数学模型”,核心价值有二:一是预测 (通过自变量取值预测因变量未来值,如通过广告投放量预测销售额);二是归因 (量化各自变量对因变量的影响程度与方向,如“广告投放每增加1万元,销售额平均增加5万元”)。对CDA而言,无需深钻复杂数学推导,重点是理解模型逻辑、选对模型类型、读懂模型结果。
1. 一元线性回归 :单因素影响的精准量化 一元线性回归 适用于“单个自变量影响单个因变量”的场景,模型公式为:y = a + bx(y为因变量,x为自变量,a为截距,b为回归系数)。核心逻辑:量化x对y的线性影响——b的符号表示影响方向(正号为正向影响,负号为负向影响),b的绝对值表示影响强度(绝对值越大,影响越强)。
业务价值 :简化单因素分析,快速定位核心影响变量。例如,CDA通过一元线性回归 分析“广告投放量(x)与销售额(y)”,得到模型y=10+5x,解读为“无广告投放时基础销售额10万元,广告投放每增加1万元,销售额平均增加5万元”,可直接支撑广告投放策略的制定。
2. 多元线性回归 :多因素综合影响的系统分析 多元线性回归 适用于“多个自变量共同影响单个因变量”的复杂场景,模型公式为:y = a + b₁x₁ + b₂x₂ + ... + bₙxₙ(x₁、x₂...xₙ为多个自变量,b₁、b₂...bₙ为各自变量的回归系数)。核心逻辑:在控制其他自变量的前提下,量化单个自变量对因变量的“净影响”,解决多因素叠加的归因问题。
业务价值 :适配复杂业务场景,实现多因素综合决策。例如,分析“销售额(y)”受“广告投放量(x₁)、促销活动次数(x₂)、流量(x₃)”的影响,通过多元线性回归 得到各变量的回归系数,可明确“哪个因素对销售额影响最大”,指导资源优先分配。
实战提醒 :CDA选择线性回归 类型的核心原则——先明确“影响因变量的因素数量”:单因素用一元线性回归 ,多因素用多元线性回归 ;核心前提是数据需满足“线性关系、独立性、正态分布 、同方差 性、无多重共线性”,任一前提不满足都会导致模型失真,需提前验证并处理。
二、CDA标准化实操流程:从业务问题到模型落地 线性回归 的实操需遵循“业务问题转化—数据准备—前提验证—模型构建—模型评估 —业务落地”的标准化流程,CDA需全程紧扣业务目标,避免“为建模而建模”,确保模型结果可解释、可落地。
1. 第一步:业务问题转化——明确变量与建模目标 核心是将模糊的业务问题转化为“线性回归 可解决的量化目标”,CDA需完成两项核心工作:①界定变量类型:明确“因变量(y)”(即业务目标变量,如销售额、消费金额、用户留存率,需为连续数值型)和“自变量(x)”(即影响因素,如广告投放量、活动次数、用户年龄,可为数值型或编码后的分类型);②明确建模目标:是“预测”(如预测下月销售额)还是“归因”(如分析哪些因素影响消费金额),为后续模型构建与评估提供方向。
案例 :业务问题“如何通过优化运营动作提升商品销售额”,转化为建模目标:以“销售额(y,连续数值型)”为因变量,“广告投放量(x₁)、促销次数(x₂)、线上流量(x₃)”为自变量,构建多元线性回归 模型,量化各运营动作对销售额的影响(归因),并预测不同运营组合下的销售额(预测)。
2. 第二步:数据准备——确保数据质量 与适配性 数据质量 是模型可靠的基础,CDA需重点完成四项工作:①数据筛选 :提取因变量与自变量的相关数据,剔除变量缺失、逻辑矛盾的数据(如销售额为负、广告投放量为0但有流量);②异常值 处理:线性回归 对异常值 极敏感,通过箱线图 、3σ原则识别异常值 ,采用“删除(错误数据 )”“缩尾/截尾处理(真实极值)”或“对数转换(偏态数据 )”;③变量编码:若自变量为分类型(如“促销类型:满减/优惠券/赠品”),需进行编码(如哑变量编码,将1个分类型变量转化为n-1个数值型变量);④变量筛选:通过相关性分析、业务逻辑剔除“无意义自变量”(如与因变量相关性接近0的变量),避免冗余变量增加模型复杂度。
3. 第三步:前提条件验证——确保线性回归 适用 线性回归 的有效性依赖五大前提,CDA需逐一验证,不满足时需针对性处理:
线性关系 :自变量与因变量存在线性关联,验证方法:绘制散点图 (一元)或部分依赖图(多元),直观观察趋势;若为非线性,可对变量进行平方、对数转换,或更换非线性模型;
独立性 :观测值之间相互独立(无自相关),验证方法:多元场景下通过Durbin-Watson检验(数值接近2则无自相关);若存在自相关,需重新筛选数据(如避免连续时间序列的重叠观测);
正态分布 正态分布 ,验证方法:绘制残差Q-Q图(数据点贴近对角线)或Shapiro-Wilk检验(p值>0.05);若不满足,可对因变量进行转换或增加样本量;
同方差 性 :残差的方差 在所有自变量取值范围内一致,验证方法:绘制残差-预测值散点图 (无明显趋势则符合)或Breusch-Pagan检验(p值>0.05);若不满足,可采用加权线性回归 ;
无多重共线性 :多元回归中自变量之间无强线性关联,验证方法:计算方差 膨胀因子(VIF),VIF<5为无多重共线性,5≤VIF≤10为中等共线性,VIF>10为强共线性;若存在,需剔除冗余变量或进行主成分分析。
4. 第四步:模型构建与参数解读 通过工具完成模型构建,核心关注“回归系数”“显著性(p值)”,解读逻辑如下:
回归系数(b) :表示“在其他变量不变的情况下,该自变量每变化1个单位,因变量平均变化b个单位”。例如,多元模型中x₁(广告投放量)的系数=4.5,解读为“在促销次数、流量不变时,广告投放每增加1万元,销售额平均增加4.5万元”;
显著性(p值) :判断自变量对因变量的影响是否“统计显著”(非偶然),常用α=0.05,若p值<0.05,说明该自变量的影响显著;若p值≥0.05,说明当前样本数据不足以证明该自变量有影响,需剔除;
截距(a) :表示“所有自变量为0时,因变量的基准值”,需结合业务场景解读(如无广告、无促销、无流量时的基础销售额),若业务中无此场景,可仅作为模型参数,无需过度解读。
5. 第五步:模型评估 ——判断模型拟合效果 核心是评估模型对数据的解释能力与预测准确性,CDA需关注核心评估指标,避免“模型拟合优但无业务价值”:
R²(决定系数) :表示“因变量的变异中可被自变量解释的比例”,取值范围[0,1],越接近1说明模型拟合效果越好。例如,R²=0.85,说明“销售额85%的变异可由广告投放、促销次数、流量解释”;
调整R² :修正了“自变量数量”对R²的影响(多元回归中自变量越多R²越容易偏高),更适合多元模型评估 ,需重点关注;
RMSE(均方根误差 ) :表示“模型预测值与实际值的平均偏差 ”,单位与因变量一致,数值越小说明预测越准确。例如,RMSE=2.3万元,说明“模型预测销售额的平均偏差 为2.3万元”;
残差分析 :通过残差的分布、趋势验证模型前提是否满足(如残差是否正态、无趋势),若残差存在明显规律(如递增/递减),说明模型仍有优化空间。
6. 第六步:业务落地——预测与归因指导决策 CDA需将模型结果转化为具体的业务行动,避免“模型与业务脱节”:
归因指导策略优化 :根据回归系数大小与显著性,优先优化“影响大且显著”的自变量。例如,模型显示“广告投放系数=4.5(p<0.05),促销次数系数=1.2(p<0.05)”,建议“优先增加广告投放,其次适度增加促销次数”;
预测支撑计划制定 :代入不同自变量取值,预测因变量结果,辅助资源分配与目标制定。例如,预测“广告投放10万元、促销3次、流量5万”时销售额=120万元,可将此作为下月销售目标;
持续迭代优化 :定期用新数据更新模型,重新评估参数与拟合效果,适应业务变化(如市场环境、用户偏好变化)。
三、CDA常用工具选型:高效构建线性回归 模型 不同数据量级、业务场景对应不同工具,CDA需灵活选型,平衡效率与准确性,以下是常用工具的适配场景与实操技巧:
1. 轻量级工具:Excel/WPS
核心优势 :操作简单、易上手,无需编程基础;通过“数据分析”插件可直接构建一元/多元线性回归 模型,输出回归系数、p值、R²等核心指标;直接对接Excel表格数据,适合小批量数据的快速验证;
实操步骤 :①数据整理:将因变量、自变量按列排列;②构建模型:通过“数据—数据分析—回归”,将因变量移入“Y值输入区域”,自变量移入“X值输入区域”,勾选“标志”“置信区间”“残差图”,点击确定输出结果;③结果解读:重点查看“Coefficients(系数)”“P-value(p值)”“R Square(R²)”;
适配场景 :小批量数据(万级以下)、一元线性回归 、日常业务快速验证(如月度广告投放与销量的回归分析 )。
2. 中大规模工具:Python(Scikit-learn/Statsmodels)
核心优势 :支持大规模数据(万级—百万级)的高效处理;可通过Scikit-learn快速构建模型、评估预测效果,通过Statsmodels输出详细的统计指标(如p值、VIF、残差分析);支持数据预处理 、特征 工程与可视化,实现“数据清洗 —建模—评估—预测”全流程自动化;
实操步骤 :①数据预处理 :用Pandas处理缺失值 、异常值 ,用OneHotEncoder进行哑变量编码;②前提验证:用statsmodels计算VIF验证多重共线性,绘制残差图验证正态性与同方差 性;③模型构建:用sklearn.linear_model.LinearRegression构建模型,或用statsmodels.api.OLS构建模型(输出更详细统计信息);④模型评估 :用sklearn.metrics计算R²、RMSE,用statsmodels查看系数显著性;⑤预测:用model.predict()代入自变量取值完成预测;
3. 专业级工具:SPSS
核心优势 :图形化操作界面,无需编程;支持自动完成数据预处理 、模型构建、前提验证与结果输出,统计指标全面(含系数、p值、R²、残差分析、VIF);具备完善的可视化功能,可快速生成散点图 、残差图、预测图;
实操步骤 :①导入数据:将清洗后的变量数据导入SPSS;②构建模型:通过“分析—回归—线性”,将因变量移入“因变量”框,自变量移入“自变量”框;点击“统计量”,勾选“估计值”“模型拟合度”“共线性诊断”“残差”;点击“图”,设置残差图;点击确定,生成完整分析报告;③模型优化 :若存在多重共线性或不显著变量,通过“逐步回归”(在“方法”中选择“逐步”)自动筛选最优自变量组合;
适配场景 :专业级统计分析 、需要详细报告的场景(如企业深度业务研究、学术分析)、非编程背景CDA的高效建模需求、多元线性回归 的复杂前提验证。
四、实战案例:CDA用线性回归 优化电商销售额预测与运营策略 以“电商平台商品销售额的预测与运营因素归因”为例,拆解CDA的全流程实操:
1. 业务背景与建模目标 电商平台需制定下月销售计划,同时明确哪些运营动作对销售额影响最大,以便优化资源分配。建模目标:以“销售额(y,万元)”为因变量,“广告投放量(x₁,万元)、促销次数(x₂)、线上流量(x₃,万次)、用户复购率(x₄,%)”为自变量,构建多元线性回归 模型,实现“归因分析(明确各运营动作影响)”与“销售额预测(支撑下月计划)”。
2. 数据准备 提取平台2025年1-12月的月度数据,筛选核心变量;数据清洗 :①剔除1个月的缺失数据;②对“销售额”进行缩尾处理(剔除1%极值);③验证变量类型:均为连续数值型,无需编码;最终得到有效样本11条。
3. 前提条件验证
线性关系:散点图 显示各自变量与销售额均存在线性趋势;
独立性:Durbin-Watson检验值=1.85,接近2,无自相关;
正态分布 :残差Q-Q图数据点贴近对角线,Shapiro-Wilk检验p值=0.32>0.05,符合正态分布 ;
同方差 性:残差-预测值散点图 无明显趋势,Breusch-Pagan检验p值=0.28>0.05,符合同方差 性;
4. 模型构建与参数解读 用Python的Statsmodels构建模型,结果如下:
变量
回归系数
p值
显著性
截距(a)
8.5
0.02
显著
广告投放量(x₁)
4.2
0.001
显著
促销次数(x₂)
1.5
0.03
显著
线上流量(x₃)
2.8
0.005
显著
用户复购率(x₄)
0.6
0.35
不显著
解读:剔除不显著的“用户复购率(x₄)”后,最终模型为y=8.5+4.2x₁+1.5x₂+2.8x₃;在其他变量不变时,广告投放每增加1万元,销售额平均增加4.2万元;流量每增加1万次,销售额平均增加2.8万元;促销次数每增加1次,销售额平均增加1.5万元。
模型调整R²=0.88,说明“销售额88%的变异可由广告投放、促销次数、流量解释”;RMSE=1.2万元,说明“模型预测销售额的平均偏差 为1.2万元”,拟合效果与预测准确性均较好。
6. 业务落地建议
归因指导资源分配:广告投放对销售额影响最大,优先增加广告投放预算;其次提升线上流量(如优化SEO、投放精准渠道);适度增加促销次数(避免过度促销导致利润下降);
预测支撑销售计划:下月计划广告投放12万元、促销4次、流量8万次,代入模型预测销售额=8.5+4.2×12+1.5×4+2.8×8=8.5+50.4+6+22.4=87.3万元,将此作为下月销售目标;
持续优化:下月结束后,用实际数据更新模型,重新评估参数,验证策略效果。
五、CDA避坑指南:线性回归 的常见误区 线性回归 虽基础,但CDA在实操中易因细节疏忽导致模型失真或业务误判,需重点规避以下五大误区:
1. 误区1:混淆“相关”与“因果”,过度解读系数 表现:将“回归系数显著”解读为“自变量导致因变量变化”,如“模型显示‘冰淇淋销量’与‘溺水人数’系数显著正相关”,就认为“吃冰淇淋导致溺水”。规避:明确线性回归 仅能证明“线性关联”,无法证明因果;若需验证因果,需设计对照实验(如A/B测试),或结合业务逻辑排除中介变量。
2. 误区2:忽视前提验证,强行建模 表现:未验证线性关系、多重共线性等前提,直接构建模型,导致系数失真。例如,自变量与因变量为非线性关系,仍用线性回归 ,得到的系数无业务意义。规避:严格按流程验证前提,不满足时通过变量转换、剔除变量等方式处理,无法处理则更换模型(如非线性回归 、树模型)。
3. 误区3:盲目追求高R²,忽视业务价值 表现:认为R²越高模型越好,为提升R²加入大量冗余自变量(如加入与业务无关的变量)。例如,R²=0.95,但模型中包含“用户ID”这类无业务意义的变量,无法指导决策。规避:模型评估 需结合“业务意义”与“统计指标”,优先选择“变量少、解释性强、R²适中”的模型。
4. 误区4:多元回归中忽视多重共线性 表现:多元模型中自变量间存在强共线性(如“广告投放量”与“推广费用”高度相关),导致系数符号异常或显著性失真。例如,真实广告投放对销售额为正向影响,但因多重共线性,系数变为负。规避:建模前必算VIF值,剔除高共线性变量,或通过主成分分析降维 。
5. 误区5:超出自变量取值范围预测 表现:预测时自变量取值超出建模数据的范围,导致预测结果不可靠(线性关系仅在建模数据范围内成立)。例如,建模时广告投放量范围为1-10万元,却预测广告投放20万元时的销售额。规避:预测时自变量取值需在建模数据的合理范围内,超出范围需补充数据重新建模。
六、结语:线性回归 是CDA实现预测与归因的核心基础 对CDA数据分析师而言,线性回归 绝非简单的“数学模型”,而是连接数据与业务决策的“核心桥梁”——它既能通过归因分析明确“哪些因素影响业务目标”,又能通过预测为计划制定提供数据支撑,是CDA从“描述数据”向“驱动决策”进阶的必备技能。
CDA掌握线性回归 的核心是“业务导向+严谨流程+理性解读”:既要紧扣业务目标选择变量、构建模型,避免“为建模而建模”;也要严格遵循前提验证、模型评估 的标准化流程,确保结果可靠;更要理性解读系数与统计指标,结合业务逻辑转化为可执行的策略。唯有如此,才能让线性回归 真正服务于业务价值提升,成为数据驱动决策的有力工具。
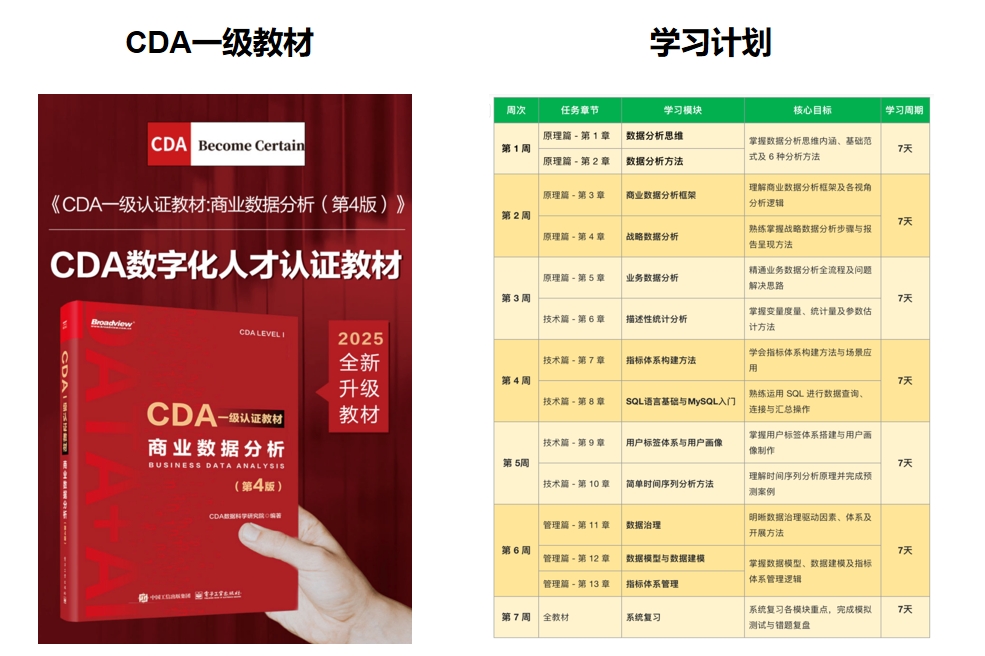
推荐学习书籍 《CDA一级教材 》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ ! 


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330