随机森林模型与 OPLS-DA 的优缺点深度剖析
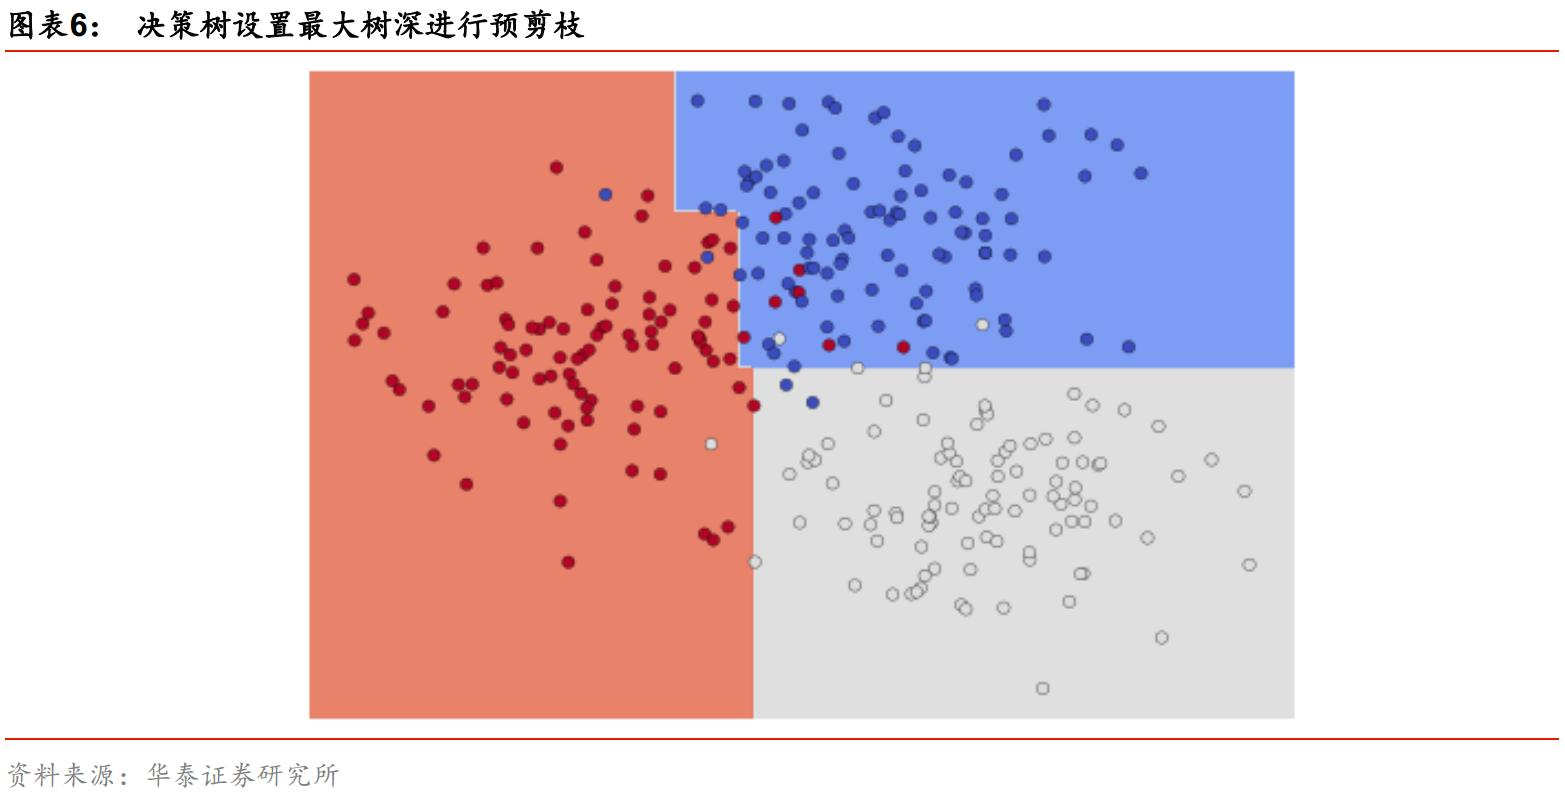
在数据分析与机器学习领域,随机森林模型与 OPLS-DA(正交偏最小二乘法判别分析)都是备受关注的工具。它们凭借独特的算法原理与分析逻辑,在不同场景下发挥着重要作用。深入了解二者的优缺点,有助于数据分析师和研究人员根据实际需求选择合适的模型,实现更精准的数据分析与决策。
(一)算法原理
随机森林是一种基于决策树的集成学习算法,通过构建多个决策树并将它们的预测结果进行组合(分类任务通常采用投票法,回归任务则使用平均法),以提升模型的预测性能和泛化能力。在构建每棵决策树时,它会从原始数据集中随机有放回地抽取样本(自助采样),同时在每个节点分裂时,随机选取部分特征进行最优分裂,这种双重随机性减少了模型的方差,有效避免过拟合问题。
(二)优点
强大的预测能力:随机森林能够处理复杂的非线性关系,在分类和回归任务中都有出色表现。例如在客户信用风险评估中,通过分析客户多维度的信息,如年龄、收入、信用历史等,随机森林可以准确预测客户的违约概率,为金融机构提供风险预警。
鲁棒性强:对噪声数据和异常值具有较好的容忍度。在实际的医疗数据分析中,由于数据采集过程可能存在误差,部分数据存在噪声,但随机森林模型依然能从大量的患者症状、检查指标等数据中挖掘出有效信息,辅助疾病诊断。
无需数据标准化:不像一些其他机器学习算法(如神经网络)对数据的标准化有严格要求,随机森林可以直接处理原始数据,减少了数据预处理的工作量,提高了数据分析效率。
特征重要性评估:可以方便地评估各个特征对模型预测结果的重要性,帮助数据分析师筛选关键特征,理解数据背后的关系。在电商销售数据分析中,通过随机森林的特征重要性分析,能够明确哪些因素(如商品价格、促销活动、季节因素等)对销售额的影响更大。
(三)缺点
模型解释性有限:虽然可以评估特征重要性,但对于单条数据的预测过程难以给出直观、详细的解释,不像线性回归模型那样可以通过系数清晰地说明变量间的关系。在法律合规性审查等对解释性要求极高的场景中,随机森林的应用会受到一定限制。
计算资源消耗大:当数据集规模庞大、特征数量众多时,构建大量决策树会占用较多的内存和计算时间,训练过程可能会比较缓慢,对硬件设备要求较高。
二、OPLS-DA
(一)算法原理
OPLS-DA 是一种基于偏最小二乘法(PLS)的监督式模式识别方法,它在 PLS 的基础上引入了正交信号校正的概念,将数据的变异分解为与响应变量相关的预测成分和与响应变量无关的正交成分。通过这种方式,OPLS-DA 能够更清晰地揭示样本之间的差异和类别间的关系,常用于组间差异分析和分类预测,在代谢组学、蛋白质组学等生物医学领域应用广泛。
(二)优点
强大的组间差异分析能力:OPLS-DA 可以有效提取数据中与分类相关的信息,突出不同组样本之间的差异,帮助研究人员快速找到导致组间差异的关键变量。在药物疗效研究中,通过分析患者服药前后的代谢物数据,OPLS-DA 能够精准识别出因药物作用而发生显著变化的代谢物,为药物机制研究提供重要线索。
数据降维和信息提取:通过将数据投影到低维空间,OPLS-DA 在保留关键信息的同时,降低了数据的复杂性,减少了数据中的噪声干扰,使数据分析更加高效和准确。
良好的可视化效果:可以将分析结果以得分图、载荷图等形式直观呈现,便于研究人员观察样本的分布情况和变量的重要性,快速理解数据结构和组间关系。例如在食品品质分类研究中,通过 OPLS-DA 得分图可以清晰地看到不同品质等级食品样本的聚类情况。
(三)缺点
对数据要求较高:要求数据满足正态分布和等方差性等假设条件,如果数据不满足这些条件,可能会影响分析结果的准确性,因此在使用前通常需要对数据进行预处理和转换。
过度拟合风险:由于 OPLS-DA 是一种监督式方法,在样本量较小、变量较多的情况下,容易出现过度拟合现象,导致模型的泛化能力下降,在新数据上的预测效果不佳。
适用场景相对局限:主要适用于组间差异分析和分类任务,对于回归分析等其他类型的数据分析任务,其应用相对较少,相比随机森林模型,适用范围不够广泛。
随机森林模型与 OPLS-DA 在数据分析领域各有千秋。随机森林凭借其强大的预测能力和鲁棒性,适用于多种复杂场景;OPLS-DA 则在组间差异分析和可视化方面表现突出。在实际应用中,数据分析师和研究人员需要根据具体的研究目的、数据特点和需求,综合考虑二者的优缺点,选择最合适的模型,以实现更高效、准确的数据分析与决策。

 免费加入阅读:


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330