在数据分析与数据预处理工作中,原始数据普遍存在录入错误、系统故障、偶然极值等问题,极易产生异常数据。异常数据会严重干扰数据均值、相关性、拟合模型的准确性,导致统计分析失真、建模效果偏差、业务判断失误。因此,异常值识别与剔除是数据清洗的核心环节。基于**标准差(σ)**判别异常值是目前最通用、最科学的量化清洗方法,其中以3σ原则为核心标准,凭借客观的统计学理论、简单高效的运算逻辑,广泛应用于各行各业的数据净化工作。本文系统阐述标准差判别异常值的核心原理、判定标准、完整清洗流程、实战案例与应用优劣。
一、标准差的核心统计含义
标准差是描述数据集离散波动程度的核心统计指标,用符号σ表示。均值反映数据的整体集中水平,而标准差能够精准体现数据的分散状态:标准差越小,代表数据越集中、波动越小、稳定性越强;标准差越大,代表数据越分散、波动剧烈、离散程度越高。
在正态分布数据体系中,数据的分布具备极强的概率规律性,绝大多数有效数据都会集中分布在均值附近,只有极少数数据会偏离正常区间,成为异常极值。基于这一特性,结合标准差可以划定数据的合理波动范围,精准区分正常数据与异常数据。
基于标准差剔除异常数据的核心理论依托于正态分布概率规律,也就是经典的3σ准则。对于服从正态或近似正态分布的数据集,数据分布概率存在固定规律:数值落在均值±1σ区间的概率为68.27%,落在均值±2σ区间的概率为95.45%,落在均值±3σ区间的概率高达99.73%。
这意味着,仅有**0.27%**的数据会落在均值±3σ区间之外,属于极小概率事件。在统计学数据分析中,极小概率事件在常规业务场景下几乎不会发生,因此判定该部分超出区间的数据为异常值,可进行剔除、修正或标记处理。
核心判定公式:合理数据区间 = [μ-3σ,μ+3σ],其中μ为数据集均值,σ为数据集标准差。小于μ-3σ的数值为低位异常值,大于μ+3σ的数值为高位异常值。
依托标准差开展异常数据清洗,需遵循标准化流程,避免盲目删数导致样本流失、数据失真,实现科学、精准的数据净化。
首先对原始数据进行基础清洗,剔除空值、重复值、乱码等无效数据,保证数据集完整性。同时检验数据分布形态,标准差判别的核心前提是数据服从正态或近似正态分布,偏态、长尾分布数据不适合直接使用该方法,否则会出现大量误判。
第二步:计算核心统计指标
基于清洗后的有效数据集,计算整体均值μ与总体标准差σ,通过公式核算出数据合理波动的上下限阈值,锁定正常数据的可信区间。
第三步:批量识别与标记异常值
遍历全部数据,将单条数据与3σ阈值区间进行比对,对超出区间的数值统一标记为异常数据,区分高位极值异常和低位过低异常,完成异常数据的精准定位。
第四步:结合业务差异化处理
标记异常值后不直接批量删除,需结合业务场景归因分析。对于系统错误、录入失误产生的无效异常数据,直接剔除或修正;对于真实业务场景产生的特殊极值数据,予以保留并单独备注,避免丢失核心业务信息。
第五步:二次校验确认
异常值本身会干扰均值和标准差的计算结果,初次清洗后需重新统计指标、校验数据分布,确保无残留异常数据,最终得到高质量的纯净数据集。
四、实战应用案例
以某门店30天日营业额数据为例,运用标准差3σ原则完成异常数据清洗。经检验,门店日营业额数据近似服从正态分布,计算得出日均营业额μ=9000元,标准差σ=1500元。
计算可信区间:下限=9000-3×1500=4500元,上限=9000+3×1500=13500元。正常营业额应处于4500元至13500元之间。
遍历原始数据发现,单日营业额出现2200元、15800元两组数据,均超出合理区间,被标记为异常值。经业务复盘,2200元为系统统计错误,属于无效脏数据,予以剔除;15800元为节假日促销带来的真实高额营收,属于有效特殊数据,予以保留并单独标注。
经过标准化清洗后,数据集彻底消除错误数据干扰,能够真实反映门店日常经营的营收波动规律。
五、标准差清洗异常数据的优势与局限性
(一)核心优势
一是客观量化,基于统计学概率规律判定异常值,规避人工经验判断的主观性误差,判定标准统一、结果可复刻;二是简单高效,计算逻辑简单、适配自动化处理,适合大批量数据集批量清洗;三是精准度高,针对正态分布数据,能够有效区分正常波动与极端异常,最大程度保留有效数据;四是通用性强,适配销量、成绩、营收、工时、设备参数等绝大多数常规连续型数据场景。
(二)局限性
该方法对数据分布有严格要求,仅适配正态、近似正态分布数据,对偏态、长尾数据误判率极高;对小样本数据集不友好,小样本统计的均值与标准差稳定性差,判定结果参考价值低;无法自主区分异常成因,不能辨别极值是数据错误还是真实业务数据,必须结合业务二次校验。
六、应用常见误区与避坑要点
第一,无视数据分布盲目套用,在消费、收入等长尾偏态数据中使用3σ原则,会误将正常极值判定为异常,造成有效数据流失;第二,标记异常值后直接批量删除,忽略真实业务极值数据,导致数据特征失真、分析结论偏差;第三,小样本数据强行使用,统计指标偏差过大,清洗结果不具备统计学意义;第四,一次清洗完成后不做二次校验,残留异常数据持续干扰数据质量。
七、总结
基于标准差的异常数据清洗方法,是依托正态分布概率规律形成的科学化、标准化数据预处理工具。通过均值与三倍标准差划定数据可信区间,能够快速、精准识别偏离正常波动范围的异常数据,有效剔除录入错误、系统故障等带来的脏数据,净化数据集、提升数据质量。
在实战应用中,需严格遵循数据分布检验、指标计算、异常标记、业务归因、二次校验的完整流程,规避误用场景与盲目删数误区。合理运用标准差清洗异常数据,能够从源头保障数据的真实性与稳定性,为后续的统计分析、模型训练、业务决策提供可靠的数据支撑,是数据分析从业者必须掌握的基础核心技能。
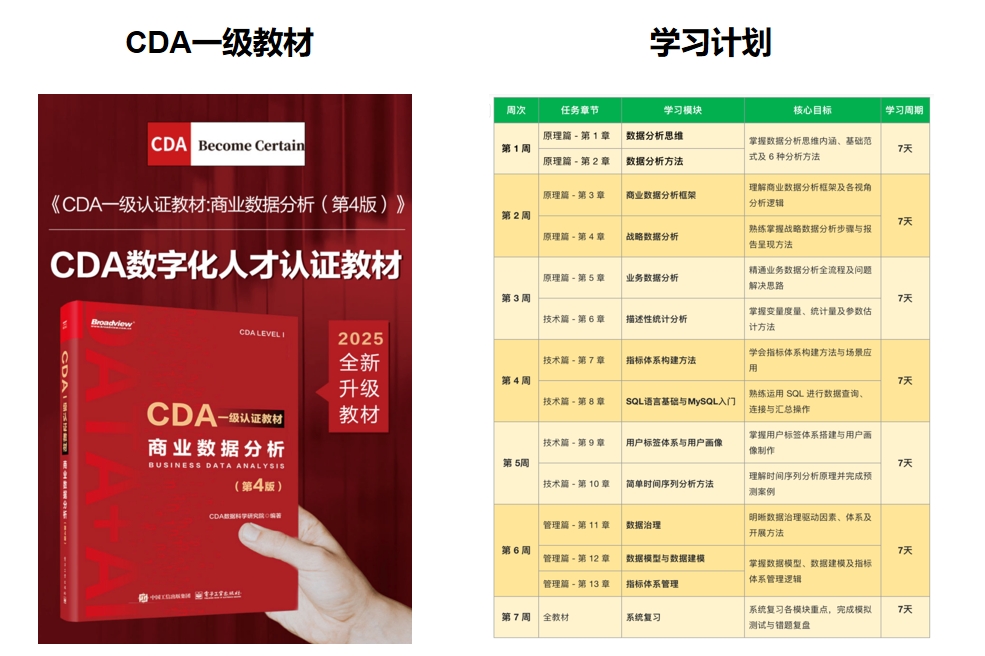
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330