在数据分析工作中,时间序列是最常见的数据类型之一,订单时间、日志时间、交易时段、统计周期等数据均离不开时间处理。原始数据中的时间大多以字符串、数字时间戳、不规则文本等格式存储,无法直接完成时间筛选、周期统计、序列对齐、缺失补全等操作。Pandas作为Python核心数据分析库,提供了两套最核心的时间处理工具:pd.to_datetime时间格式转换与pd.date_range时间序列生成。二者分工明确、配合紧密,是时序数据清洗、时间索引构建、周期数据分析的基础核心技能。本文将系统讲解两个函数的核心原理、标准用法、代码实操、区别联动与业务场景。
一、Pandas时间处理的核心价值
原始文本格式的时间不具备时间运算能力,无法实现按日/按月分组、时间差值计算、周期筛选、缺失日期填充等分析操作。Pandas通过专属时间类型标准化时间数据,将杂乱的文本时间转为结构化Datetime时间类型,同时可批量生成规整的固定频率时间序列,实现两大核心能力:一是时间数据标准化清洗,统一五花八门的时间格式;二是时序索引结构化构建,生成连续、等频、规整的时间轴,为时间序列分析、数据对齐、缺失值修复提供支撑。
二、pd.to_datetime:时间格式标准化转换
(一)核心功能与原理
pd.to_datetime() 的核心作用是将非结构化时间转为标准Datetime类型,支持字符串、数字时间戳、列表、Series、多维时间文本等多种格式的批量转换。无论原始时间是“2025/01/02”“2025-01-02”“2025年01月02日”还是时间戳数字,均可统一转为Pandas可识别的标准时间格式,解决原始时间格式混乱、无法运算的问题。
(二)常用语法与核心参数
基础语法:pd.to_datetime(arg, errors='raise', format=None)
核心参数说明:arg为待转换的时间数据;errors控制报错方式,设置为coerce可将错误时间转为空值,避免程序中断;format可手动指定时间格式,提升转换精度与速度。
(三)实战代码演示
import pandas as pd
time_str = "2025/05/20 14:30:00"
res1 = pd.to_datetime(time_str)
print("标准时间格式:", res1)
df = pd.DataFrame({"order_time":["2025-01-01","2025/01/02","2025年01月03日"]})
df["std_time"] = pd.to_datetime(df["order_time"])
print("n转换后时间列:")
print(df)
error_data = ["2025-01-01", "无效时间", "2025-01-03"]
res3 = pd.to_datetime(error_data, errors="coerce")
print("n容错转换结果:", res3)
(四)核心应用场景
主要用于数据清洗阶段的时间标准化:统一数据表时间列格式、修复杂乱时间文本、转换时间戳数据、规整日志与订单时间,为后续时间筛选、分组统计、时间差计算奠定数据基础。
三、pd.date_range:规整时间序列生成
(一)核心功能与原理
pd.date_range() 是Pandas专属的时间序列生成函数,核心作用是生成固定频率、等间距、连续规整的DatetimeIndex时间索引。不同于格式转换,该函数用于从零构建时间轴,支持按天、小时、月、季度、年等任意频率生成连续时间,完美解决业务数据时间缺失、时间间断、时序不连续的问题,是时间序列补全、时序建模的核心工具。
(二)核心参数与匹配规则
基础语法:pd.date_range(start, end, periods, freq)
四大核心参数遵循三缺一规则:start、end、periods、freq四个参数,固定填写三个即可自动推算第四个。start为起始时间,end为结束时间,periods为生成时间点总数,freq为时间频率(D天、H小时、M月、Y年)。
(三)高频用法与代码实操
import pandas as pd
time1 = pd.date_range(start="2025-01-01", end="2025-01-10", freq="D")
print("按天连续时间序列:n", time1)
time2 = pd.date_range(start="2025-01-01", periods=6, freq="H")
print("n每小时时间序列:n", time2)
time3 = pd.date_range(start="2025-01-01", periods=12, freq="M")
print("n月度时间序列:n", time3)
(四)核心应用场景
主要用于时序数据构建与补全:生成连续业务统计周期、修复间断时间数据、构建时间索引、补齐节假日/断更缺失数据、制作规整的时间维度报表、时间序列建模数据集构建。
四、pd.to_datetime与pd.date_range的区别与联动关系
1. 核心功能本质区别
pd.to_datetime属于数据清洗工具,面向已有杂乱时间数据,核心是格式标准化、统一类型、纠错容错;pd.date_range属于数据构建工具,面向无时间数据或时间不连续场景,核心是从零生成规整、连续、等频的时间序列。
2. 数据流向与联动逻辑
真实业务分析中二者通常搭配使用,形成完整时序处理闭环:首先通过pd.to_datetime将原始杂乱时间列标准化,完成基础清洗;再通过pd.date_range生成标准连续时间轴,将业务数据与标准时间索引对齐,填充缺失日期,彻底解决时序数据间断、格式混乱、无法周期分析的问题。
五、常见报错与避坑要点
1. pd.to_datetime常见问题
杂乱特殊字符时间直接报错,需配置errors="coerce"容错处理;时间格式不统一导致转换失败,可手动指定format参数精准匹配;数字时间戳未设置单位导致时间偏移,需补充unit参数校准。
2. pd.date_range常见问题
参数填写混乱,未遵循“三缺一”规则导致生成失败;频率freq设置错误,出现时间间隔错乱;起止时间格式不标准,导致序列生成异常,需提前用to_datetime标准化。
六、综合实战:完整时序数据处理案例
模拟间断杂乱的门店销售数据,通过两个函数完成清洗与补全,实现规整时序报表构建。
import pandas as pd
df = pd.DataFrame({
"sale_time":["2025/01/01","2025-01-03","2025/01/04"],
"sales":[2300,2100,2500]
})
df["sale_time"] = pd.to_datetime(df["sale_time"])
full_time = pd.date_range(start="2025-01-01", end="2025-01-04", freq="D")
df = df.set_index("sale_time")
df = df.reindex(full_time)
print("规整后的完整时序数据:")
print(df)
最终实现杂乱时间标准化、间断时间补全、时序数据规整,满足后续每日销量统计、趋势分析、缺失值填充的需求。
七、总结
pd.to_datetime 和 pd.date_range 是Pandas时间处理的两大基石,分工明确、相辅相成。pd.to_datetime聚焦存量时间清洗标准化,解决原始时间格式混乱、类型不统一、无法运算的问题;pd.date_range聚焦增量时间序列构建,解决时间间断、周期缺失、时序不规整的问题。
在时间序列分析、业务报表统计、数据清洗、机器学习时序建模等场景中,熟练搭配使用两个函数,能够快速完成时间数据标准化、时间轴规整、缺失周期补全,构建高质量时序数据集,为后续的时间分组、趋势挖掘、周期分析、数据预测提供坚实的数据支撑,是数据分析从业者必须掌握的基础核心技能。
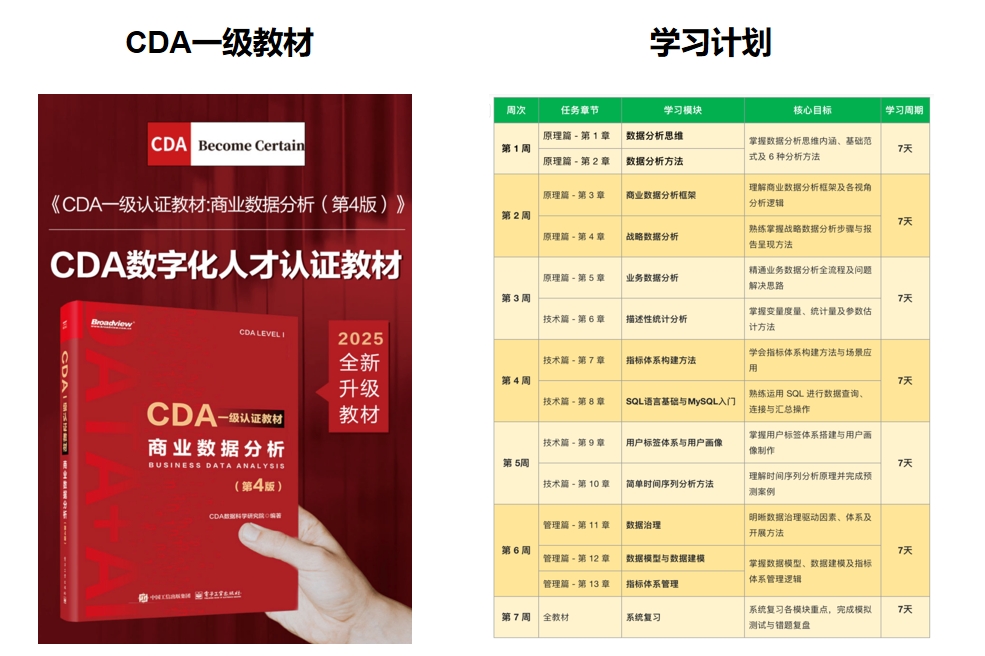
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330