在机器学习 建模中,决策树 模型因其结构直观、易于理解、无需复杂数据预处理 等优势,成为分类与回归任务的首选工具之一。而变量重要性排序,作为决策树 模型的核心输出之一,更是数据分析与特征 工程的关键环节——它能帮我们快速识别对模型预测结果影响最大的变量,实现特征 筛选、模型优化 、业务归因等核心需求,让建模更高效、结论更具针对性。
很多从业者在使用决策树 (及随机森林 、XGBoost 等基于决策树 的集成模型)时,往往只关注模型准确率 ,却忽视了变量重要性排序的价值;或是盲目依赖模型默认输出的排序结果,未理解其计算逻辑,导致特征 筛选失误、业务解读偏差 。本文将从决策树 变量重要性的核心原理出发,拆解排序方法、实操步骤,结合参考资料与典型案例,详解结果解读技巧与常见误区,帮你真正吃透变量重要性排序,让决策树 模型发挥更大价值。
一、核心认知:什么是决策树 变量重要性排序? 决策树 模型的核心逻辑,是通过递归划分特征 (变量),将数据集逐步拆分為纯度更高的子集,最终形成可用于预测的树形结构[2]。而变量重要性排序,本质是量化每个变量在决策树 划分过程中的“贡献度” ——贡献度越高,说明该变量对模型区分样本类别、拟合回归数值的作用越强,对预测结果的影响也就越大。
简单来说,变量重要性排序就是给模型中的所有输入变量“打分排名”,分数越高,该变量越“有价值”。例如,在用户流失预测模型中,若“近30天登录次数”的重要性得分最高,说明该变量是判断用户是否流失的核心因素;在商品销量预测中,若“促销力度”得分领先,则说明促销活动对销量的影响最为显著。
需要注意的是,决策树 的变量重要性排序并非“绝对真理”,它依赖于训练数据、模型参数与划分准则,存在一定的局限性[1]。但合理运用这一工具,能帮我们快速抓住核心特征 ,摆脱“特征 冗余”的困扰,尤其适用于高维数据场景(如多变量用户行为分析、多特征 质量检测)。
二、底层逻辑:变量重要性的3种核心计算方法 决策树 模型(单棵决策树 及集成模型)计算变量重要性的逻辑,核心围绕“特征 划分对模型性能的提升”展开,不同算法的计算方式略有差异,但核心思路一致。以下梳理3种最常用的计算方法,结合参考资料拆解其核心逻辑,兼顾理论与实操理解[2]:
1. 基于信息增益/信息增益比(ID3 /C4.5算法) 该方法主要用于分类决策树 ,核心逻辑是:变量的重要性 = 该变量每次划分带来的信息增益(或信息增益比)之和 。
先明确两个核心概念[2]:
1. 信息熵(Entropy):衡量数据集的混乱程度,熵越大,数据类别越分散(不确定度越高);熵越小,数据类别越纯净(不确定度越低)。极端情况下,若数据集全为同一类别,熵为0;若二分类 数据各占50%,熵达到最大值。
2. 信息增益:用某一变量划分数据集后,信息熵减少的程度。信息增益越大,说明该变量的划分效果越好,能最大程度降低数据的混乱度。
计算逻辑:在决策树 构建过程中,每次选择信息增益(或信息增益比)最大的变量进行划分,将该变量每次划分的信息增益累加,累加值即为该变量的重要性得分,得分越高,变量越重要[2]。例如,在“西瓜好坏判断”模型中,“敲声”变量每次划分的信息增益之和高于“色泽”“根蒂”,则“敲声”的重要性排名更靠前。
适用场景:单棵分类决策树 (ID3 、C4.5算法),适合对分类任务的变量重要性进行初步判断。
2. 基于Gini系数减少量(CART算法) CART算法(可用于分类与回归)采用Gini系数衡量节点纯度,其变量重要性的计算逻辑是:变量的重要性 = 该变量每次划分带来的Gini系数减少量 × 该节点包含的样本比例之和 。
Gini系数的核心含义:衡量节点中样本类别的分散程度,取值范围为0-1,Gini系数越小,节点纯度越高(样本类别越集中)[2]。当用某一变量划分节点时,会使节点的Gini系数降低,降低的幅度越大,说明该变量的划分价值越高。
计算逻辑:对于每个变量,遍历其在决策树 中所有参与划分的节点,计算每个节点划分后的Gini系数减少量,再乘以该节点的样本占比(体现节点的重要性),将所有节点的结果累加,即为该变量的重要性得分[2]。
适用场景:单棵CART决策树 (分类/回归),是目前最常用的单棵决策树 变量重要性计算方法,兼容性更强。
3. 基于节点不纯度减少量(集成决策树 ) 随机森林 、XGBoost 、LightGBM 等集成模型,其变量重要性排序是基于单棵决策树 的结果进行汇总,核心逻辑是:变量的重要性 = 所有单棵决策树 中该变量的重要性得分的平均值(或加权平均值) 。
以随机森林 为例,其计算步骤[1][2]:
1. 构建多棵独立的决策树 (每棵树使用不同的样本子集和特征 子集);
2. 计算每棵单棵决策树 中每个变量的重要性得分(基于Gini系数减少量或信息增益);
3. 将所有决策树 中同一变量的得分取平均值,得到该变量的最终重要性得分,按得分降序排序。
优势:集成模型的变量重要性排序更稳定、更具泛化能力 ,能有效避免单棵决策树 的过拟合 问题,是实际业务中最常用的排序方式[1]。
三、实操落地:决策树 变量重要性排序完整步骤(以Python为例) 结合实际业务场景,以“用户流失预测”为案例,拆解决策树 (随机森林 )变量重要性排序的完整实操流程,步骤清晰、可直接复现,兼顾新手友好性与实用性。
步骤1:准备数据,明确建模目标 建模目标:预测用户是否会流失(二分类 任务);
输入变量(特征 ):近30天登录次数、近30天消费金额、会员等级、是否使用优惠券、注册时长;
目标变量:是否流失(1=流失,0=未流失)。
数据预处理 :删除缺失值 、异常值 ,对分类变量进行编码(如会员等级用标签编码),无需标准化(决策树 模型对特征 尺度不敏感),最终拆分训练集(80%)与测试集(20%)。
步骤2:构建决策树 (集成)模型,计算变量重要性 选用随机森林 (集成模型,稳定性更强),通过Python的sklearn库实现,核心代码如下(可直接复制使用):
import pandas as pdfrom sklearn.ensemble import RandomForestClassifierfrom sklearn.model_selection import train_test_splitimport matplotlib .pyplot as plt"user_churn_data.csv" )"是否流失" , axis=1 ) "是否流失" ] 0.2 , random_state=42 )100 , random_state=42 ) DataFrame ({"变量名称" : X.columns,"重要性得分" : feature_importance"重要性得分" , ascending=False )步骤3:可视化变量重要性排序 仅看数值不够直观,通过可视化(柱状图 )展示排序结果,更便于解读与汇报,核心代码如下:
'font.sans-serif' ] = ['SimHei' ]'axes.unicode_minus' ] = False 10 , 6 ))"变量名称" ], feature_importance_sorted["重要性得分" ], color="skyblue" )"重要性得分" )"变量名称" )"随机森林 模型变量重要性排序" )可视化结果解读:假设排序结果为「近30天登录次数(0.32)> 近30天消费金额(0.28)> 注册时长(0.18)> 是否使用优惠券(0.12)> 会员等级(0.10)」,说明“近30天登录次数”是影响用户流失的最核心变量。
步骤4:基于排序结果,落地应用 变量重要性排序的核心价值的在于“落地应用”,而非单纯的排名,结合案例可从3个维度落地[1]:
1. 特征 筛选:保留重要性得分前3-4个变量(如近30天登录次数、近30天消费金额、注册时长),删除冗余变量(如会员等级),简化模型结构,减少计算资源消耗;
2. 模型优化 :针对重要性高的变量,可进一步挖掘特征 (如将“近30天登录次数”拆分为“工作日登录次数”“周末登录次数”),提升模型准确率 ;
3. 业务归因:结合排序结果解读业务逻辑——用户流失的核心原因是“登录频次低”“消费金额少”,因此可针对性制定运营策略(如给登录频次低的用户推送召回优惠券,给消费金额下降的用户推送专属福利)。
四、关键解读:变量重要性排序的“正确打开方式” 很多从业者容易陷入“得分越高,变量越有用”的误区,实则变量重要性排序的解读需要结合业务场景、数据特点,避免机械解读。结合参考资料,总结3个核心解读原则[1][2]:
1. 重要性得分是“相对值”,而非“绝对值” 变量重要性得分的取值范围为0-1,所有变量的得分之和为1(部分集成模型可能略有差异),它反映的是“变量之间的相对重要性”,而非变量本身的“绝对价值”。例如,“会员等级”的得分0.10,不代表它“无用”,而是相对于“近30天登录次数”(0.32),其影响更小。
2. 结合业务场景解读,拒绝“数据脱节” 变量重要性排序必须结合业务逻辑,否则可能得出荒谬结论。例如,在用户流失模型中,若“用户ID”的重要性得分异常高,并非因为“用户ID”影响流失,而是因为“用户ID”是高基数变量(每个用户取值唯一),决策树 容易过度拟合这类变量[1],此时需排除该变量,而非盲目认为其重要。
3. 警惕“伪重要性”,规避模型局限性 决策树 模型的变量重要性存在天然局限性[1]:
1. 偏好连续变量或高基数分类变量:这类变量在节点划分时更容易找到最优切分点,导致重要性得分被高估(如用户ID、订单号等高基数变量);
2. 无法反映变量的泛化能力 :重要性得分基于训练集计算,若训练集与测试集分布差异较大,得分高的变量可能在测试集上无实际作用,甚至导致模型过拟合 ;
3. 无法体现变量间的交互作用:若两个变量协同影响预测结果(如“消费金额”与“优惠券使用”),单独看每个变量的重要性得分,可能无法体现其联合价值。
五、常见误区与避坑指南(新手必看) 结合参考资料与实操经验,梳理4个新手最易踩的误区,帮你避开陷阱,确保变量重要性排序的结果可靠、可用[1][2]:
误区1:盲目依赖默认排序,不验证合理性 错误操作:直接使用模型输出的排序结果,不结合业务逻辑验证,甚至将高基数无用变量(如用户ID)作为核心特征 ;
正确做法:排序后先筛选掉明显无业务意义的变量,再结合业务场景验证核心变量的合理性(如用户流失模型中,登录频次、消费金额应是核心变量)。
误区2:将“重要性”等同于“因果关系” 错误解读:认为“重要性得分高的变量,一定是导致预测结果的原因”(如“近30天登录次数高”导致“用户不流失”);
正确解读:变量重要性仅能反映“变量与预测结果的相关性”,无法证明因果关系[1]。例如,登录次数高与用户不流失相关,但可能是“用户本身活跃度高”同时导致了登录次数高和不流失,二者并非因果关系。
误区3:忽视数据质量 ,导致排序失真 错误操作:数据存在缺失值 、异常值 ,或分类变量编码不规范,直接建模计算变量重要性;
正确做法:建模前必须做好数据预处理 ,删除或填充缺失值 、处理异常值 ,规范分类变量编码,避免数据问题导致排序结果失真[2]。
误区4:单棵决策树 排序结果直接用于落地 错误操作:用单棵决策树 的变量重要性排序结果,直接进行特征 筛选或业务决策;
正确做法:单棵决策树 的排序结果稳定性差、易过拟合 [1],建议使用随机森林 、XGBoost 等集成模型的排序结果,若需用单棵决策树 ,需多次训练验证,取平均值减少偏差 。
六、总结:变量重要性排序—— 让决策树 建模更具“针对性” 决策树 模型的变量重要性排序,是连接“模型输出”与“业务落地”的关键桥梁,其核心价值不在于“排名”,而在于“筛选核心特征 、解读业务逻辑、优化模型性能”。无论是特征 工程中的冗余筛选,还是业务决策中的归因分析,变量重要性排序都能帮我们摆脱“盲目建模”的困境,让每一步操作都有数据支撑。
回顾全文,掌握变量重要性排序的核心逻辑,需抓住3个关键点:一是理解其“量化特征 划分贡献度”的本质,二是掌握不同算法的计算方法,三是结合业务场景与数据质量 解读结果、规避误区。尤其要注意,决策树 的变量重要性存在局限性[1],不可盲目迷信,需结合多方面验证,才能让排序结果真正服务于建模与业务。
对于数据分析从业者而言,熟练运用决策树 变量重要性排序,能大幅提升建模效率,让模型更简洁、结论更有说服力。后续可结合实际业务场景(如销量预测、风险识别、用户分层)多练习、多验证,逐步掌握解读技巧,让决策树 模型真正成为数据分析的“得力助手”。
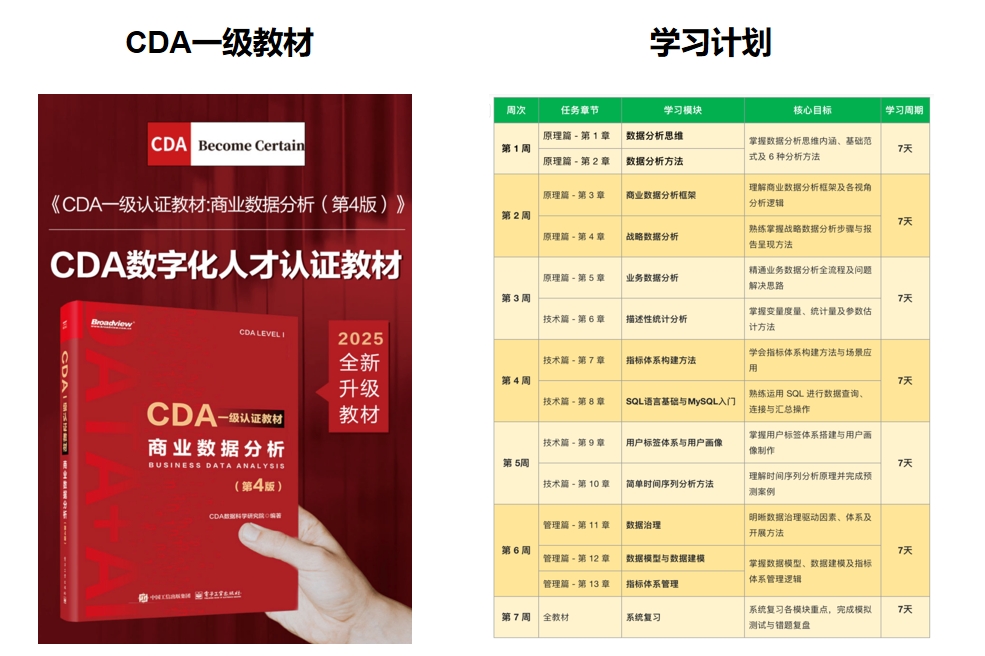
推荐学习书籍 《CDA一级教材 》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ ! 


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330