Excel 数据聚类分析:从操作实践到业务价值挖掘
在数据分析场景中,聚类分析作为 “无监督分组” 的核心工具,能从杂乱数据中挖掘隐藏的相似性规律(如用户分群、产品分类、区域特征聚合)。相较于 SPSS、Python 等专业工具,Excel 凭借 “普及率高、操作门槛低、可视化直观” 的优势,成为中小规模数据(通常 10 万条以内)聚类分析的首选工具 —— 尤其适合运营、财务、行政等非技术岗位从业者,无需代码即可实现 “数据分组→规律识别→决策支撑” 的闭环。本文将从基础逻辑到实战操作,系统讲解 Excel 数据聚类分析的方法与应用。
一、Excel 数据聚类分析的基础认知:是什么与为什么用
1. 核心定义:用 Excel 实现 “相似数据归为一类”
聚类分析的本质是 “基于数据特征的自动分组”,无需提前标注类别(与分类分析的 “有监督” 不同)。在 Excel 中,聚类的核心逻辑是:通过数值范围划分、特征关联匹配、可视化差异识别等方式,将具有相似属性的数据(如 “高消费频次 + 高客单价” 的用户)归为同一集群,让隐性规律显性化。
例如:某零售企业的 300 家门店数据(含 “月销售额、客流量、坪效、区域类型”),通过 Excel 聚类可分为 “高销高流型”“高坪效低流型”“低销低坪效型” 等门店集群,为后续差异化运营提供依据。
2. Excel 做聚类的核心优势:适配非技术场景
| 优势维度 |
具体价值 |
| 操作门槛低 |
依赖菜单点击、函数公式,无需掌握编程(Python)或专业算法(K-means) |
| 数据兼容性强 |
直接读取 Excel 原生表格数据,无需格式转换(避免 SPSS、Python 的数据导入问题) |
| 可视化同步性 |
聚类结果可直接联动条件格式、数据透视表、图表,即时生成可落地的分析报告 |
| 中小数据高效 |
针对 1 万 - 10 万条数据,聚类速度优于需环境配置的专业工具 |
3. 适用场景与局限性
适用场景:中小规模数据的探索性聚类(如用户价值分群、产品销量分类、月度数据趋势分组)、非高精度需求的快速分析(如行政部门的员工考勤异常分组);
局限性:不支持大规模数据(10 万条以上易卡顿)、缺乏智能算法优化(如无法自动确定最优聚类数量)、难以处理高维数据(超过 5 个特征时操作复杂)。
二、聚类前的关键准备:Excel 数据清洗与标准化
聚类分析的准确性依赖 “干净的数据”,Excel 中需完成 3 步核心准备工作,避免因数据质量问题导致聚类偏差。
首先明确聚类目标,剔除无关字段:
例:若目标是 “电商用户价值分群”,需保留 “消费频次、客单价、近 30 天活跃天数、总消费额” 等特征,删除 “用户 ID、注册时间” 等无关字段;
操作:选中数据区域→菜单栏 “数据”→“筛选”→勾选目标字段,或直接删除无关列。
2. 缺失值处理:避免数据断层
Excel 中常见缺失值处理方法:
删除法:若缺失值占比 <5%(如 300 条数据中 10 条缺失),选中缺失行→右键 “删除”;
填充法:若缺失值占比 5%-20%,用 “均值 / 中位数 / 众数” 填充:
数值型数据(如消费额):选中目标列→菜单栏 “开始”→“编辑”→“填充”→“系列”,或用函数=AVERAGE(A2:A301)(均值)、=MEDIAN(A2:A301)(中位数);
分类数据(如区域类型):用=MODE(B2:B301)(众数)填充,或通过 “数据透视表” 统计高频类别后手动补充。
3. 数据标准化:消除量级差异影响
聚类时若特征量级差异大(如 “消费频次” 范围 1-50,“总消费额” 范围 100-10000),会导致 “总消费额” 主导聚类结果。Excel 中用STANDARDIZE函数标准化,将所有特征转化为 “均值 0、标准差 1” 的统一量级:
公式:=STANDARDIZE(原始数据单元格, 该列均值, 该列标准差)
例:对 “消费频次” 列(A2:A301)标准化,先计算均值=AVERAGE(A2:A301)(假设结果在 D2)、标准差=STDEV.S(A2:A301)(结果在 D3),再在 E2 输入=STANDARDIZE(A2,D$2,D$3),下拉填充至 E301。
三、Excel 聚类分析的 3 种核心操作方法
Excel 无 “一键聚类” 功能,但可通过 “原生功能组合”“进阶工具辅助” 实现不同精度的聚类需求,以下按 “操作难度” 从低到高讲解。
1. 基础方法:数据透视表 + 分位数分组(适合数值型数据)
核心逻辑:通过 “分位数” 将连续数值划分为离散区间(如将 “总消费额” 分为 “高、中、低” 三档),再用数据透视表汇总聚类结果,适合新手入门。
操作步骤(以 “电商用户消费数据聚类” 为例):
确定分位数区间:
目标:将 “总消费额”(A 列)分为 3 档,先计算 25%、50%、75% 分位数(对应低、中、高的临界值):
25% 分位数(Q1):=PERCENTILE.INC(A2:A301,0.25)(假设结果 1000 元);
50% 分位数(Q2):=PERCENTILE.INC(A2:A301,0.5)(假设结果 3000 元);
75% 分位数(Q3):=PERCENTILE.INC(A2:A301,0.75)(假设结果 6000 元)。
用 IF 函数标注聚类标签:
在 B 列(聚类标签列)输入公式,按分位数划分档次:
=IF(A2<=1000,"低价值用户",IF(A2<=3000,"中价值用户","高价值用户")),下拉填充至 B301。
选中数据区域(含 “用户 ID、聚类标签、消费频次、客单价”)→菜单栏 “插入”→“数据透视表”;
行标签选 “聚类标签”,值字段选 “消费频次”(求和)、“客单价”(平均值)、“用户 ID”(计数);
结果解读:若 “高价值用户” 的平均客单价是低价值用户的 5 倍、消费频次是 3 倍,验证聚类逻辑合理。
2. 可视化方法:条件格式 + 散点图(适合特征关联聚类)
当聚类需结合 “两个特征的关联关系”(如 “消费频次 vs 客单价”),可通过条件格式上色、散点图分区实现直观聚类,快速识别 “异常集群”。
操作步骤(以 “门店坪效与客流量聚类” 为例):
选中 “坪效” 列(A 列)→菜单栏 “开始”→“条件格式”→“色阶”→选 “红 - 黄 - 绿”(绿色代表高坪效,红色代表低坪效);
同理对 “客流量” 列(B 列)设置色阶,形成 “双特征颜色矩阵”:绿色 + 绿色 = 高坪效高客流,红色 + 红色 = 低坪效低客流。
选中 A、B 列数据→“插入”→“散点图”→“带平滑线的散点图”;
添加趋势线:右键散点→“添加趋势线”→选择 “线性”,勾选 “显示公式”;
手动分区:在散点图上插入 “直线”,按趋势线将图表分为 4 个象限:
第二象限(左上):高坪效低客流(潜力门店,需提升客流);
第四象限(右下):低坪效高客流(低效门店,需提升坪效)。
提取聚类结果:
右键散点图→“选择数据”→“添加”→按象限框选数据,分别命名为 “优质门店”“潜力门店” 等,生成带聚类标签的散点图,直接用于汇报。
3. 进阶方法:Power Query + 分析工具库(适合多特征聚类)
当聚类涉及 3 个以上特征(如 “销量、利润率、库存周转率、复购率”),需用 Power Query 做特征整合,结合 Excel 的 “分析工具库” 做相关性辅助,提升聚类精度。
操作步骤(以 “产品多维度聚类” 为例):
数据区域→“数据”→“从表格 / 区域”(进入 Power Query 编辑器);
若存在 “文本型特征”(如 “产品类别”),先通过 “添加列”→“条件列” 转为数值(如 “食品 = 1,日用品 = 2”);
点击 “关闭并上载”,将处理后的数据返回到 Excel 表格。
先启用分析工具库:“文件”→“选项”→“加载项”→“Excel 加载项”→“转到”→勾选 “分析工具库”;
菜单栏 “数据”→“数据分析”→选 “相关系数”→输入区域选 “销量、利润率、库存周转率” 列→输出区域选空白单元格;
结果解读:若 “销量与利润率” 的相关系数为 0.7(强正相关),可合并为 “盈利能力特征”,减少聚类维度(避免特征冗余)。
多特征分组聚类:
用LOOKUP函数结合多特征分位数,生成综合聚类标签:
=LOOKUP(A2*0.4+B2*0.3+C2*0.3,{0,2,4},{"C类产品","B类产品","A类产品"})
(注:0.4、0.3 为特征权重,根据业务重要性调整,如 “销量” 权重高于 “库存周转率”)。
四、实战案例:Excel 实现电商用户分群聚类
以某电商平台的 500 名用户数据(含 “近 30 天活跃天数、消费频次、客单价、总消费额”)为例,完整演示 “目标定义→数据准备→聚类操作→业务应用” 的全流程。
1. 聚类目标
将用户分为 “核心用户、活跃用户、潜力用户、沉睡用户”4 类,支撑会员体系设计。
2. 数据准备
清洗:删除 “总消费额 = 0” 的无效用户(12 条),用AVERAGE填充 “活跃天数” 的缺失值(8 条);
标准化:对 4 个特征用STANDARDIZE函数处理,消除量级差异(如 “总消费额” 100-50000 元,“活跃天数” 1-30 天)。
3. 聚类操作(组合方法)
用PERCENTILE.INC计算 4 个特征的 75%、50%、25% 分位数,设定 “达标阈值”(如活跃天数≥20 天为达标);
用COUNTIF统计每个用户的 “达标特征数”:达标 4 个 = 核心用户,3 个 = 活跃用户,2 个 = 潜力用户,≤1 个 = 沉睡用户;
数据透视表汇总:核心用户仅占 15%,但贡献了 50% 的总消费额;沉睡用户占 40%,平均消费频次仅 0.5 次;
散点图验证:以 “消费频次 vs 总消费额” 做散点图,核心用户集中在右上象限,沉睡用户集中在左下,聚类无交叉。
4. 业务应用
核心用户:推送专属权益(如免运费、专属客服),提升留存;
活跃用户:推出 “满额赠礼”,推动向核心用户转化;
沉睡用户:触发 “回归红包”(如满 100 减 30),唤醒消费。
五、Excel 聚类分析的注意事项与优化方向
1. 避免 3 个常见误区
误区 1:分位数区间固定化:不同数据的分布不同,不能默认 “3 档 = 25%、50%、75%”,需结合业务调整(如高价值用户仅占 10%,则用 90% 分位数作为临界值);
误区 2:忽视特征权重:多特征聚类时,若所有特征同等对待(如 “库存周转率” 与 “销量” 权重相同),可能偏离业务目标,需通过专家评分或 A/B 测试确定权重;
误区 3:聚类结果不验证:需用 “业务常识” 验证,如若 “高价值用户” 的复购率低于低价值用户,说明聚类逻辑错误,需重新调整特征。
2. 优化方向:Excel 与其他工具互补
当数据量 > 10 万条:用 Python(Pandas)做数据清洗后,导出为 Excel 格式,再用本文方法聚类(兼顾效率与操作便捷性);
需智能确定聚类数量:用 SPSS 的 “K-means 聚类” 计算最优 K 值(如 K=4),将聚类标签导入 Excel,再做可视化与业务解读;
自动化聚类:通过 Excel VBA 编写宏代码,实现 “数据更新→自动聚类→生成报告” 的流程(适合高频聚类需求,如月度用户分群)。
六、总结:Excel 聚类的核心价值 —— 让 “数据分组” 落地业务
Excel 数据聚类分析的本质,不是追求 “算法先进性”,而是通过 “低成本、高适配的操作”,让非技术人员也能将 “数据分组” 转化为可执行的业务动作。无论是用数据透视表做用户分群,还是用散点图做门店聚类,最终目标都是:
从 “杂乱数据” 中提炼 “清晰集群”(如将 500 个用户归为 4 类,而非逐个分析);
从 “集群特征” 中找到 “差异化策略”(如对优质门店复制经验,对低效门店制定优化方案);
从 “策略落地” 中验证 “聚类价值”(如核心用户权益推出后,复购率提升 20%,证明聚类有效)。
对于多数职场人而言,掌握 Excel 聚类分析,不仅是提升数据分析能力,更是建立 “用数据驱动决策” 的思维 —— 无需复杂工具,只需一张表格、几个函数,就能让数据说话,让决策更精准。
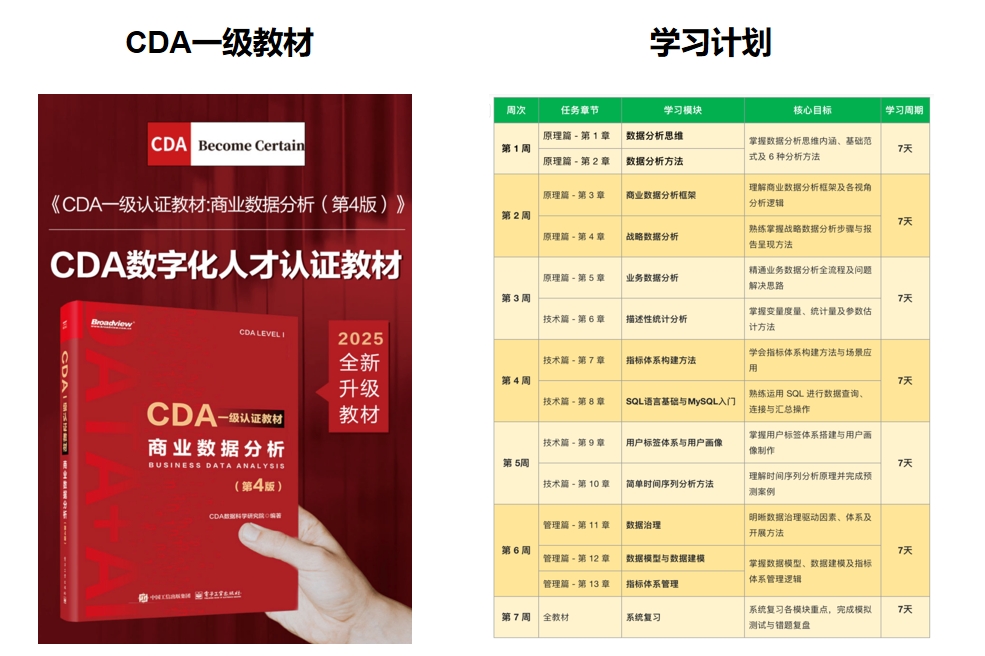
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330