在数据分析、特征工程、机器学习建模的工作流程中,原始数据往往包含多个不同维度的数值指标,例如客户交易数据中的消费金额、交易频次、平均停留时长,或是运营数据中的销售额、订单量、客单价。这些指标的计量单位、数值区间、波动幅度差异极大,直接用于计算、建模或综合评分时,会出现大数值指标覆盖小数值指标作用的问题,导致分析结论失真、模型精度下降。
数据归一化是解决量纲差异问题的核心预处理手段,也是 Pandas 数据处理中的高频操作。通过对 DataFrame 中的数值字段执行标准化的数学变换,将不同量纲的指标映射到统一的数值区间内,消除单位与量级差异,让所有指标具备同等的权重可比性,是多指标综合评价、距离计算、机器学习建模的前置必备步骤。本文系统拆解 DataFrame 归一化的核心原理、主流方法、Pandas 落地流程、实战案例与常见误区,形成完整的标准化操作指南。
(一)核心定义
DataFrame 数据归一化,是指通过线性或非线性的数学变换,将 DataFrame 中不同量纲、不同取值范围的数值列,映射到特定的统一区间内,在保留数据相对分布规律的前提下,消除指标间的量级差异与单位差异。
归一化不会改变数据的内部排序与相对关系,仅调整数值的绝对大小,让不同维度的指标可以放在同一维度下对比、计算与加权,是多维度量化分析的基础预处理操作。
(二)核心业务价值
消除量纲干扰,实现跨指标可比
不同业务指标的单位与量级天差地别,例如消费金额单位为元,取值范围从几十到几万;交易频次单位为次,取值范围从 1 到几十。未经归一化直接加权计算综合得分,金额指标会完全主导结果,频次指标的作用会被淹没。归一化后所有指标落在同一区间,可公平参与综合计算。
提升模型运算精度与收敛速度
在机器学习、聚类分析、回归建模等场景中,量纲差异会导致梯度下降迭代次数增加、模型收敛变慢,甚至影响权重计算的准确性。归一化后的数据能够显著提升模型训练效率与结果稳定性。
适配算法计算逻辑,避免数值异常
基于距离计算的算法(如 K-means 聚类、KNN、余弦相似度)对数值量级高度敏感,大数值字段会被判定为更大的距离权重,导致分类、聚类结果偏差。归一化可保证各维度权重均衡,输出符合业务逻辑的计算结果。
二、主流归一化方法与适用场景
针对不同数据分布与业务场景,主流的归一化方法分为三类,各有明确的适用边界,需根据数据特征与分析目标选择。
(一)最小 - 最大归一化(Min-Max Scaling)
也称为离差标准化,是最常用的线性归一化方法,通过极值变换将数据线性映射到 [0,1] 区间内。
计算公式:归一化值 = (原始值 - 最小值) / (最大值 - 最小值)
核心特点:保留数据的原始比例关系,将数值严格限定在 0 到 1 之间,最大值对应 1,最小值对应 0。
适用场景:数据分布稳定、无极端异常值,需要输出固定区间数值的场景,如综合评分、多指标加权、图像数据处理。
局限性:对异常值极其敏感,若存在极端最大 / 最小值,会让大部分数据集中在极小的区间内,归一化效果失效。
(二)Z-score 标准化(零均值归一化)
也称为标准差标准化,是基于数据均值与标准差的变换方法,处理后的数据符合均值为 0、标准差为 1 的标准正态分布。
计算公式:归一化值 = (原始值 - 均值) / 标准差
核心特点:不限制数值区间,保留数据的分布形态,将数据转化为无单位的标准分,反映数据在整体分布中的相对位置。
局限性:输出数值存在正负,不适合要求非负输入的场景;若原始数据不符合正态分布,标准化效果会打折扣。
(三)小数定标归一化
通过移动数据的小数点位置实现归一化,根据数据的最大绝对值,将所有数值除以 10 的 n 次方,使数据落入 [-1,1] 区间。
计算公式:归一化值 = 原始值 / 10^n,其中 n 为满足最大绝对值小于 1 的最小整数。
核心特点:计算简单,保留数据的数量级差异,对数据分布影响最小。
适用场景:数据数量级差异大、需要保留数值量级特征的场景,多用于财务、金融类大数值数据预处理。
三、Pandas 实现 DataFrame 归一化的标准化流程
在 Python 数据分析场景中,通常结合 Pandas 与 NumPy 完成 DataFrame 的归一化操作,遵循标准化流程可保证结果准确、逻辑可复现。
首先完成原始数据清洗,处理缺失值、异常值,剔除空值与无效数据;随后从 DataFrame 中筛选出所有需要归一化的数值型字段,排除 ID、分类、日期等非数值字段,避免运算报错。
第二步:选择适配的归一化方法
根据数据分布特征与业务目标选择对应方法:数据稳定无极端值选 Min-Max 归一化;存在异常值、用于建模选 Z-score 标准化;大数值数量级差异大选小数定标归一化。
第三步:执行批量归一化运算
通过 Pandas 的列向运算能力,对目标字段批量执行公式变换,生成归一化后的新列或新 DataFrame。运算过程中需注意分母为 0 的边界情况,避免出现计算错误。
第四步:结果校验与业务还原
归一化完成后,校验数值区间、分布特征是否符合预期;同时保留原始极值、均值、标准差等参数,便于后续将归一化结果反向还原为真实业务数值,保障结果可解读。
四、实战案例:客户价值指标归一化
以客户交易价值分析场景为例,原始 DataFrame 包含消费金额、交易频次、平均停留时长三个指标,三者量纲差异巨大,无法直接计算客户综合价值得分,通过 Min-Max 归一化实现指标统一。
原始数据特征:
消费金额:取值 200-15000 元,数值跨度极大
平均停留时长:取值 5-120 分钟,数值量级居中
归一化实现逻辑
对每一行数据套用 Min-Max 公式,生成三个归一化后的新字段,所有数值落在 0-1 区间;
对三个归一化字段按业务权重加权求和,得到客户综合价值得分。
通过归一化处理,三个指标公平参与价值评分,避免了消费金额因数值过大完全主导评分结果的问题,最终的客户分层结果更贴合真实业务价值。
1. 对分类字段、日期字段执行归一化
归一化仅适用于连续型数值字段,类别 ID、地区编码、日期时间等字段不具备数值计算意义,归一化毫无业务价值,反而会破坏数据的分类属性。
2. 忽略异常值直接归一化
使用 Min-Max 归一化前未处理极端异常值,会导致绝大多数数据被压缩在极小的范围内,归一化后区分度极低,完全失去指标对比的作用。存在异常值时,需先剔除或修正异常值,或改用 Z-score 标准化。
3. 所有场景统一使用同一种方法
不同场景适配不同方法,综合评分优先 Min-Max,建模聚类优先 Z-score,盲目混用会导致分析结果偏差。不存在万能的归一化方法,需结合数据特征与目标选择。
4. 归一化后直接解读业务含义
归一化后的数值是相对值,不代表真实业务量级。例如归一化得分 0.8,不代表消费金额是 800 元,仅代表该指标在整体数据中处于较高水平。解读最终结论时,需结合原始指标含义,不能直接用归一化数值解释业务规模。
5. 建模场景全量数据一起归一化
机器学习场景中,若将训练集和测试集合并后统一归一化,会造成数据泄露,导致模型效果虚高。正确做法是仅用训练集的极值、均值计算归一化参数,再应用到测试集上。
六、全文总结
DataFrame 数据归一化是数据预处理体系中的核心基础操作,本质是在保留数据相对规律的前提下,消除量纲差异,让多维度指标具备统一的可比性。最小 - 最大归一化、Z-score 标准化、小数定标归一化三类主流方法,分别适配不同的数据分布与业务场景,不存在绝对的优劣之分,只有适配与否的区别。
在实际数据分析工作中,先明确分析目标与数据特征,选择对应的归一化方法,遵循标准化的操作流程,规避异常值干扰、字段错用等常见误区,才能让归一化真正发挥数据预处理的价值,为后续的综合评分、模型训练、多维度分析输出可靠的基础数据,保障分析结论的科学性与准确性。
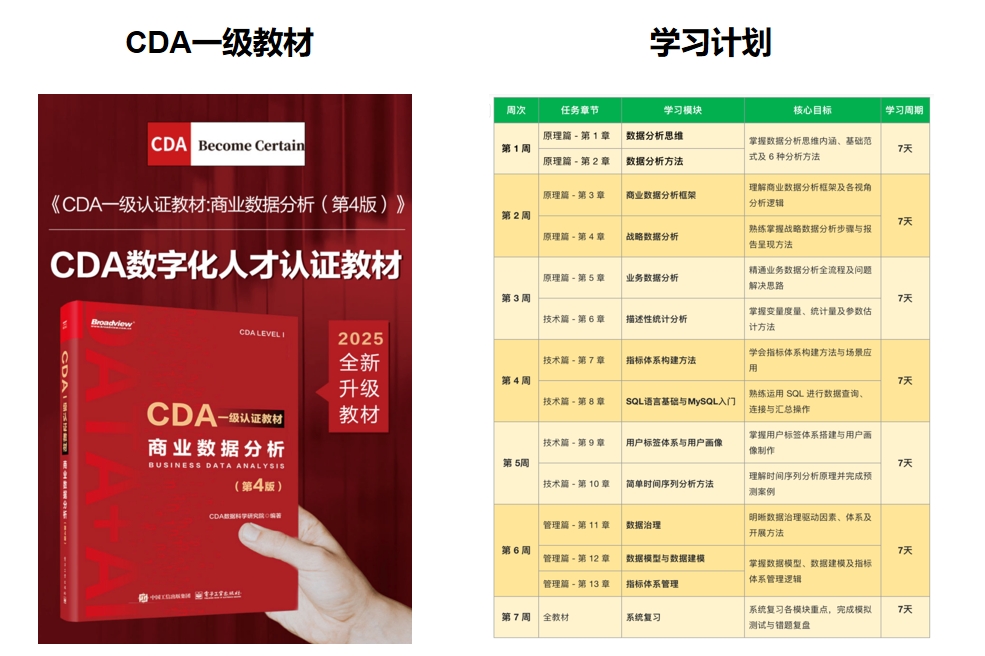
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330