在数据统计分析与数据清洗工作中,箱线图是一种简洁高效、客观性强的数据可视化图表,能够直观呈现数据集的分布特征、离散程度和异常样本。相较于折线图、柱状图等常规图表,箱线图最大的优势是可以依托标准化统计规则,精准甄别数据异常值,规避人工主观判断的偏差。在箱线图的各类结构要素中,上下边缘是界定正常数据与异常数据的核心边界,是数据分析的关键参考依据。本文将围绕箱线图上下边缘的结构原理、核心含义、判别逻辑及实战应用展开详细阐述。
一、箱线图的基础构成与核心指标
标准箱线图主要由中位数、上下四分位数、箱体、上下须及离散异常点构成,所有结构的数值界定均依托四分位数间距(IQR)实现,具备严谨的统计学依据。其中,上下须的端点即为上下边缘,代表数据集正常波动范围的极限边界,是区分有效样本与离群异常样本的重要标尺。
箱线图的核心计算指标包含三项:下四分位数Q1、上四分位数Q3、四分位距IQR,其中IQR=Q3-Q1,代表数据中间50%样本的离散跨度。行业通用标准为,以1.5倍IQR作为数据临界阈值,以此划分正常数据与异常数据区间,最终确定上下边缘位置。整套计算规则统一标准、无需人工干预,保障了数据分析的客观性与规范性。
二、箱线图上下边缘的核心统计含义
(一)下边缘的数值含义与判别逻辑
箱线图下边缘是正常数据区间的最小极值,对应的理论临界阈值为 Q1-1.5×IQR。在所有大于该临界阈值的有效样本中,最小的实际数据值即为下边缘端点。
从数据分析角度来看,所有低于下边缘阈值的数据均为低值异常值,属于偏离正常波动规律的离群样本;而大于或等于下边缘的样本,均处于数据正常波动区间。下边缘主要用于识别数据集内的极端低值,可精准筛选出异常偏低的销量、客流、绩效等数据,为低值异常数据清洗提供标准化依据。
(二)上边缘的数值含义与判别逻辑
箱线图上边缘是正常数据区间的最大极值,对应的理论临界阈值为 Q3+1.5×IQR。在所有小于该临界阈值的有效样本中,最大的实际数据值即为上边缘端点。
对应的判别规则为:高于上边缘阈值的数据均为高值异常值,属于极端离群样本;低于或等于上边缘的样本均为正常数据。上边缘主要用于甄别数据集内的极端高值,常用于筛选异常超高营收、突发爆单、极值消费数据等场景,精准区分正常业务波动与极端异常数据。
(三)上下边缘的核心认知误区纠正
需要明确的是,上下边缘并非固定的理论阈值,而是阈值范围内的真实数据极值,二者不能等同。当所有数据均在1.5倍IQR区间内时,上下边缘就是数据集本身的最大值与最小值;当存在超出临界阈值的离群点时,异常点会被单独标记展示,上下边缘则固定在正常数据的极值位置,不会随异常值偏移。
三、上下边缘反映的数据分布特征
(一)反映数据离散程度
上下边缘的间距大小,直接体现正常数据的离散波动水平。间距越小,说明数据整体分布集中、波动幅度小、业务数据稳定性强;间距越大,说明正常数据差异明显、离散度高,业务数据波动较大,稳定性较差。
通过上下边缘与箱体的距离关系,可快速判断数据偏态特征。若上边缘距箱体更远、下边缘贴近箱体,数据呈右偏分布,存在大量偏高极值;若下边缘拉伸、上边缘贴近箱体,数据呈左偏分布,存在大量偏低极值,能够快速直观判断数据集的整体分布规律。
散落在上下边缘外侧的独立离散点,均为统计学意义上的异常值。这类数据多由人工录入错误、系统采集故障、突发业务事件导致,不属于常规业务数据,是数据清洗过程中重点核查、处理的对象。
四、箱线图上下边缘的实战应用价值
依托上下边缘的边界规则,可建立统一、客观的异常值筛选标准,彻底规避人工主观判断的随机性误差。数据分析过程中,可批量识别上下边缘外侧的异常样本,结合业务场景区分错误脏数据与真实极端业务数据,针对性完成删除、替换、保留分析等处理操作,提升原始数据质量。
(二)界定业务正常波动区间
在销售统计、门店运营、用户分析、绩效评估等场景中,利用上下边缘可明确业务数据的常态波动范围,精准区分正常业务波动与极端异常事件,避免将常规数据波动误判为业务问题,或是将特殊极端事件当作普遍规律,有效提升数据分析与业务复盘的准确性。
(三)支撑精细化数据分层
以箱线图上下边缘、四分位数为分层节点,可将数据划分为低值异常、正常区间、高值异常三个层级,进一步细化为多维度数据梯队,可应用于用户价值分层、门店经营评级、商品品类分级等场景,为精细化运营和差异化管理提供数据支撑。
五、上下边缘使用的常见误区与规避方法
(一)混淆理论阈值与实际边缘值
1.5倍IQR计算得出的是理论临界阈值,而上下边缘是真实数据的极值,二者数值通常不相等,且实际边缘值永远不会超出理论阈值范围,数据分析时需严格区分二者概念,避免统计偏差。
(二)对异常值一刀切处理
上下边缘外的异常值并非全部为无效脏数据,部分是真实存在的极端业务样本,如头部高价值用户、大额突发订单等。处理时需先溯源成因,错误数据予以剔除,有效极端数据单独分析,杜绝盲目删除导致的信息丢失。
(三)忽视边缘形态的分布意义
数据分析中不能仅关注异常离散点,忽略上下边缘的形态特征。上下边缘严重不对称、单侧边缘过长,代表数据分布不均、业务两极分化明显,需针对性优化分析口径,全面挖掘数据背后的业务问题。
六、结语
箱线图的上下边缘是统计学中界定数据正常区间与异常区间的核心标尺,具备严谨的计算逻辑与客观的判定标准。下边缘锁定数据合理低值边界,规避偏低异常干扰;上边缘界定数据合理高值边界,过滤偏高极端样本。相较于主观经验判断,依托上下边缘开展数据分析,能够有效提升数据清洗的规范性、数据研判的准确性。
在实战数据分析中,准确掌握上下边缘的统计含义、分布特征与应用逻辑,既能精准甄别异常数据、优化数据质量,又能深度挖掘数据分布规律、洞察业务特征,为后续的数据统计、模型分析和商业决策提供坚实可靠的数据支撑。
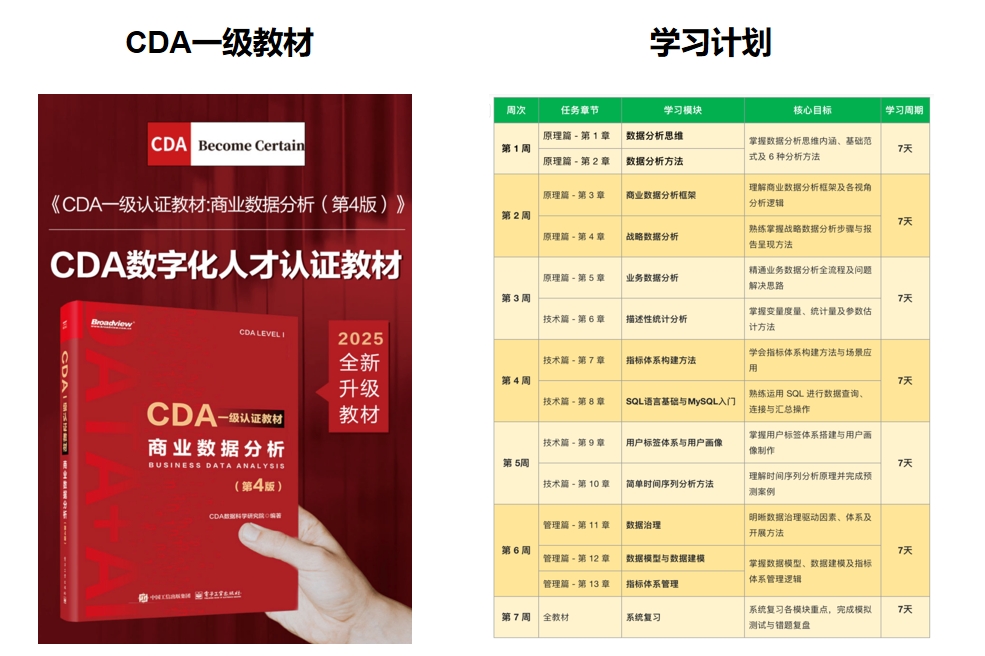
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330