很多数据分析师每天都在写 SQL,但当被问到“DQL 的本质是什么”“SELECT 子句的书写顺序与执行顺序为何不同”“INNER JOIN 和 LEFT JOIN 各自适合什么业务场景”时,却常常语焉不详。在企业的真实数据环境中,绝大多数数据获取工作依赖数据查询语言完成——掌握它,是数据分析师从“被动等待取数”走向“主动掌控分析”的关键一步。
”
引言:为什么数据查询语言是数据分析师的“效率加速器”?
小林是一名数据分析师。过去遇到分析需求,他的第一反应是“把数据导出到 Excel 再处理”,每次处理几万行数据就会卡顿,多表关联时更是心力交瘁。直到他开始系统学习 SQL,才发现:原本需要半小时的手工筛选和汇总工作,用 DQL 十分钟就能完成;原本需要多次打开 Excel 文件完成的复杂关联,在数据库中只需要一条查询语句。
数据查询语言(Data Query Language,DQL) 是用于从数据库中检索、筛选、整合数据的编程语言,其中 SQL(结构化查询语言)是行业通用标准,覆盖大量企业级数据库。对 CDA 分析师而言,SQL 不仅是“获取数据的工具”,更是“打通数据与业务分析”的关键链路——熟练掌握 SQL,能让分析师减少对“技术部门取数”的依赖,实现“需求到数据”的快速响应。
本文将从 CDA 认证的知识体系出发,系统解析 DQL 的模块定位、语法要点、常见子句功能与实战应用,帮助你从“会写 SELECT”进阶到“精通数据查询”。
一、DQL 的核心认知:以 SQL 为核心的“数据交互工具”
1. SQL 的四大分类
SQL 按功能可分为四大模块。数据分析师的工作重心集中在 DQL(核心)与 DML(辅助):
| 模块类型 |
全称 |
核心功能 |
常用操作 |
应用场景 |
| DQL |
数据查询语言 |
从数据库中检索、筛选、聚合数据 |
SELECT、WHERE、GROUP BY、JOIN、ORDER BY、LIMIT |
数据提取、多维度分析、指标计算 |
| DML |
数据操作语言 |
插入、更新、删除数据 |
INSERT、UPDATE、DELETE |
数据清洗、中间表数据写入 |
| DDL |
数据定义语言 |
创建、修改、删除表/视图 |
CREATE TABLE、CREATE VIEW |
基础数据载体搭建 |
| DCL |
数据控制语言 |
权限管理 |
GRANT、REVOKE |
数据安全管控 |
DQL 的核心定位是 “从数据库中精准提取所需数据”——它负责进行数据查询而不会对数据本身进行修改。DQL 返回的查询结果是存储在内存中的虚拟结果集,所以在 DQL 中执行的筛选、计算、排序等操作,都不会影响真实表中的数据。
2. DQL 的核心价值
对分析师而言,无需掌握 SQL 的全部模块,只需聚焦“与数据查询、处理强相关”的核心功能,即可满足大部分分析需求。DQL 的核心价值体现在三个层面:
- 效率提升:原本需要多次手工筛选和汇总的工作,在数据库中一条查询语句即可完成
- 自主取数:减少对技术团队取数的依赖,实现“需求到数据”的快速响应
- 精准定位:通过条件筛选、分组聚合、多表关联,精准获取分析所需的数据子集
不同于数据库管理员需要深耕 SQL 的底层开发与优化,CDA 数据分析师对 SQL 的核心要求是 “熟练、精准、高效”——能够根据分析需求,编写简洁的查询语句,精准提取数据、处理数据。
二、单表查询的“四步解析法”:从数据定位到精准筛选
单表查询是数据分析中最基础也最高频的 SQL 操作场景。CDA 大纲要求从四个维度掌握:选取列(定位数据范围)、条件筛选(缩小数据范围)、分组聚合(汇总计算)、排序分页(呈现结果)。
1. 选取需要的列:SELECT 与 FROM
最简单的查询语法为“SELECT 列名1, 列名2 FROM 表名”。DQL 语句至少应包括 SELECT 和 FROM 两部分,其他部分如 WHERE、GROUP BY、ORDER BY 等都是可选的。
DQL 语句的完整语法:
SELECT <字段名列表>
FROM <表名>
[WHERE <查询条件>]
[GROUP BY <分组字段列表>]
[HAVING <筛选条件>]
[ORDER BY <排序字段列表>]
[LIMIT 偏移量];
实战中建议遵循“按需选取”原则,只查询分析所需的字段,而非使用 SELECT * 扫描整张表,以减轻数据库负担、提升查询效率。通过 AS 关键字可以为字段设置别名,便于后续引用和结果集的可读性。
2. 筛选符合条件的行:WHERE 条件过滤
WHERE 子句用于筛选满足条件的行,支持多条件组合(AND/OR)、范围查询(BETWEEN)、集合查询(IN)、空值查询(IS NULL)以及模糊查询(LIKE)。
比较运算符包括 =、>、<、>=、<=、<>;逻辑运算符包括 AND、OR、NOT。
3. 分组汇总与筛选:GROUP BY 与 HAVING
GROUP BY 子句是单表查询中最能体现分析价值的关键操作,用于将数据按指定列分组,配合聚合函数为每个组计算摘要统计信息。
CDA 要求掌握的聚合函数:
在 SQL 中,WHERE 子句不能直接使用聚合函数。HAVING 子句在数据分组之后对分组结果进行筛选。
???? CDA 高频考点——WHERE 与 HAVING 的区别:WHERE 在数据分组之前筛选原始数据行,不能使用聚合函数;HAVING 在数据分组之后筛选分组后的结果,可以使用聚合函数。
4. 排序与限制:ORDER BY 与 LIMIT
ORDER BY 子句在查询的最后阶段对结果集进行排序(ASC 升序/DESC 降序)。如果指定了多个字段,则按字段的先后顺序依次排序。
LIMIT 子句用于限制返回的记录数。在 CDA 考试中,LIMIT 的语法和用法是应用层级的考点。
三、SQL 书写顺序 vs 执行顺序:正确理解两者的差异
理解 SQL 的实际执行顺序是编写复杂查询时避免逻辑错误的关键。SQL 语句的书写顺序与实际执行顺序存在差异。
书写顺序:SELECT → FROM → WHERE → GROUP BY → HAVING → ORDER BY → LIMIT
执行顺序:FROM → WHERE → GROUP BY → HAVING → SELECT → ORDER BY → LIMIT
这一顺序解释了为什么 WHERE 子句中不能使用 SELECT 中定义的别名——因为 WHERE 在 SELECT 执行之前;也解释了为什么 ORDER BY 可以使用别名——因为 ORDER BY 在所有表达式计算之后执行。
四、多表关联查询:打通数据孤岛的“连接器”
在企业真实业务中,数据分析往往需要关联多张表。
1. 连接方式选择与实战场景
| 连接类型 |
核心逻辑 |
业务实战场景 |
CDA 选择建议 |
| INNER JOIN(内连接) |
返回两表中匹配的数据,像“取交集” |
查询“既有用户信息又有订单记录”的数据 |
只关心双方都有匹配记录时推荐 |
| LEFT JOIN(左连接) |
保留左表全部记录,右表无匹配时显示 NULL |
查询“所有用户”——即使他们尚未下过订单 |
左表为核心主表时推荐 |
| RIGHT JOIN(右连接) |
保留右表全部记录 |
与 LEFT JOIN 对称 |
建议优先使用 LEFT JOIN |
| FULL JOIN(全连接) |
返回两张表的全部信息 |
需要保留两表全部记录时 |
不常用,但需了解 |
多表连接的底层逻辑是通过主键/外键关联,把分散在不同业务表中的数据按连接条件“拼”在一起。在考试中,多表连接题往往与 GROUP BY 聚合计算组合出现。
2. 多表连接
- INNER JOIN:基于某个条件(通常是主键和外键的关系)来匹配两个表中的记录,结果集只包含满足连接条件的记录
- LEFT JOIN:返回左表的所有记录,以及右表中满足连接条件的记录。如果右表中没有匹配的记录,则结果中包含左表的记录,并且右表的字段为 NULL
- 当两个表的对应关系为多对多时,内连接的结果只显示两表中满足条件的记录
五、子查询与集合操作:复杂分析的“高级武器”
1. 子查询
子查询指在一个 SELECT 语句的内部嵌套另一个 SELECT 语句。当面对类似“找出那些下单金额大于本月平均订单金额的用户”这类复杂分析时,往往需要“套两层”查询逻辑。
子查询通常与 IN、NOT IN、EXISTS 等关键字组合使用。在 CDA 考试中,子查询属于应用层级的考点。
2. 集合操作:UNION 与 UNION ALL
当需要将多个结构相同的查询结果上下拼接时,使用 UNION 或 UNION ALL。
| 操作符 |
去重行为 |
排序行为 |
选择场景 |
| UNION |
去除重复行 |
结果集去重后排序 |
统计合并多个渠道的唯一记录 |
| UNION ALL |
保留重复行 |
不排序,直接拼接 |
处理海量数据时优先考虑 |
六、实战演练:从业务需求出发的 SQL 全流程
背景
某电商平台需要分析近 3 个月各地区分产品品类的销售情况,输出“各城市已支付订单 GMV 大于 10 万元的城市及其总 GMV”。数据库中有三张核心表:用户表(user,主键 user_id)、订单表(orders,主键 order_id,含 user_id 外键)、商品表(product,主键 product_id)。
完整操作流程
第一步:多表关联(INNER JOIN)
将用户表与订单表按 user_id 关联,再通过 product_id 关联商品表。
第二步:筛选与分组汇总(WHERE + GROUP BY)
用 WHERE 在聚合前筛选近 3 个月的已支付订单数据,使用 GROUP BY 按城市分组汇总订单金额。
第三步:分组筛选与排序输出(HAVING + ORDER BY)
用 HAVING 筛选出 GMV 大于 10 万元的城市,最后用 ORDER BY 按 GMV 降序排列。
这就是一套“数据连接 → 条件筛选 → 分组汇总 → 分组筛选 → 排序输出”的 DQL 全链路实战流程。
”
结尾
很多数据分析师能写简单的 SELECT * FROM,但当被问到“WHERE 和 HAVING 有什么区别”“INNER JOIN 和 LEFT JOIN 分别适用什么场景”“SQL 的书写顺序与实际执行顺序为何不同”时,却答不上来。
掌握数据查询语言不仅是技术能力的体现,更是业务洞察能力的基础保障——只有在数据获取环节做到准确、高效、灵活,后续的数据分析与决策才有坚实的数据基础。
在 2025 年新考纲的背景下,数据查询语言作为数据库应用模块的核心内容,贯穿数据接入、清洗、分析、输出的全过程,是连接原始数据库与商业洞察的核心桥梁。CDA 一级要求考生从领会 SQL 基本语法,到熟知条件筛选与去重,再到应用多表连接、分组汇总与子查询——这套完整的能力体系,正是数据分析师从“会取数”走向“懂分析”的必经之路。
下一步行动:
- 在日常数据集上练习多表
JOIN 的三种连接类型,比较并理解数据量变化规律 - 使用
GROUP BY + HAVING + ORDER BY + LIMIT 组合完成一次分组汇总再筛选的综合查询 - 弄清楚
INNER JOIN 与 LEFT JOIN 在数据完整性上的本质区别以及各自适用的业务分析场景
数据查询语言是数据分析师撬动企业数据资产的“通用钥匙”。精准掌握它,就能在数据海洋中快速锁定目标,让每一次查询都成为驱动业务决策的精准力量。
”
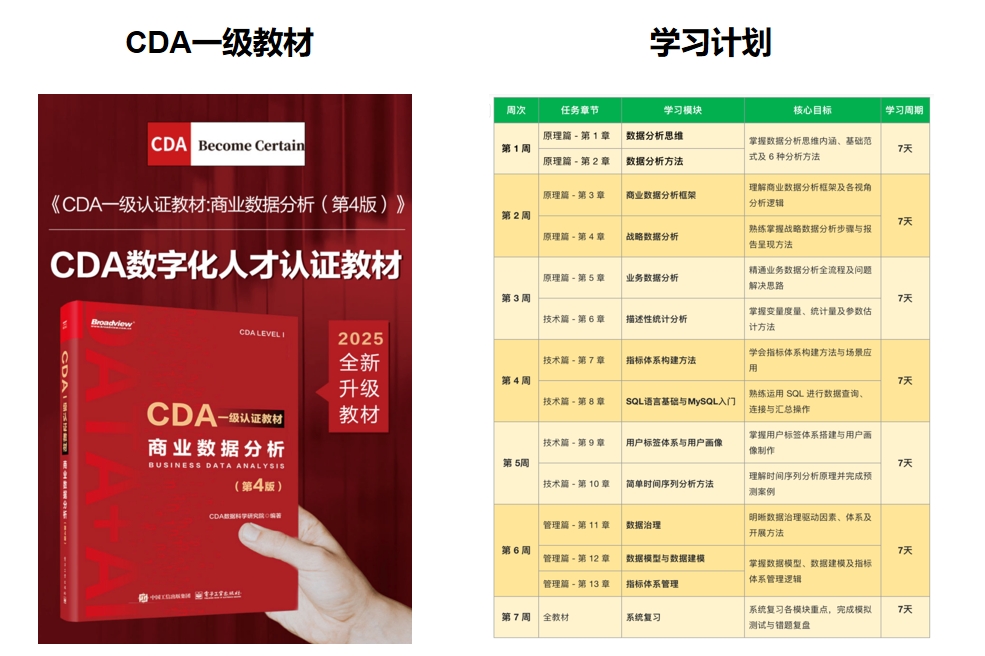
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330