解析 LSTM 训练后输出不确定:成因与破解之道
在深度学习处理序列数据的领域,长短期记忆网络(LSTM)凭借其捕捉长距离依赖关系的独特能力,成为自然语言处理、时间序列预测、语音识别等任务的核心工具。然而,在实际应用中,许多开发者会遇到一个棘手问题:LSTM 训练完成后,对相同或相似输入的输出结果常常存在波动,这种 “输出不确定” 现象严重影响了模型的可靠性,尤其在金融预测、工业故障预警等对精度要求极高的场景中,可能导致决策偏差甚至风险。深入探究 LSTM 输出不确定的成因,并针对性地提出解决方案,成为提升模型实用性的关键。
一、LSTM 输出不确定的核心成因
LSTM 输出的不确定性并非单一因素导致,而是数据、模型、训练过程及任务特性共同作用的结果,需要从多维度拆解其本质。
(一)数据层面:序列质量与分布波动
数据是模型学习的基础,其质量和分布直接影响 LSTM 的输出稳定性。在时间序列预测任务中,若原始数据包含大量噪声(如传感器采集的工业数据中的随机干扰)、缺失值(如用户行为序列中的断连记录)或异常值(如金融数据中的突发极端波动),LSTM 在学习过程中会将这些 “噪声信号” 误判为有效模式,导致模型学到的规律掺杂随机性。此外,序列长度不一致或分布偏移也会加剧不确定性:当训练数据与测试数据的序列分布存在差异(如季节性时间序列的训练集未覆盖完整周期),模型对新输入的适配性下降,输出自然出现波动。例如,用某电商平台上半年的销售数据训练 LSTM 预测下半年销售额时,若未考虑 “618”“双十一” 等大促节点的分布差异,模型对促销期间的销量预测就会出现较大偏差。
(二)模型层面:结构设计与参数敏感性
LSTM 的网络结构设计和参数设置对输出稳定性影响显著。从结构上看,LSTM 通过遗忘门、输入门和输出门控制信息流动,门控机制的参数(如权重和偏置)初始值若采用随机初始化,可能导致不同训练轮次中模型收敛到不同的局部最优解,进而对相同输入产生不同输出。隐藏层维度设置不当也会引发问题:维度过小会导致模型拟合能力不足,无法捕捉序列深层规律,输出易受噪声影响;维度过大则可能引发过拟合,模型过度记忆训练数据中的细节甚至噪声,在测试时对微小输入变化过度敏感。此外,激活函数的选择也暗藏风险,例如使用 tanh 激活函数时,若输入值落在梯度接近零的饱和区域,参数更新缓慢,模型收敛不稳定,最终输出呈现不确定性。
(三)训练过程:优化动态与收敛状态
训练过程的动态特性是导致输出不确定的另一关键因素。梯度下降优化算法的随机性会直接影响训练轨迹:随机梯度下降(SGD)每次迭代使用随机采样的 mini - batch 数据,不同批次数据的噪声可能导致参数更新方向波动,即使最终收敛到相近的损失值,参数细微差异也会累积为输出偏差。学习率设置不合理会加剧这一问题:学习率过高可能导致参数在最优解附近震荡,无法稳定收敛;学习率过低则会延长训练时间,增加陷入局部最优的概率。过拟合与欠拟合的失衡同样不容忽视:过拟合的模型在训练集上表现优异,但对新数据泛化能力差,输出随输入微小变化剧烈波动;欠拟合的模型则因未学到核心规律,输出呈现无规律的随机性。例如,在文本生成任务中,过拟合的 LSTM 可能对相同开头生成截然不同的句子,而欠拟合的模型生成的文本则逻辑混乱、重复率高。
(四)任务特性:序列随机性与歧义性
部分序列任务的固有特性本身就蕴含不确定性,LSTM 的输出波动可能是对这种特性的客观反映。在自然语言处理中,文本序列存在天然歧义性,同一语义可通过多种表达方式实现,LSTM 在生成文本时,可能基于概率分布选择不同词汇组合,导致输出变化。时间序列预测中,许多现象受随机因素影响(如股票价格受突发政策、市场情绪等不可控因素影响),即使模型学到了主要趋势,也难以完全消除随机波动带来的预测偏差。例如,用 LSTM 预测城市每日降雨量时,由于气象系统的复杂性和随机性,模型输出的降雨量数值出现一定范围的波动是正常现象,这种不确定性源于任务本身而非模型缺陷。
二、破解 LSTM 输出不确定性的实践策略
针对 LSTM 输出不确定的成因,需从数据预处理、模型优化、训练调控和不确定性量化四个维度制定解决方案,提升模型输出的稳定性与可靠性。
(一)数据预处理:夯实序列质量基础
数据预处理是降低不确定性的第一道防线。针对噪声问题,可采用滑动平均、小波变换等方法对序列数据进行平滑处理,或通过异常检测算法(如孤立森林、DBSCAN)识别并修正异常值,减少无效信号对模型的干扰。对于缺失值,根据序列特性选择合理填充方式:时间序列可采用线性插值或前向填充,文本序列可通过上下文语义预测填充。为解决分布偏移问题,需在数据采集阶段确保训练集覆盖完整的序列周期和场景,必要时采用数据增强技术扩展样本多样性,如对时间序列进行时间平移、幅度缩放等变换,增强模型对分布变化的适应性。例如,在预测电网负荷时,通过加入不同季节、不同节假日的负荷数据,并对极端天气下的样本进行增强,可显著提升 LSTM 预测的稳定性。
优化模型结构和参数设置是提升输出稳定性的核心。在结构设计上,可采用分层预训练策略:先使用简单模型(如 GRU)或预训练的词向量初始化 LSTM 参数,减少随机初始化带来的偏差;合理调整隐藏层维度,通过交叉验证确定 “欠拟合” 与 “过拟合” 的平衡点,例如在用户行为序列预测中,可从较小维度(如 64 维)开始逐步增加,观察验证集损失变化。正则化技术能有效抑制过拟合,在 LSTM 中引入 dropout 层(在训练时随机丢弃部分神经元)或 L2 正则化(对参数施加惩罚项),可降低模型对噪声的敏感性;对于门控机制,可采用正交初始化参数,确保梯度稳定传播。激活函数的选择需结合任务特性,例如在回归任务中,用 ReLU 替代 tanh 可减少梯度消失问题,提升训练稳定性。
(三)训练调控:优化策略与收敛保障
稳定的训练过程是模型输出可靠的关键。优化算法的选择需兼顾效率与稳定性:Adam、RMSprop 等自适应学习率算法可动态调整参数更新步长,减少 SGD 的随机性影响;在训练后期切换为较小学习率的 SGD,可帮助模型精细收敛到最优解。早停法(Early Stopping)是防止过拟合的有效工具:通过监控验证集损失,当损失连续多轮不再下降时停止训练,避免模型过度学习噪声。此外,增加训练轮次或采用更大的 batch size 可降低参数更新的随机性:较大的 batch size 能平滑 mini - batch 数据的噪声,使参数更新方向更稳定,但需平衡内存消耗;足够的训练轮次则确保模型充分收敛,减少不同训练过程的偏差。例如,在语音识别任务中,将 batch size 从 32 增至 64,并延长训练轮次至验证集损失稳定,可显著降低识别结果的波动。
(四)不确定性量化:从被动接受 to 主动掌控
除降低不确定性外,量化不确定性本身也是提升模型实用性的重要手段。蒙特卡洛 dropout(Monte Carlo Dropout)通过在推理阶段保持 dropout 层开启,多次运行模型获取输出分布,用分布的标准差衡量不确定性:标准差越大,输出可靠性越低,可在金融预测中用于标记高风险预测结果。贝叶斯 LSTM 则从概率角度建模参数不确定性,将参数视为随机变量并估计其 posterior 分布,输出结果不仅包含预测值,还附带置信区间,为决策提供更全面的参考。例如,在医疗时序数据预测中,贝叶斯 LSTM 可给出患者病情恶化概率的置信区间,帮助医生评估预测风险。
三、总结:在不确定中寻找确定性
LSTM 输出的不确定性是数据、模型、训练过程等多因素交织的结果,但其并非不可控。通过夯实数据质量、优化模型结构、调控训练过程和量化不确定性,开发者可显著提升 LSTM 输出的稳定性。在实际应用中,需结合具体任务特性制定针对性方案:金融时间序列预测需重点强化数据平稳性和模型正则化;自然语言生成则可通过量化不确定性标记高歧义输出。正如数据分析中 “用数据驱动决策” 的核心逻辑,应对 LSTM 的不确定性也需以实验为依据 —— 通过对比不同策略的效果,找到最适合当前场景的解决方案,让 LSTM 在序列数据处理中真正发挥 “稳定捕捉规律” 的核心价值。
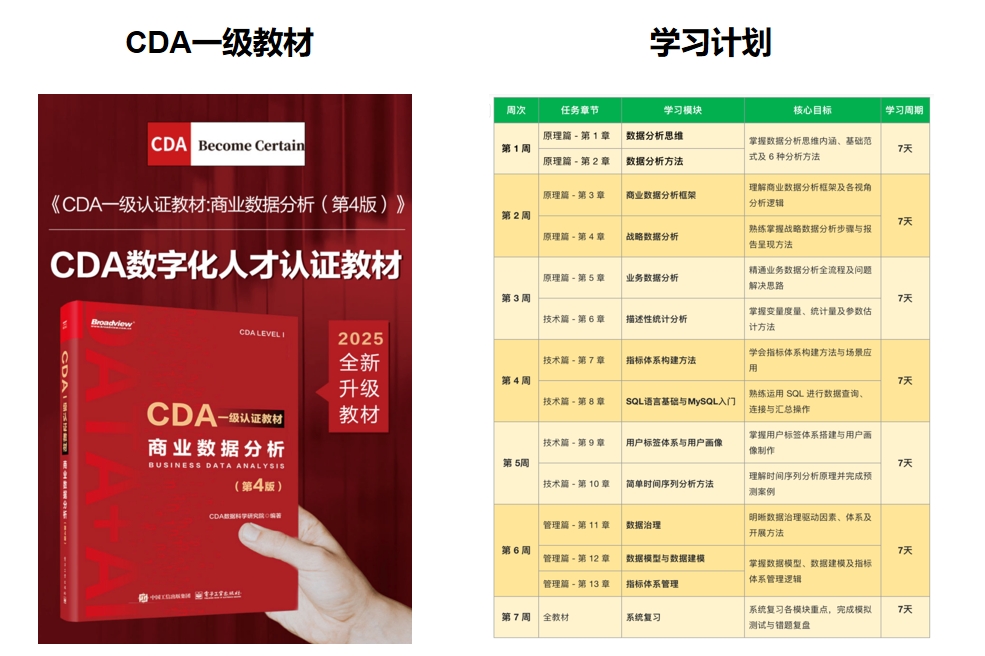
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330