在数据分析工作流中,业务数据大多存储在各类关系型数据库内,例如MySQL、PostgreSQL、SQLite等。Pandas是Python生态中主流的数据处理库,DataFrame作为其核心数据结构,支持筛选、聚合、统计、可视化等丰富的数据操作。将数据库中的数据表读取并转换成Pandas DataFrame,是打通数据库存储与离线数据分析的关键环节。通过这种转换,可以把数据库里结构化表格数据加载到内存,借助Pandas灵活完成数据清洗、特征加工、统计分析,无需反复在数据库中编写复杂SQL。本文将介绍转换原理、主流实现方案、实操流程、性能优化以及常见问题。
数据库以数据表的形式持久化存储数据,数据保存在磁盘中;而Pandas的DataFrame是内存中的二维表格对象,包含行索引、列名与单元格数据。整个转换过程本质分为两步:第一步建立Python客户端与数据库的连接,通过SQL查询语句从数据库表中取出目标数据集;第二步将查询返回的结果集连同字段名称一起送入Pandas,直接映射生成DataFrame。数据表的字段对应DataFrame的列,数据表的每一条记录对应DataFrame的一行。整个过程不需要中间导出CSV文件,能够直接流式拉取数据,减少文件导出带来的额外操作与数据安全风险。
二、主流技术方案与实操流程
1. SQLite数据库:内置驱动直接读取
SQLite属于文件型数据库,Python自带sqlite3驱动,无需额外安装数据库客户端。先建立数据库连接,编写SELECT查询语句,使用pandas的read_sql函数,传入SQL语句和数据库连接对象,即可直接返回DataFrame。该方式适合本地小型数据库文件的快速分析,操作简便,不需要账号与端口配置。
2. MySQL数据库:借助SQLAlchemy引擎读取(推荐方案)
MySQL是业务场景使用最多的关系库,行业推荐采用SQLAlchemy构建数据库引擎,再调用read_sql读取数据表。相比原生pymysql单独连接方式,SQLAlchemy引擎兼容性更强,支持多种数据库,代码复用性更高。执行时引擎会完成账号、密码、地址、端口、数据库名的连接配置,支持读取整张数据表,也支持执行筛选后的自定义SQL,只加载需要的部分字段与数据,避免全表读取浪费内存。
读取全表时可使用read_sql_table,只需要指定表名和数据库引擎,自动识别表字段作为DataFrame列;需要做过滤、关联、聚合时,则使用read_sql传入自定义SQL语句,提前在数据库层完成数据筛选,减少传输的数据量。
PostgreSQL、Oracle等数据库,同样可以基于SQLAlchemy引擎实现转换,只需要更换连接字符串内对应的驱动,整体代码结构保持一致,便于在不同数据库环境之间迁移分析脚本。
三、关键优化策略
当数据库表数据量较大时,如果一次性将全表加载进内存,容易出现内存溢出、读取缓慢等问题。Pandas支持分块读取,通过chunksize参数,把数据库结果集分批读取,每次生成一小块DataFrame,循环处理数据,降低内存占用。
同时应当遵循“数据库侧提前过滤”原则,尽量在SQL语句中完成WHERE筛选、字段选取、聚合计算,而不是把全表读到DataFrame之后再做过滤。数据库针对索引查询做了优化,在数据库端提前精简数据,能够大幅降低网络传输压力与Python内存消耗。此外,可指定dtype参数,在读取阶段直接设置DataFrame列的数据类型,减少后续类型转换的开销。
四、常见问题与解决方案
第一类问题为数据库连接异常,包括账号密码错误、端口不通、数据库远程访问未开启,需要优先检查网络与账号权限。第二类是字段类型映射异常,数据库中的日期、布尔、大数字类型,转换后可能出现object类型,需要读取后进行类型转换。第三类是数据量过大造成内存不足,优先使用分块读取,或者修改SQL只查询必要字段。第四类为中文乱码问题,在数据库连接字符串中指定编码,例如utf8mb4,解决中文内容读取乱码。
另外需要注意,DataFrame存在于内存中,转换得到的数据只是数据库表的一份快照。对DataFrame内数据的修改,不会自动同步回数据库;如果需要写回数据库,需要使用to_sql方法,单独执行写入操作。
五、应用场景总结
数据库表转DataFrame是数据分析流水线的基础环节,广泛用于业务报表离线统计、用户行为数据分析、实验数据处理、数据质量校验等场景。相比先导出Excel、CSV再读取文件的方式,直连数据库生成DataFrame更加高效,能够实现自动化脚本定时拉取数据,适配自动化数据分析任务。
六、结语
将数据库表转换为Pandas DataFrame,打通了数据库存储与Python数据分析的链路。借助SQLAlchemy与Pandas内置读取函数,可以简洁高效地完成数据加载。在实际项目中,需要结合数据规模选择一次性读取或者分块读取,合理利用SQL提前筛选数据,规避内存、类型、连接等常见问题,充分发挥数据库存储能力与Pandas数据处理能力各自的优势,支撑后续清洗、统计、建模等数据分析工作。
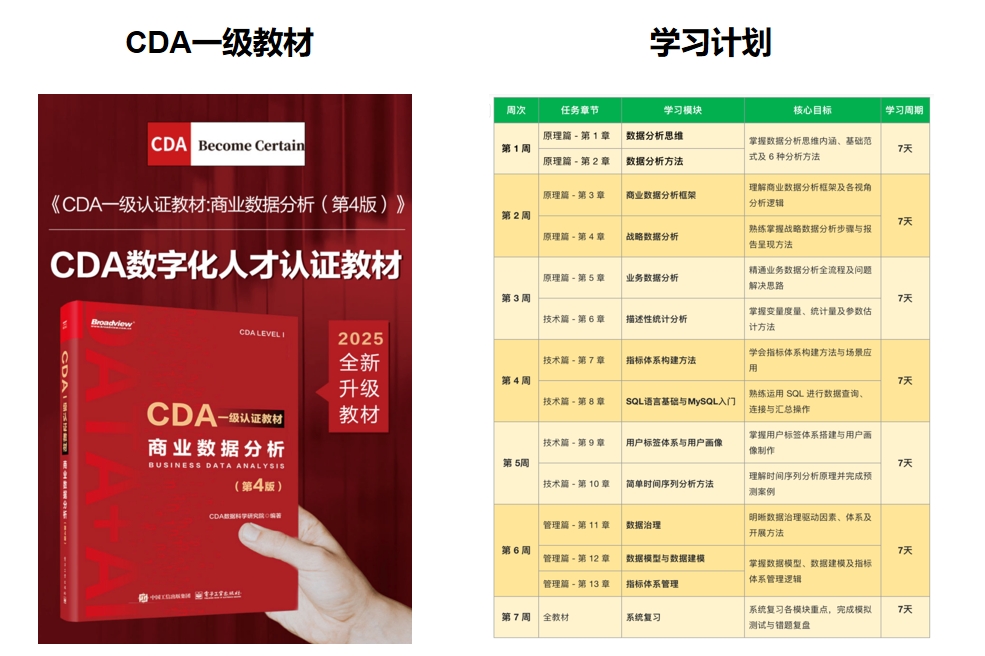
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330