在数理统计与数据分析领域,多因素方差分析与线性回归模型是研究变量关系、因素影响、数据差异规律的两大核心工具。二者均属于经典的线性统计模型,广泛应用于实验数据分析、业务指标归因、变量相关性探究、预测建模等场景。但在核心功能、变量类型、分析目标与输出结果上存在本质区别:多因素方差分析侧重检验分类因素对结果的差异性影响,线性回归侧重探究自变量与因变量之间的量化预测关系。本文将系统阐述两种模型的基本原理、标准化分析流程、实战应用场景,并对比二者的异同与选用逻辑,为数据分析建模提供科学依据。
一、多因素方差分析原理与完整分析流程
(一)核心定义与原理
多因素方差分析(Multi-factor ANOVA)是在单因素方差分析基础上延伸的统计方法,用于同时研究两个及以上分类自变量对连续型因变量的影响。其核心原理是通过数据方差拆解,将总体数据波动拆分为:各因素导致的组间波动、因素交互作用波动、随机误差波动。
通过F检验判断各因素及交互作用对结果是否存在显著统计学差异,简单来说,多因素方差分析主要解决:哪些因素会显著影响指标、不同因素水平是否存在差异、多因素之间是否存在协同或拮抗交互作用。模型自变量为分类变量,如性别、渠道、版本、实验组别、地区;因变量为连续数值,如销量、时长、分数、产值。
(二)标准化分析流程
第一步:数据前提检验
多因素方差分析有严格的数据适用前提,需提前检验:数据服从正态分布、各组方差齐性、样本独立无关联。不满足前提会导致检验结果失效,需提前进行数据清洗与正态化处理。
第二步:模型构建与方差拆解
构建包含主效应与交互效应的多因素模型,将总方差拆解为:因素A主效应、因素B主效应、AB交互效应、随机误差,完成数据波动来源拆分。
第三步:显著性F检验
计算各因素对应的F值与P值,以显著性水平0.05为判断标准:P<0.05代表该因素对结果存在显著影响;P>0.05代表影响不显著。同时判断交互效应是否显著,区分独立影响与联动影响。
第四步:事后多重比较
若主效应显著,需通过LSD、Tukey等事后检验,进一步判断具体哪两组水平存在差异,精准定位差异来源,避免仅知道“有差异”但不知“哪里有差异”。
第五步:结果解释与结论输出
汇总各因素显著性、交互作用、差异对比结果,明确影响因变量的核心关键因素,解释数据差异成因,完成实验或业务归因分析。
(三)典型应用场景
多因素方差分析多用于实验类、对比类数据分析:不同渠道、不同时间段、不同运营策略对销量的影响分析;不同教学方法、不同性别对成绩的差异研究;不同工艺参数、不同批次对产品质量的显著性影响;多变量组合实验的交互效果验证。
二、线性回归模型原理与完整分析流程
(一)核心定义与原理
多元线性回归模型是用于刻画自变量与连续因变量之间量化线性关系的预测模型。其核心原理是通过最小二乘法拟合最优回归方程,求解各自变量的回归系数,量化每一个自变量对因变量的影响大小、正负方向与贡献程度。
多元线性回归模型公式:
其中y为因变量,x为各影响自变量,β为回归系数,ε为随机误差。线性回归不局限于分类变量,既支持分类自变量,也支持连续自变量,核心目标是量化影响、构建公式、预测结果。
(二)标准化分析流程
第一步:数据预处理与相关性检验
清洗异常值、缺失值,避免脏数据干扰拟合效果;通过相关性矩阵筛选有效变量,剔除高度共线性变量,防止模型失真、系数紊乱。
第二步:构建多元回归模型
将筛选后的自变量纳入模型,通过最小二乘法拟合回归方程,计算截距与各变量回归系数。
第三步:模型整体与参数显著性检验
通过F检验判断模型整体是否显著,通过T检验判断单个自变量是否对因变量有显著影响;同时查看R²拟合优度,判断模型对数据的解释能力,R²越接近1,模型拟合效果越好。
第四步:模型优化与变量筛选
剔除不显著变量、处理多重共线性、优化模型结构,保留核心有效变量,提升模型稳定性与解释性。
第五步:结果解释与预测应用
根据回归系数解释变量影响规律:系数为正代表正向促进,系数为负代表负向抑制,系数绝对值代表影响权重。最终利用模型实现数据预测、指标推演、权重分析。
(三)典型应用场景
线性回归多用于预测类、量化归因场景:销量、营收、用户指标的影响因素量化与预测;房价、物价、产能等连续指标的建模预估;各维度变量对核心指标的权重贡献分析;业务指标趋势推演与数值预测。
三、多因素方差分析与线性回归模型核心区别
1. 分析目标不同
多因素方差分析的核心是检验差异是否显著,回答“因素是否对结果有影响、组间是否存在差异”,侧重统计推断与差异验证;线性回归的核心是量化关系与预测,回答“影响有多大、如何影响、未来数值是多少”,侧重量化建模与趋势预测。
2. 变量类型不同
多因素方差分析的自变量必须是分类变量,如组别、性别、策略、地区;线性回归自变量可以是连续变量,也可以是分类变量,数据适配范围更广。二者因变量均为连续数值变量。
3. 输出结果不同
多因素方差分析输出P值、F值、显著性差异结论、交互效应结果,无量化计算公式;线性回归输出回归系数、拟合方程、R²、预测数值,可直接用于量化计算与未来预测。
4. 研究侧重点不同
多因素方差分析适合实验对比、差异分析、归因验证;线性回归适合权重分析、规律建模、趋势预测。
四、模型选用实战原则
在数据分析实战中,可根据分析目标快速选用模型:若研究多组实验、多分类因素是否带来数据差异,验证因素有效性,优先使用多因素方差分析;若需要量化各因素影响大小、构建计算模型、预测未来指标数值,优先使用多元线性回归。
同时两种模型可以互补使用:先通过多因素方差分析筛选出对指标有显著影响的关键分类因素,再将显著因素纳入线性回归模型,完成影响权重量化与预测建模,实现“差异验证+量化分析”的完整分析闭环。
五、总结
多因素方差分析与线性回归模型是数据分析中互补且不可替代的两大线性模型。多因素方差分析以方差拆解与显著性检验为核心,聚焦多分类因素的差异影响与交互作用验证,适用于实验对比与归因分析;线性回归模型以最小二乘拟合为核心,聚焦变量间的量化关系与趋势预测,适用于权重分析与数值建模。
熟练掌握两种模型的原理、流程与适用场景,精准区分二者的使用边界,能够解决绝大多数数据归因、差异分析、指标预测类问题,为数据挖掘、实验分析、业务决策、模型训练提供扎实的统计支撑。
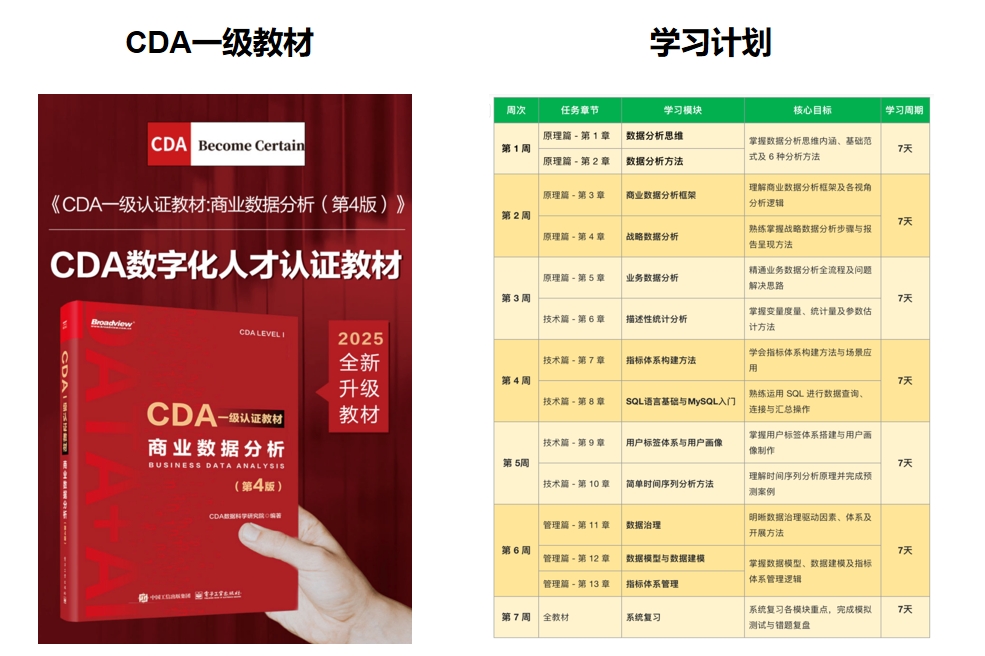
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330