机器学习算法工程的核心价值,在于将理论算法转化为可落地、可复用、高可靠的工程化解决方案,解决实际业务中的痛点问题。不同于纯算法研究,工程落地更注重“实用性、稳定性、可扩展性”——既要选择适配业务场景的算法,也要兼顾数据质量、部署效率、成本控制与运维便捷性。
当前,机器学习已深度融入科研与产业全链条,中国在机器学习科研应用领域已位居全球前列,相关算法广泛应用于医疗、工业、自动驾驶、环境监测等多个场景[1]。本文精选4个机器学习算法工程实用案例,覆盖分类、回归、聚类、深度学习等核心算法,拆解从需求分析、数据处理、模型构建到部署优化的完整流程,提炼工程落地关键技巧与避坑经验,助力从业者快速将算法转化为实际价值。
一、案例一:工业设备故障诊断——基于XGBoost的预测性维护(分类任务)
1.1 业务需求与痛点
某大型制造企业的生产线上,多台工业机器人长期高负荷运行,传统故障排查依赖人工巡检,存在“漏检率高、响应滞后、维护成本高”等问题:设备突发故障会导致生产线停工,单次停工损失超10万元;人工巡检需投入大量人力,且难以提前预判潜在故障。
核心需求:基于设备运行数据,构建机器学习模型,提前72小时预测设备故障风险,实现“预测性维护”,降低故障发生率与维护成本。
1.2 数据处理(工程落地核心前提)
数据来源:设备传感器采集的实时运行数据(每10分钟采集一次),包括电机电流、振动频率、表面温度、运行时长、负载压力等12个特征,标签为“正常”“轻微异常”“严重异常(故障)”。
工程化数据处理步骤(关键优化):
缺失值处理:采用“前后均值填充+异常值剔除”,避免因传感器故障导致的缺失数据影响模型;对连续3次以上缺失的传感器数据,标记为“数据异常”,单独处理。
异常值处理:通过箱线图识别异常值(如电流突增、温度骤升),结合设备运行日志,区分“真实异常”与“传感器误报”,真实异常保留作为训练样本,误报数据修正后再利用。
特征工程:新增“滑动窗口统计特征”(如过去1小时内的平均振动频率、温度最大值),增强特征的时序关联性;通过相关性分析,剔除与故障无关的冗余特征(如环境湿度,相关性<0.1),降低模型复杂度。
数据划分:按7:2:1划分训练集、验证集、测试集,确保测试集与真实业务场景数据分布一致(如包含不同运行负荷、不同设备型号的数据)。
1.3 模型构建与工程优化
算法选择:优先选用XGBoost分类算法,原因是其对结构化数据适配性强、训练速度快、可解释性优于深度学习模型,且能有效处理类别不平衡问题(故障样本占比仅5%)。
工程化优化技巧:
类别不平衡处理:采用“过采样(SMOTE)+ 欠采样”结合的方式,提升故障样本的占比,同时避免过拟合;设置class_weight参数,对故障样本赋予更高权重。
超参数调优:通过GridSearchCV结合业务指标(故障召回率)调优,核心参数设置:max_depth=6,learning_rate=0.1,n_estimators=200,subsample=0.8,确保模型精度与泛化能力平衡。
模型可解释性优化:利用XGBoost的feature_importances_属性,筛选出影响故障的核心特征(如振动频率、电机电流),生成特征重要性报告,为维护人员提供参考。
1.4 部署与落地效果
部署方式:将模型封装为Python接口,通过Flask搭建轻量级服务,与企业设备监控系统对接,实时接收传感器数据,输出故障风险评分(0-100分),评分≥80分触发预警。
落地效果:设备故障发生率下降78%,单次故障响应时间从2小时缩短至15分钟,每月节省维护成本约80万元;模型泛化能力良好,在新增设备上的故障预测准确率达92%,符合工业场景的实际需求[1]。
二、案例二:医疗影像分割——基于U-Net的肿瘤精准识别(深度学习任务)
2.1 业务需求与痛点
某三甲医院放射科,医生需手动分割CT影像中的肿瘤区域,用于肿瘤分期、治疗方案制定,存在“分割效率低、主观性强、误差大”等问题:单张CT影像分割需耗时15-20分钟,日均处理百余张影像,医生工作负荷极大;不同医生的分割误差可达10%以上,影响治疗精度。
核心需求:构建深度学习模型,实现CT影像中肿瘤区域的自动精准分割,提升分割效率与一致性,辅助医生完成诊断工作。
数据来源:医院归档的CT影像数据(DICOM格式),共1000例患者,每例包含20-50层CT切片,标注由3名资深放射科医生共同完成,标签为“肿瘤区域”“正常组织区域”。
工程化数据处理步骤:
数据格式转换:将DICOM格式转换为PNG格式,提取影像灰度值,统一尺寸为512×512像素,便于模型处理。
影像预处理:采用“灰度归一化”(将灰度值映射至[0,1])、“高斯滤波去噪”,消除CT影像中的噪声干扰;对模糊、伪影严重的影像,进行图像增强(对比度调整、锐化),提升特征辨识度。
数据增强:由于医疗数据标注成本高、样本量有限,采用随机翻转、旋转、平移、缩放等增强方式,将样本量扩充至3000例,避免模型过拟合;同时采用“边界增强”,突出肿瘤边缘特征,提升分割精度。
标签处理:将分割标签转换为二值掩码(肿瘤区域为1,正常区域为0),确保模型输出与标签格式一致。
2.3 模型构建与工程优化
算法选择:选用U-Net深度学习架构,其编码-解码结构能有效捕捉影像的多尺度特征,适配医学影像分割任务,也是当前医学影像分割领域的主流架构[1][2]。
工程化优化技巧:
模型轻量化:考虑到医院服务器资源有限,将U-Net的卷积层数量精简,采用深度可分离卷积替代传统卷积,减少模型参数(从1000万+降至200万+),推理速度提升60%。
损失函数优化:采用Dice损失+交叉熵损失结合的方式,解决医学影像分割中“正负样本不平衡”(肿瘤区域占比低)的问题,提升肿瘤区域的分割召回率。
迁移学习:利用公开医疗影像数据集(如BraTS)预训练U-Net模型,再用医院本地数据微调,减少训练数据依赖,提升模型泛化能力,训练时间缩短40%。
2.4 部署与落地效果
部署方式:将模型转换为ONNX格式,集成到医院现有的影像诊断系统中,支持批量处理CT影像,自动生成分割结果,医生可手动微调,减少重复工作。
落地效果:单张CT影像分割时间缩短至10秒以内,日均处理效率提升10倍;分割准确率达95%,与医生手动分割的一致性达92%,有效减轻医生工作负荷,为肿瘤精准治疗提供了可靠支撑[1]。
三、案例三:环境污染物预测——基于LSTM的PM2.5浓度预报(回归任务)
3.1 业务需求与痛点
某环境监测部门需对辖区内PM2.5浓度进行精准预报,为大气污染治理提供决策支持,传统预报方法依赖气象模型,存在“预报精度低、滞后性强”等问题:短期(24小时)预报误差可达30%以上,无法及时为污染防控提供有效指导。
核心需求:基于历史监测数据与气象数据,构建时序预测模型,实现PM2.5浓度的小时级、百米级高时空精度预报,提前24小时预测浓度变化趋势[1]。
3.2 数据处理(时序任务工程重点)
数据来源:辖区内50个环境监测站的实时监测数据(每小时采集一次),包括PM2.5浓度、PM10浓度、二氧化硫、氮氧化物等污染物指标;同时采集气象数据(风速、风向、温度、湿度)、交通流量数据,共10万+条时序数据,时间跨度1年。
工程化数据处理步骤:
数据对齐:将不同来源的数据(监测站数据、气象数据、交通数据)按时间戳对齐,确保同一时间点的特征数据完整,避免时间错位导致的模型误差。
缺失值与异常值处理:采用“线性插值”填充缺失的监测数据,对超出合理范围的异常值(如PM2.5浓度为0或超过1000μg/m³),结合相邻监测站数据与气象条件修正,确保数据真实性。
时序特征工程:新增“时序滞后特征”(如过去6小时、12小时的PM2.5浓度)、“滑动平均特征”(过去24小时的平均浓度)、“气象关联特征”(风速与浓度的相关性特征),捕捉时序数据的趋势性与关联性。
数据归一化:对所有特征进行Z-score标准化,消除量纲差异(如PM2.5浓度与风速的单位不同),提升模型训练稳定性。
3.3 模型构建与工程优化
算法选择:选用LSTM时序神经网络,其能有效捕捉时序数据的长期依赖关系,适配PM2.5浓度的时间序列预测任务,也是时序预测领域的主流算法[2]。
工程化优化技巧:
序列长度优化:通过实验确定最优序列长度为24(即利用过去24小时的数据预测未来1小时的PM2.5浓度),平衡预测精度与计算成本。
模型正则化:加入Dropout层(dropout=0.3)、L1/L2正则化,避免模型过拟合;采用EarlyStopping策略,当验证集误差连续5轮不下降时停止训练,提升模型泛化能力。
多特征融合:将污染物数据、气象数据、交通数据进行融合训练,相比单一特征模型,预测精度提升15%;引入注意力机制,突出影响PM2.5浓度的核心特征(如风速、交通流量)。
3.4 部署与落地效果
部署方式:将LSTM模型部署到云端服务器,通过API接口对接环境监测平台,实时接收监测数据,输出未来24小时的PM2.5浓度预报结果(每小时更新一次),支持可视化展示。
落地效果:PM2.5浓度24小时预报准确率达88%,误差较传统方法下降40%;实现小时级、百米级高时空精度预报,为大气污染精准溯源与治理提供了强有力的科学支撑,助力辖区内PM2.5平均浓度下降12%[1]。
四、案例四:用户精准推荐——基于协同过滤与DeepFM的电商推荐系统(推荐任务)
4.1 业务需求与痛点
某电商平台拥有百万级用户与十万级商品,传统推荐方式采用“热门商品推荐”,存在“个性化不足、点击率低、转化率差”等问题:推荐商品与用户兴趣不匹配,点击率仅3%左右,用户留存率偏低。
核心需求:构建个性化推荐模型,结合用户行为数据与商品特征,为不同用户推荐符合其兴趣的商品,提升推荐点击率、转化率与用户留存率。
数据来源:用户行为数据(点击、收藏、加购、下单)、用户画像数据(年龄、性别、地域、消费能力)、商品特征数据(类别、价格、销量、评价),共500万+条用户行为记录。
工程化数据处理步骤:
行为数据清洗:剔除异常行为(如恶意点击、误操作),对用户行为进行量化(如点击记1分、加购记2分、下单记3分),生成用户行为评分矩阵。
特征处理:对用户画像与商品特征进行编码(类别特征采用独热编码、标签编码,连续特征采用归一化);新增“用户兴趣特征”(如用户偏好的商品类别、消费价格区间)、“商品关联特征”(如经常一起购买的商品)。
数据采样:由于用户行为数据稀疏(大部分用户仅点击少数商品),采用“负采样”策略,为每个用户随机选择未点击的商品作为负样本,平衡正负样本比例(1:4)。
数据划分:按时间划分训练集(过去6个月)与测试集(最近1个月),确保模型能捕捉用户兴趣的最新变化。
4.3 模型构建与工程优化
算法选择:采用“协同过滤+DeepFM”融合模型,协同过滤捕捉用户与商品的交互关系,DeepFM捕捉用户、商品的高阶特征交互,兼顾推荐的个性化与准确性,是电商推荐领域的主流融合方案[2]。
工程化优化技巧:
冷启动优化:针对新用户(无行为数据),基于用户画像(如年龄、地域)推荐相似用户喜欢的商品;针对新商品,基于商品类别推荐给关注该类别的用户,解决冷启动问题。
模型轻量化:对DeepFM模型进行剪枝,移除冗余的特征交互层,模型推理速度提升50%,适配电商平台的实时推荐需求(响应时间≤100ms)。
实时更新:采用“增量训练”策略,每天新增的用户行为数据用于模型微调,确保推荐结果能及时跟上用户兴趣变化;设置推荐缓存,减少重复计算,提升系统吞吐量。
4.4 部署与落地效果
部署方式:将模型部署到分布式服务器,结合Redis缓存热门推荐结果,通过推荐接口对接电商平台的首页、商品详情页,实现实时个性化推荐。
落地效果:推荐点击率提升至12%,商品转化率提升8%,用户留存率提升15%;新用户首次下单率提升10%,有效解决了冷启动问题,为平台带来显著的营收增长。
五、机器学习算法工程落地核心总结与避坑指南
5.1 核心总结
通过上述4个实用案例可以发现,机器学习算法工程落地的核心并非“追求复杂算法”,而是“适配业务场景、解决实际痛点”,其通用流程可总结为:需求分析→数据处理→模型构建→工程优化→部署运维→迭代升级。其中,数据处理是基础(占工程落地工作量的60%以上),工程优化是关键(决定模型的稳定性与实用性),业务适配是核心(脱离业务的算法毫无价值)。
当前,机器学习已成为现代科研与产业的重要工具,中国在多领域的算法工程落地中展现出较强的实力,从医疗影像到环境监测,从工业制造到电商服务,机器学习正推动各行业实现效率提升与质量优化[1]。
5.2 工程落地避坑指南(新手必看)
避坑1:盲目追求复杂算法,忽视业务适配。优先选择简单、可解释、易部署的算法(如XGBoost、协同过滤),复杂算法(如深度学习)仅在数据量充足、业务需求明确时使用。
避坑3:只关注模型精度,忽视部署与运维。工程落地需兼顾实时性、可扩展性、可维护性,避免出现“模型在实验室精度高,部署后无法正常运行”的问题。
避坑4:缺乏迭代思维,模型上线后不再优化。业务场景、数据分布会不断变化,需建立模型迭代机制,定期用新数据微调模型,确保模型持续适配业务需求。
六、结语
机器学习算法工程的落地,是一个“从理论到实践、从粗糙到精细”的过程,核心在于平衡“算法精度”与“工程实用性”。上述4个案例覆盖了工业、医疗、环境、电商等主流领域,涵盖分类、回归、深度学习、推荐等核心任务,其工程化思路与优化技巧具有通用性。
随着机器学习技术的不断发展,以及跨学科合作的不断深化[1],算法工程落地的门槛将逐步降低,但对从业者的“业务理解能力、工程实践能力”要求将不断提升。唯有立足业务痛点,注重数据质量,优化工程细节,才能让机器学习算法真正发挥价值,为企业、行业的发展提供助力。
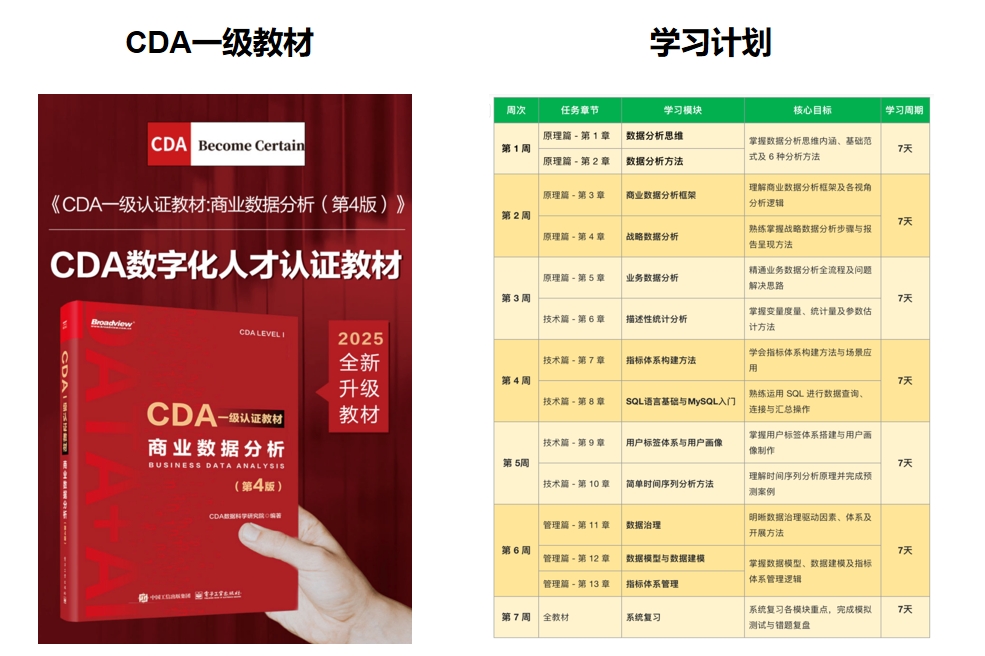
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330