京公网安备 11010802034615号
经营许可证编号:京B2-20210330
一、文本挖掘定义
文本挖掘指的是从文本数据中获取有价值的信息和知识,它是数据挖掘中的一种方法。文本挖掘中最重要最基本的应用是实现文本的分类和聚类,前者是有监督的挖掘算法,后者是无监督的挖掘算法。
二、文本挖掘步骤
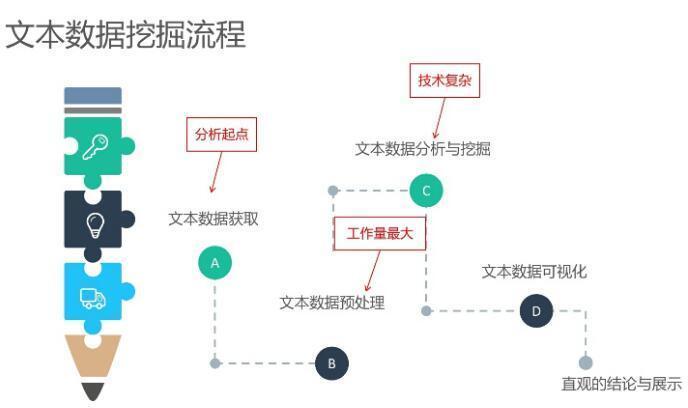
1)读取数据库或本地外部文本文件
2)文本分词
2.1)自定义字典
2.2)自定义停止词
2.3)分词
2.4)文字云检索哪些词切的不准确、哪些词没有意义,需要循环2.1、2.2和 2.3步骤
3)构建文档-词条矩阵并转换为数据框
4)对数据框建立统计、挖掘模型
5)结果反馈
三、文本挖掘所需工具
本次文本挖掘将使用R语言实现,除此还需加载几个R包,它们是tm包、tmcn包、Rwordseg包和wordcloud包。其中tmcn包和Rwordseg包无法在CRAN镜像中下载到,有关这两个包的下载方法可参见下文>>>
四、实战
本文所用数据集来自于sougou实验室数据,具体可至链接下载>>>
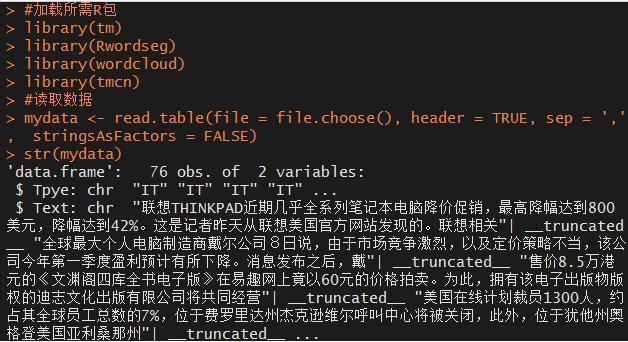
本文对该数据集做了整合,将各个主题下的新闻汇总到一张csv表格中,数据格式如下图所示:
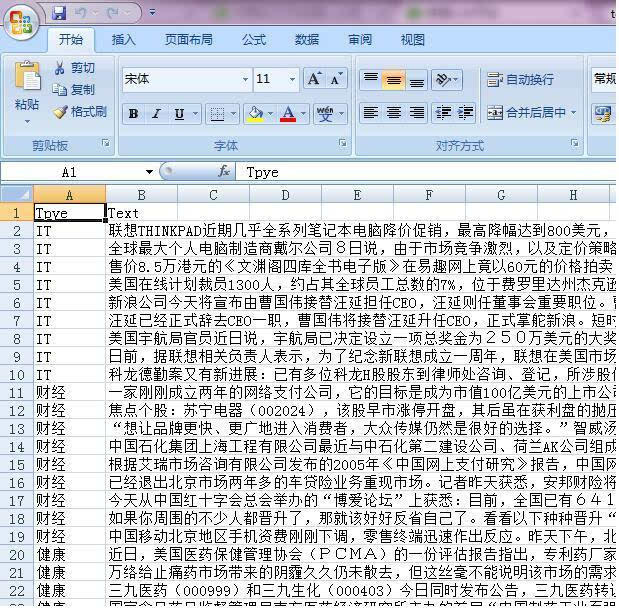
具体数据可至文章后面的链接。
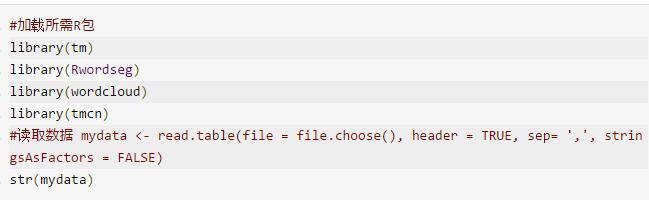
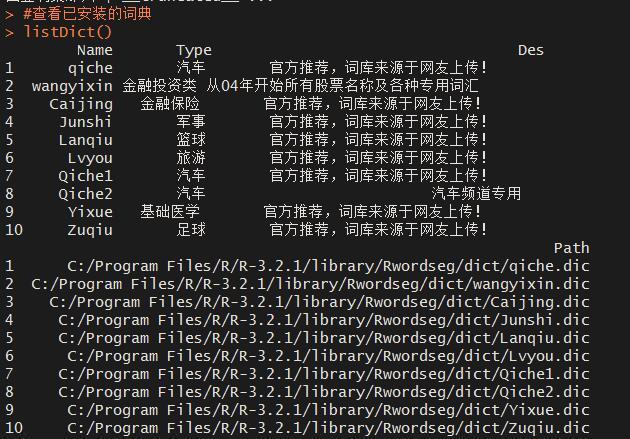
接下来需要对新闻内容进行分词,在分词之前需要导入一些自定义字典,目的是提高切词的准确性。由于文本中涉及到军事、医疗、财经、体育等方面的内容,故需要将搜狗字典插入到本次分析的字典集中。
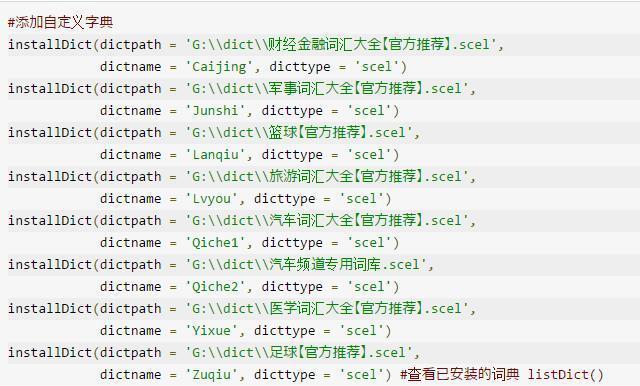
如果需要卸载某些已导入字典的话,可以使用uninstallDict()函数。
分词前将中文中的英文字母统统去掉。
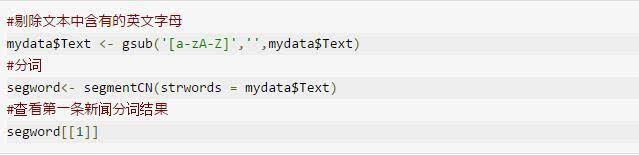
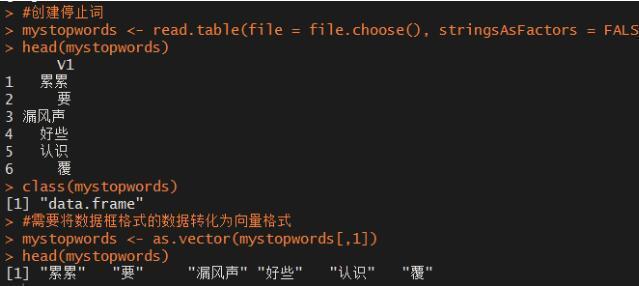
图中圈出来的词对后续的分析并没有什么实际意义,故需要将其剔除,即删除停止词。
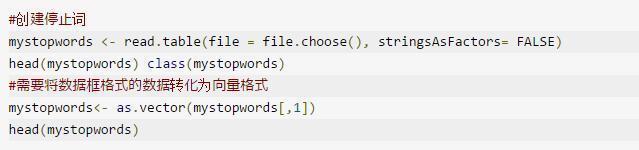
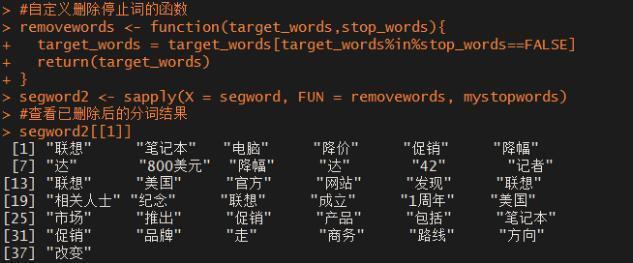
停止词创建好后,该如何删除76条新闻中实际意义的词呢?下面通过自定义删除停止词的函数加以实现。
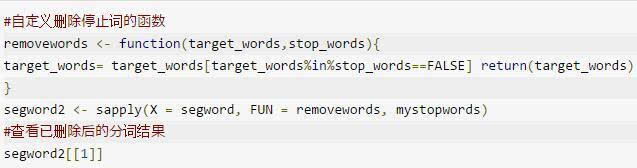
相比与之前的分词结果,这里瘦身了很多,剔除了诸如“是”、“的”、“到”、“这”等无意义的次。
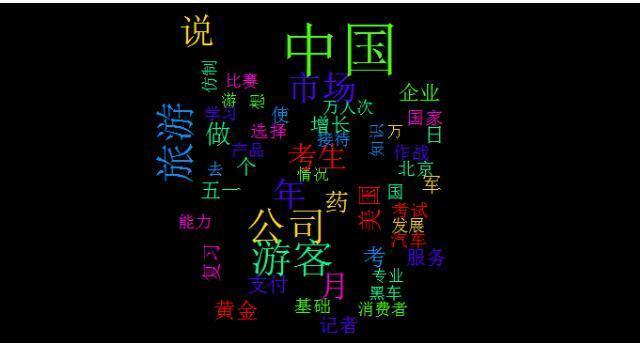
判别分词结果的好坏,最快捷的方法是绘制文字云,可以清晰的查看哪些词不该出现或哪些词分割的不准确。
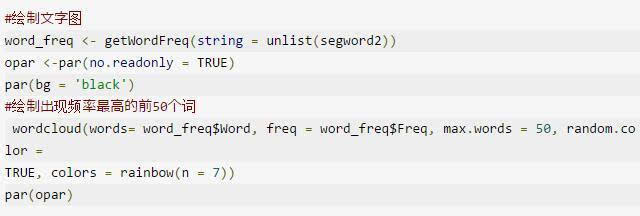
仍然存在一些无意义的词(如说、日、个、去等)和分割不准确的词语(如黄金周切割为黄金,医药切割为药等),这里限于篇幅的原因,就不进行再次添加自定义词汇和停止词。
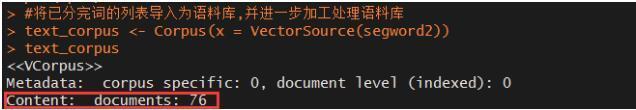
此时语料库中存放了76条新闻的分词结果。
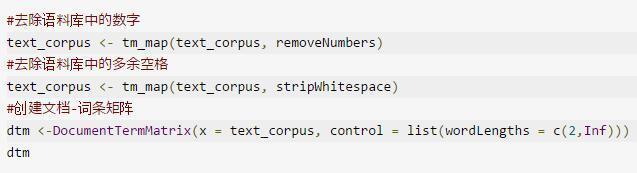
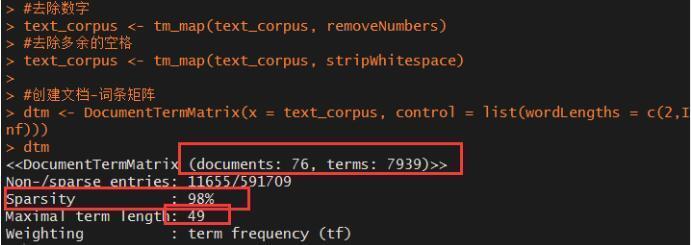
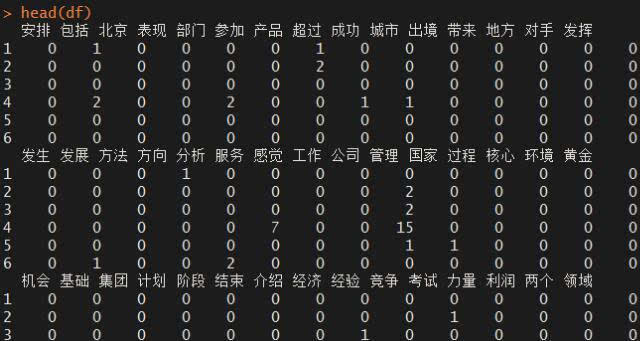
从图中可知,文档-词条矩阵包含了76行和7939列,行代表76条新闻,列代表7939个词;该矩阵实际上为稀疏矩阵,其中矩阵中非0元素有11655个,而0元素有591709,稀疏率达到98%;最后,这7939个词中,最频繁的一个词出现在了49条新闻中。
由于稀疏矩阵的稀疏率过高,这里将剔除一些出现频次极地的词语。
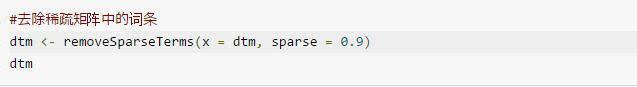
这样一来,矩阵中列大幅减少,当前矩阵只包含了116列,即116个词语。
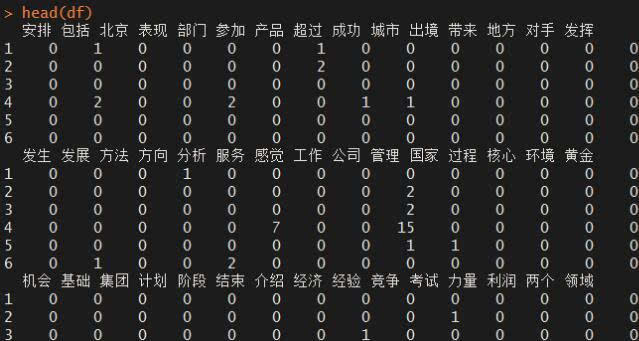
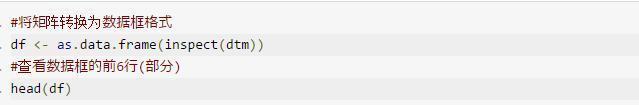
为了便于进一步的统计建模,需要将矩阵转换为数据框格式。
总结
所以在实际的文本挖掘过程中,最为困难和耗费时间的就是分词部分,既要准确分词,又要剔除无意义的词语,这对文本挖掘者是一种挑战。
数据分析咨询请扫描二维码
若不方便扫码,搜微信号:CDAshujufenxi
CDA数据分析师 出品 作者:李诗怡 定义: 用户增长核心分析框架,刻画用户从接触产品到自发推荐的全生命周期,五个递进环节构建 ...
2026-09-15在数字化营销与精细化用户运营时代,企业传统的广撒网式营销模式成本高、转化率低,已无法适配精准商业竞争需求。客户画像作为大 ...
2026-09-15 很多数据分析师精通描述性统计,能熟练计算均值、中位数、标准差,但当被问到“用500个样本如何推断10万用户的真实满意度” ...
2026-09-15在MySQL数据库数据查询与数据分析中,GROUP BY与ORDER BY是使用频率极高的核心关键字。二者语法结构相似,常搭配使用,但核心功 ...
2026-09-14随着数字化治理、智慧运营、数字孪生技术的普及,数字体征成为衡量业务状态、系统运行、城市治理与企业经营健康度的核心体系。数 ...
2026-09-14 很多数据分析师沉迷于复杂的模型和算法,却忽略了数据分析的一项基础能力——描述性统计。事实上,大量商业分析问题,用描述 ...
2026-09-14在MySQL数据库运维与开发实践中,经常出现一种典型现象:数据库实际存储的数据量很小,数据表条数少、文件体积低,但服务器整体 ...
2026-09-11 很多数据分析师能熟练计算均值、标准差,但当被问到“总体和样本有什么区别”“参数和统计量有什么关系”“数据级别的高低如 ...
2026-09-11CDA数据分析师 出品 作者:李诗怡 定义: 将同一时间段内因具备相同属性或共同经历的用户划分为群体,分析其留存与生命周期价值 ...
2026-09-11在零售、商超、餐饮、线下门店等实体商业运营中,客流与销售额是衡量门店经营状态的两大核心指标。销售额是门店经营的最终结果, ...
2026-09-10在数据可视化体系中,柱形图是最基础、应用最广泛的图表类型,其中**累计柱形图(堆积柱状图)**是兼顾整体总量与内部结构的核心 ...
2026-09-10 许多数据分析师精通Excel函数和SQL查询,但当面对一张上万行的销售明细表,要快速回答“哪个地区销量最高”“哪款产品增长最 ...
2026-09-10在Python Pandas数据分析中,DataFrame是承载结构化数据的核心载体,数据清洗、数据修正、条件赋值、字段更新等实操场景,都离不 ...
2026-09-09 很多数据分析师掌握了Excel函数、会写SQL查询,但当被问到“数据从哪里来”“数据加工有哪些步骤”“如何使用分析工具连接数 ...
2026-09-09卡方检验(Chi-Square Test)是统计学中针对分类数据的经典显著性检验方法,核心用于判断两个离散分类变量是否相互独立、数据实 ...
2026-09-09CDA数据分析师 出品 作者:李诗怡 1. 销售漏斗阶段判断 题目:销售漏斗模型中,通过广告、社交媒体等方式触达品牌信息(如浏览品 ...
2026-09-07在Python数据分析中,Pandas库的DataFrame是最核心、最常用的结构化数据表对象,类似于Excel的二维表格,具备规整的行列结构、字 ...
2026-09-07在数据分析、经营复盘、业绩预测与经济统计工作中,平均增速(平均增长率)是衡量数据长期变化趋势、业务发展快慢的核心指标。不 ...
2026-09-07 很多数据分析师精通Excel单元格操作,但当被问到“表结构数据的基本处理单位是什么”“字段和记录的本质区别”“为什么表结 ...
2026-09-07随着大数据技术的快速发展,商业竞争逐步从传统的经验式经营转变为数据驱动的精细化运营。海量的用户行为数据、交易数据、运营数 ...
2026-09-04