案例:考拉FM的个性化数据挖掘和处理_数据分析师
提起FM类APP,你都会想起哪些应用程序?来自易观智库数据显示,2014年3月电台类应用月度活跃人数最高的APP仍是考拉FM。上线不到一年的考拉FM,为何发展如此之猛?
与其他移动端电台不同的是,考拉FM采用个性化推荐音频流的播放逻辑,在用户未进行主动选择的情况下依旧能够收听到心仪的节目。移动音频娱乐与大数据挖掘的结合会是怎样的爆发?几天前,在中国电子学会主办的“云计算大会”上,考拉FM的CTO崔义超发表主题演讲,阐述考拉FM的数据挖掘和处理方法。小编在听完崔义超的发言后赶脚很有价值,为了让咱的粉丝们也能分享到这份干货,小编放弃休息时间把速记文本整理成文。
大数据在数字娱乐行业应用,音频媒体特点分析
1、音频伴随性高于视频、文字内容:
崔义超:现在大家上网可以看图文、视频,为什么还要“听”呢?因为“听”有其独特性,其目的是满足用户情感或资讯的需求,但最重要的一点:“听”是一种伴随状态,即在做重要事情时的伴随效应:比如开车时不能看视频,工作学习时不能上网阅读文章,唯独音频是可以在这些情况下进行伴随和消费的媒介。
2、移动互联网时代,音频将成为主流
崔义超:2000年前后,已经有先驱尝试在互联网上做音频内容,就是所谓的互联网电台,比如糖蒜广播到现在已经做了十来年,有上百万的粉丝,但这些尝试一直没有形成网络媒介的主流。随着移动互联网时代到来,手机的普及,以及今年开始的车联网普及,使音频与移动互联网高度结合,声音以一种新的形式重新呈现在大家面前,这就是我们现在做的考拉FM。另外还有电台汇总类APP,比如蜻蜓FM,或点播听书类APP等。
3、考拉FM是真正的移动电台——源源不断的音频流
崔义超:考拉FM是一个什么样的产品?我们把它叫做个性化的手机电台。这是什么含义?首先我们是一个电台。传统电台大家可能都听过,电台的特性是一个源源不断的流,只要不手动停止,它就一直播下去;另外具有声音不期而遇的特点,听众可以突然听到一段非常打动人心的声音,而不像听CD。我们做的手机电台也想坚持这样的特点,给听众带来不期而遇的惊喜和触动。
考拉FM个性化大数据挖掘和处理
1、考拉FM定义的个性化
崔义超:什么是个性化?考拉FM将其定义为“每一个人听到的都是自己爱听的,或至少是我不讨厌的。”这叫个性化。为什么在手机电台上需要个性化呢?音频的特性是伴随,试想一个场景:比如在家里做家务、做饭,用户打开考拉FM丢到旁边,让它自动播放。这种状态下,如果你听到的不是你想听的就需要操作,这就失去了伴随的意义,所以只有你听到是你爱听的才会实现伴随,丢到旁边不用管。
2、音频个性化体验重在专业编排,仿照传统电台
崔义超:音频个性化推荐,不是考拉FM先提出来的,之前有很多先驱做这方面的事情。在互联网或移动互联网之前,传统电台是怎么做的?经常听电台的人可能觉得传统电台做得很好,很直观的感受,但为什么好听,怎么样做到好听?听众可能说不出来。其实这就是编排,即通过专家把节目串成音频流,这是一个经验工种。比如一档节目播几分钟的音乐,插一个主持人的几句话,然后可能插播一段广告,接着每个话题聊5分钟、7分钟……这些都是需要经验的。我们希望比照传统电台听起来不累,可以一直听下去,达到伴随的效果。
进入互联网时代,每个人听到的内容不一样,不可能靠专家预先给每个人编排好节目。于是就需要算法,美国的PANDORA和豆瓣FM都做了尝试。对考拉FM,与其他音频APP最大的不同即是我们比照传统电台,通过独特的算法编排把声音串起来,努力让音频流达到既让用户想听又好听的效果,这就是音频个性化推荐要做的事情。
3、分类、标签等辅助推荐
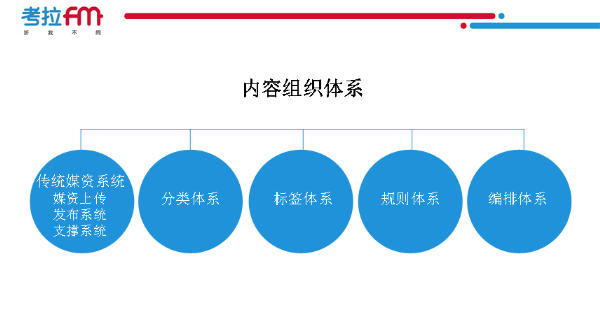
崔义超:在后台内容组织体系里,为了完成个性化推荐,传统视频网站都建立了媒资系统,比如上传、发布、版权、编解码等,但在与个性化推荐有关的独特地方,就需要更精确的内容分类,这需要有专家经验推荐,还有标签体系。像PANDORA,从2004年开始把每首歌打了400多个不同维度的标签。所以考拉FM要做到个性化推荐必须要有强大的标签体系,对不同维度进行管理,建立规则体系。
4、建立用户模型

崔义超:每个用户的用户行为非常多且复杂,对于考拉FM就有喜欢、不喜欢、跳过等等。我们了解用户,可能要收集上传很多用户数据,比如地域、收集时间,浏览路径,收听顺序、时间,是否使用快进、快退等,所有这些数据都是具体了解用户对节目的需求或用户的使用场景状况的基础。
上报以后,我们用什么方式把这些数据进行存储?大家都很熟悉大数据用Hadoop存日志,怎样做到在线进行推荐,这和存储结构相关。这些数据要能够用来做推荐,数据清晰肯定也是很重要的。比如测试机打开以后24小时播放,每一个节目都不做操作,这种数据对实际分析来说应该去掉,因为没有提供任何价值。还有同样测试时,每个节目快速滑过,看到底能够出现多少节目,下面是什么样的,可能每个节目听了都不到2秒钟,这种数据在做预处理时删掉。在拿到有效数据后,考拉FM会分析用户行为特征,比如通过聚类,看用户到底有哪些特征,比如聚成30多类用户,有些用户特征明显,早上起来就听新闻,放其他都滑过;还有用户中午就喜欢听音乐,放其他的都不喜欢听,最终建立用户模型。
5、兴趣图谱分析
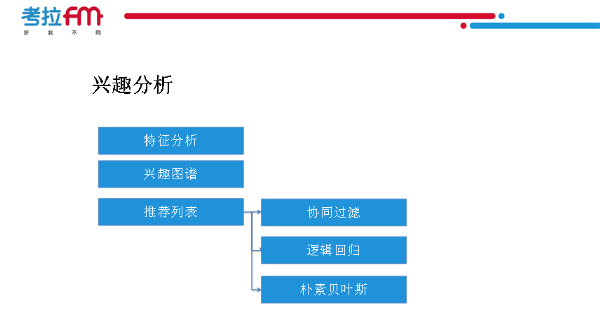
崔义超:接下来做兴趣分析。用兴趣图谱的分析,首先进行用户分析,建立兴趣图谱,针对每个用户建立一个推荐节目的列表,也就是给他一个排序,我们有几万期节目可能分成几百上千档,每个用户兴趣点不同,如果他非常喜欢某节目,这档节目的排名就靠前,有些不喜欢的节目排名就非常低,甚至通过一些过滤条件把不喜欢的节目排除掉,除了用数据做分析,我们也可以用到数据挖掘,同样类型的用户通过使用协同过滤、逻辑回归、朴素贝叶斯等方法协助生成每一个用户节目的排名。哪些用户喜欢这个节目的小池子,就放到他的喜欢池里。
接着这些池子是不是按顺序播放?如果这样做,可能有些用户喜欢,但每天都听到的是固定的,其实听起来并不好听,这时候就要用到电台独特的编排。我们在做考拉FM初期,在不了解用户时,考拉FM先做一个普世的人工电台播法,比如先播昨天所有新闻扫描,然后放国内新闻、国际新闻,但实际用户操作以后,这个预先编排就不成立了;比如我放体育新闻,一个女生对新闻完全不感兴趣,她听到的新闻就会减少。这种情况下,我们怎么样完成编排,就要说到一些规则,通过规则体系逐渐形成用算法代替人工,同时还要结合音频独特的时段分析,比如很多用户早晨喜欢听新闻,晚上女生可能会听一些情感类的,当然也有一些用户喜欢听鬼故事睡觉。
编排确定以后,再把用户兴趣图谱结合起来,就知道了用户某时段想听情感类节目,这类节目可能有上百档,再根据刚才的排名按顺序给大家进行推送。这是整个推荐的体系架构,但实际执行中我们碰到很多技术上的难点,比如存储的体系,用户数据是海量的,在收集了大概三四个月时间用户数据就上了T,这些数据如果都参加实时计算,效率肯定非常低,所以我们怎么样区分活跃用户和冷用户,用不同方式存起来就是个问题。考拉FM的解决方案是把不常用数据用文件存起来,有些则用其他手段存储结构性数据,把不同存储的数据抓过来进行计算,同时计算效率。我们把内容以及用户数据结合起来,选择参与计算的数据和离线数据。
考拉FM的大数据分析到底效果好不好?这不是凭空决定的,既然都用数据说话,就要有数据来评估效果。考拉FM是不是用收听人数增长来考虑,这很难考量,因为人数有很多其他因素决定,比如推广渠道、节假日因素等等。比如我做了一个算法改进之后,用户总收听时长是否增加,或者完整收听率,即每一个节目是否听了,听了90%,还是听了85%,可以判断这个算法到底是不是改进了,或者是不是还有改进的空间,这就是我们现在正在做的事情。
Q:对于考拉来说,用户需要花多长时间进行操作学习?
崔义超:这是好问题,对所有数据挖掘来说,训练时间都是很重要的。但我不能笼统回答,这个用户只要使用了,可以说一直在训练,而且他的提升都是一直在改进。比如完整收听率,可能之前完全是收听的专家编排的节目,这时候完整收听率平均30%多,现在完整收听率达到60%、70%,这是一个持续不断改进的过程。对于一个新用户来说,你用到“训练”这个词,有一个最大的问题其实不是训练,在用户还没有感受到你的个性化好处的时候,他可能不再使用了,所以预设的规则非常重要。我们会对大多数人进行简单的了解,然后给出预设电台,这个电台听起来至少不讨厌,然后才会参与到所谓的训练中。用户使用时间越长,推送内容越精确,我很难答需要多长时间,但如果用户一周使用两三次,基本上推送精确性就有明显提升,使用时间越长,效果越好。
Q:作为一个新用户,能否利用我的一些社交数据,比如微博或豆瓣阅读之类的个人信息来提供这样的帮助?
崔义超:你这个问题非常好,这是我们去年一直在做的事情。先讲我们的思路和你的问题非常接近,之前用户进来以后先不让他收听,希望用户用微博登陆,如果用户不用微博登陆我们有一个选项是“随便听听”,为什么用微博登陆,因为我们有一套成熟的通过微博数据分析方法,从而得出用户兴趣图谱。但现在虽然还提供微博登陆入口,但不是强制登陆,因为两点:强制登陆提高了用户使用门槛,导致部分用户直接走掉了;第二和去年大环境有关,当时微博活跃度一直在下降,所以我们觉得微博这样一个入口并不能提供很好的解决冷启动的渠道,所以我们后来换用其他方式。你说的非常重要,我们非常希望能通过社交数据的引入来部分解决冷启动的问题。
Q:我刚刚下载的考拉,因为我以前用其他的,如果偶尔误操作,比如点红心或垃圾筒会不会影响到数据分析?
崔义超:我们最重要参考指标是从大量的数据来得出的用户行为模型,这个模型肯定不是一两次操作的数据得出的,但我们也会体现“快速反应”的效果,如果用户总是操作以后推送不给反馈,用户也不会愿意。怎么样解决两者之间的矛盾?考拉FM总体上的推送是通过大量数据分析给出的,但用户的实时操作我们亦会提供一些实时反馈,这不影响到总体数据分析,但会让用户感觉到操作是有反馈的。
Q:您刚刚说并不是所有数据都会参加实时的计算,大概是多少比例会参加?
崔义超:数据分成离线还是在线的,基本所有的在线数据都参加计算,实时的是按照音频特性,比如新闻,只有最近两天的新闻的数据才参加计算。从用户属性,我们最近一个月活跃的用户才参与计算,用户两个月前下载了听了几次,大概一个半月没来过,他的数据我们不参与计算,他再来了我们才参与计算。


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330