针对任何一个打算由机器学习算法来解决的问题,都有一种『套路』存在,只要按照这个模板『按部就班』就能够得到一个结果。就跟一个产品的生产流水线是一个道理。但是得到结果的好坏跟你是否是一个『熟练工』有很大的关系。因为在解决具体的问题中有许多的tricks对于结果的提升有所帮助。
整个『套路』能分为以下5个步骤:
定义问题
对数据进行预处理
算法的抽查
对结果进行优化
结果展示
这里非常笼统地概括了整个流程,对于实际的问题,还是需要『见风使舵』,要灵活运用模板。接下来对每一个步骤进行一些解释吧。
定义问题
这个步骤对于整个流程的重要性是显而易见的,如果在解决问题的一开始就已经犯了方向性的错误,结果只能是南辕北辙。例如拿一个分类算法去解决一个聚类问题,显然这并不能得到正确的结果。还有一个误区就是迷信性能强的算法,比如svm。任何的分类问题都是用svm去解决,有可能在一些情况下logistic回归能达到更好的结果。所以,首先就需要弄清楚问题的本质。
这里我本人并没有非常丰富的实践经验,所以并不能给出非常多的建设性的意见。这里我只说说其中的一个点吧,就是寻找相似性的问题。这里有一个非常重要的技巧叫做fine-tuning。
这里拿神经网络来举一个例子吧。某人已经在一个数据集上针对一个任务训练好了一个网络,如果你要解决的问题也同样是针对这一个数据集,只不过是任务不同。这一点其实在自然语言处理上还是比较常见的。那么就可以复用网络前面那些层的权值,只针对你的任务改变输出层或是输出层之前的几层。在学习率的设置上,因为前面层次已经是训练好的了,需要设置的比较小,而后面的层次需要设置的大一点。这样的做法能够显著地降低训练整个网络的时间。可以在较短的时间内获取一个还算不错的结果。
我觉得迁移学习应该也算是一种吧,但是这个领域我其实不太了解,不能继续展开了。
数据预处理
所有的机器学习算法都是建立在数据的基础之上的。
The more disciplined you are in your handling of data, the more consistent and better results you are like likely to achieve.
首先就是收集数据的过程,因为我并没有接触过实际的例子,所以对于这一部分也不了解。在这个数据爆炸的时代收集到数据应该不难,关键是要对数据进行正确的处理。
之后就是数据的清洗过程,包括数据格式的转化(希望转换成算法所能处理的形式),数据的清洗(处理噪声数据,缺失值的处理),以及数据的采样(有可能我们并不需要这么多的数据)。这一块也是预处理过程的一个重点吧,恰好我也不是特别懂。
之后呢,就是对于数据做一些等价的转换,包括统一数据的度量(这在距离计算时非常重要)、零均值化、属性的分解以及合并。接下来对属性的分解以及合并做出一些解释,这个在其他资料上倒是挺少见。
属性的分解就是,一个属性能够分解为多个子属性,只有某一些子属性对于输出有着显著的影响。那我们就可以只存储这些子属性,而不用去存储原来的属性。例如时间这个属性可以分解为年、月、日、时、分、秒,可能只有月这个属性对于结果有影响,那我们只保留这个属性就好。
属性的合并就是与属性的分解是对立的。将一些子属性合并成一个新属性后,这个属性对于输出的影响会更加显著。那我们就会选择将这些属性进行合并。例如『登录时间』这个属性,可能对于输出值没有什么影响,如果我们将其转化为『登录的次数』呢,结果可能就会大不一样了。
数据预处理的过程并没有什么对错可言,只有合适与否。这还是需要非常深厚的功力的。对于以上步骤:
You can follow this process in a linear manner, but it is very likely to be iterative with many loops.
数据的分析
这一部分本来是属于数据的预处理的,但是我觉得还是单独出来比较好。这个在我看过的资料中还是第一次出现。
在拿到预处理完的数据之后,将其输入到算法之前,我们还是有必要对数据有一些了解,这样对模型中的参数选择能有一些帮助。这里主要包含两个方法:Summarize Data 和 Visualize Data。
Summarize Data主要是分析数据中的一些内在属性。主要包括两个方面:Data Structure 和 Data
Distribution。Data
Structure指的是数据每一维属性的类型(是连续的还是离散的)。在针对一些具体问题时,可能需要将离散的属性连续化。Data
Distribution指的自然是数据的分布。这里主要分析的是每一维数据的分布。如果是有标签的数据,可以弄清楚类别的分布,这样可以知道模型分类时准确率的下限。还可以做的更多的一点是,获取属性间的关联性。如果有关联的话,关联度有多大。这样有助于去除一些冗余属性(数据的降维),以及知道哪些属性对结果的影响比较大(权值的选择)。
Visualize Data自然是对数据进行可视化操作。有那么多种图可以画,到底应该选择哪种类型的图呢?一般来说都是画柱状图和散点图。
柱状图是描述出每一维度的值与其类标签之间的关系,也可以从图形中看出每一维的数据是服从何种分布的。特意盗了两张图。
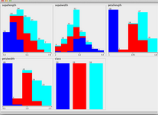
对每两组属性画出其散点图,这样可以较为容易地看出属性之间的关联性。

从上面的描述可以看出,Summarize Data 和 Visualize Data 两个过程之间是相辅相成的。
算法抽查
关于这一点,在这一篇资料中我也是第一次见到。
对于一个具体的问题,我们也许有很多种算法可以对其进行求解,那么我们是不是需要对每一种方法都进行一次尝试呢?并不需要,因为那样太费时间,而且并不是所有的算法都能有效。抽查(spot-checking)就是对多个算法进行快速验证,以决定对哪一个算法进行进一步的训练。
在进行算法的抽查时,并不需要使用使用数据集中的所有数据进行训练,只需要使用较小的一部分。在选择完算法之后,再使用所有数据进行进一步的训练。可以使用交叉验证的方法来进行该过程。
在进行算法抽查时,处于候选集中的算法的种类越多样越好,这样才能测试出哪种类型的算法更能学习到数据中的结构。在选择完算法之后,并不一定直接使用该算法进行进一步的学习,可能会使用基于该算法的改进版本。
在该部分中,还有很重要的一块内容就是训练集、测试集的划分,结果衡量标准的选择,以及结果的可信度。这一部分内容我也有写博客进行具体的阐述,毕竟水太深。
结果的改进
算法训练完成之后,如果算法的结果不如意,该怎么办?如果算法的结果还比较令人满意,有没有方法可以将结果再提升一点?这一部分主要就是解决这两个问题。文章中提出了三个方法:
Algorithm tuning
Ensembles
Extreme Feature Engineering
接下来分别叙述下这三种方法。
算法中一般都充斥这很多的参数,对算法进行训练,主要是在这些参数形成的参数空间中寻找到一个点,使得目标函数达到最优。文章中提到了一种方法,就是对参数空间进行采样,发现那些可能的最优值点,再从这些点开始训练。可以重复这个过程几次,试图获取更优的解。但是,很坑的一点是,文章中并没有说明具体的采样方法。因为是进行了多次训练,造成过拟合的风险很大。
第二中方法就是集成方法,这个会有一篇博客专门叙述这个算法。
前两种方法都是试图在算法的本身做出一些突破,而第三种方法则是希望从数据本身着手。作者自己也说了,其实这种方法可以叫做『特征工程』,就是在数据的特征方面做出一些工作。通过特征的分解/合并,降低特征之间的关联性。有些情况也会将离散的特征值转变为连续的特征值。因为算法总是希望学习到数据中蕴含的某种模式,这样才能有更强的泛化效果。如果一个模式过于复杂,那么算法的效果必然会收到影响。所以,我们希望将这个复杂的模式进行分解,这就是这个方法的初衷。在每一次训练时都可以进行该步骤,获得新的训练/测试数据集(因为特征已经发生了变化),通过在新数据集上的学习结果,对之后特征的分解/合并产生一些指导性的建议。
结果展示
当你的算法能够较好地解决一个问题的时候,你当然希望将你的成果展示给大家。这里面就说到了两种途径:写一篇论文(或者什么类似的东西)、将其与实际的产品相结合。恰好,这两个方面我都没有经验,然后就没有然后了。


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330