很多数据分析师精通描述性统计,能熟练计算均值、中位数、标准差,但当被问到“用500个样本如何推断10万用户的真实满意度”“这个估计值的可信度是多少”时,却常常语塞。其实,从样本到总体的跨越,正是推断统计的核心,而参数估计就是跨越这道鸿沟的“科学桥梁”。
”
引言:为什么参数估计是数据分析师的“样本翻译器”?
小陈是某电商平台的数据分析师。老板交给他一个任务:“我们平台的注册用户已经突破1000万了,想了解一下用户的平均月消费金额。你从订单数据里抽5000条样本,算一算。”小陈很快算出了样本均值——480元。他自信满满地汇报:“用户平均月消费是480元。”
老板追问了一句:“这个480元准不准?跟真实的总体均值能差多少?”
小陈一下子被问住了。他只能回答“样本均值是480元”,却无法回答“这个估计值有多可靠”。
这正是参数估计要解决的核心问题。参数估计的本质是“利用样本数据的统计量,推断总体未知参数的过程”。在数据分析师的日常工作中,“用部分数据推断整体情况”是高频需求——从10万条订单样本中判断全年销量趋势,从2000份用户问卷中评估全网用户满意度,从50家门店数据中预测全国门店营收。这些场景的核心支撑技术,正是参数估计。
本文将从CDA认证的知识体系出发,系统拆解参数估计的核心概念、点估计与区间估计的原理与方法、估计量的评价标准以及置信区间的计算,帮助你把“样本数据”真正转化为“总体洞察”。
一、参数估计的核心认知:从样本到总体的“科学桥梁”
1. 为什么要用样本推断总体?
在实际工作中,几乎不可能获取完整的总体数据。原因来自两个方面:
成本问题:某电商平台有1亿注册用户,分析师无法逐一调研其满意度,全量分析的时间和资源成本极高。
可行性问题:某些情况下,总体是无限的或难以触及的。例如,在产品质量检测中,测试会破坏产品本身,因此不可能对所有产品进行全检。
参数估计正是解决这一困境的“样本翻译器”——通过科学抽取的样本,就能以可控的误差范围,推断出总体的关键特征(如均值、比例、方差等)。
2. 总体、样本、参数与统计量——四个核心概念
要理解参数估计,必须先厘清这四个概念:
| 概念 |
定义 |
符号表示 |
说明 |
| 总体 |
根据研究目的确定的同质研究对象的全体 |
N(总体容量) |
例如:该平台的全部1000万注册用户 |
| 样本 |
从总体中随机抽取的部分个体 |
n(样本容量) |
例如:随机抽取的5000名用户 |
| 参数 |
描述总体特征的数值指标 |
μ(总体均值)、σ(总体标准差) |
通常是未知的,需要我们去估计 |
| 统计量 |
根据样本数据计算出来的数值指标 |
x̄(样本均值)、s(样本标准差) |
已知的,用来推断未知的参数 |
用一句话概括两者的关系:参数是客观存在的“事实”,统计量是我们手中掌握的“线索”。数据分析师的任务,正是通过手中的统计量(线索),去推断和估计未知的参数(事实)。
3. 点估计与区间估计——两种思路,各有千秋
参数估计分为点估计和区间估计两类,二者各有适用场景:
| 对比维度 |
点估计 |
区间估计 |
| 核心思路 |
追求“精准性”,用样本统计量的某个取值直接作为总体参数的估计值 |
追求“可靠性”,在点估计的基础上,结合样本误差和置信水平,给出总体参数的“可信区间” |
| 结果形式 |
一个具体的数值(如“480元”) |
一个区间范围(如“475—485元”) |
| 可靠性 |
无法量化估计误差 |
通过置信水平量化可靠程度 |
| 适用场景 |
快速获取近似值,对精度要求不高 |
正式业务报告,需要量化可信度 |
二、点估计——用样本“单点值”近似总体参数
1. 点估计的基本概念
点估计是用样本统计量直接作为总体参数的估计值。简单来说,就是用一个具体的数值来估计总体的未知参数,也称为定值估计。
点估计的核心优势是简洁直观,能直接告诉我们未知参数的估计值是多少。但它存在明显的局限:无法反映估计结果的“可靠性”——比如480元的客单价估计值,可能与总体真实值存在偏差,却无法量化偏差范围。
2. 常用的点估计方法
构造点估计的常用方法包括:
| 方法 |
核心思想 |
| 矩估计法 |
用样本矩估计总体矩,用一阶样本原点矩估计总体期望,用二阶样本中心矩估计总体方差 |
| 最大似然估计法 |
利用样本分布密度构造似然函数来求出参数的最大似然估计 |
| 最小二乘法 |
主要用于线性统计模型中的参数估计问题 |
| 贝叶斯估计法 |
基于贝叶斯理论的参数估计方法 |
在实操场景中,最常见的点估计方式是用样本均值估计总体均值。例如,抽取1000笔订单样本,其平均客单价为350元,则估计全网订单总体客单价为350元。
三、区间估计——用“可信区间”锁定总体参数范围
1. 区间估计的基本概念
区间估计是在点估计的基础上,给出总体参数估计的一个区间范围。该区间通常由样本统计量加减估计误差得到。与点估计不同,区间估计可以根据样本统计量的抽样分布,对样本统计量和总体参数的接近程度给出一个概率度量。例如,“总体客单价的95%置信区间为475—485元”,表示有95%的把握认为总体参数落在这个区间内。
区间估计的核心优势在于能量化估计的可靠性——它不仅告诉我们参数可能在哪个范围内,还告诉我们这个范围有多可信。
2. 置信区间、置信水平与显著性水平——三个关键概念
在区间估计中,有三个相互关联的概念必须掌握:
| 概念 |
定义 |
说明 |
| 置信区间 |
由样本统计量所构成的总体参数的估计区间 |
区间的最小值称为置信下限,最大值称为置信上限 |
| 置信水平(置信度) |
将构造置信区间的步骤重复多次,置信区间中包含总体参数真值的次数所占的比例 |
例如95%的置信水平 |
| 显著性水平(α) |
1 − 置信水平 |
若置信水平为95%,则α=5% |
常用置信水平对应的Z值速查:
| 置信水平 |
显著性水平α |
Zα/2 |
| 90% |
0.10 |
1.645 |
| 95% |
0.05 |
1.96 |
| 99% |
0.01 |
2.58 |
???? 一个重要的权衡关系:当样本量给定时,置信区间的宽度随置信系数的增大而增大;当置信水平固定时,置信区间宽度随样本量增大而减小。也就是说,追求更高的置信水平,就必须接受更宽的置信区间。
3. 不同场景下的区间估计方法
在CDA的实际分析工作中,总体均值的区间估计需根据总体方差是否已知、样本量大小来选择不同的方法:
| 场景 |
使用的分布 |
核心公式 |
说明 |
| 正态总体,σ已知 |
Z分布(正态分布) |
x̄ ± Zα/2 × σ/√n |
总体方差已知 |
| 正态总体,σ未知 |
t分布 |
x̄ ± tα/2(n-1) × s/√n |
总体方差未知,用样本方差替代 |
| 大样本(n≥30) |
Z分布(近似) |
x̄ ± Zα/2 × s/√n |
中心极限定理,可用样本标准差s代替σ |
4. 置信区间的正确解读
需要注意的是,参数是固定的常数,样本统计量是随机变量。
正确理解:“该置信区间包含总体参数的概率为95%”——在大量重复抽样中,约95%的置信区间会包含真实的总体参数。
错误理解:“总体参数有95%的概率落在该区间内”——参数本身是固定值,不存在概率分布,概率描述的是区间(随机变量)覆盖参数的可能性。
四、估计量的评价标准——如何判断一个估计量好不好?
在参数估计中,可以用来估计未知参数的估计量有很多。评价一个估计量“好不好”,主要依据以下三个核心标准:
| 评价标准 |
定义 |
说明 |
| 无偏性 |
估计量抽样分布的数学期望等于被估计的总体参数 |
确保大量重复抽样中,估计量不会系统地偏离总体参数的真实值 |
| 有效性 |
对同一总体参数的两个无偏估计量,方差更小的更有效 |
估计量越稳定,有效性越高 |
| 一致性 |
随着样本量的增大,估计量的值越来越接近被估计的总体参数 |
大样本性质,样本越多,估计越准 |
???? CDA考点提示:无偏性是考试中较为常见的考点。样本均值是总体均值的无偏估计——在无数次重复抽样时,样本均值的期望等于总体均值。有效性则决定了估计量的稳定性和精确度。
五、实战演练:从一份“用户调研样本”完成完整的参数估计分析
背景
假设你是某互联网公司的数据分析师。公司需要对1000万用户的月均消费金额进行调研。由于全量数据分析成本过高,你决定采用抽样分析。随机抽取了400名用户作为样本,收集到的数据如下:
老板要求你回答以下问题:
- 在95%的置信水平下,全量用户的月均消费在什么范围内?
完整操作流程
第一步:确认总体与样本
第二步:进行点估计
用样本均值作为总体均值的点估计值:总体月均消费均值μ的点估计 = x̄ = 520元
从点估计的角度,全量用户的月均消费约为520元。但点估计无法量化误差范围。
”
第三步:确定采用Z分布进行区间估计
由于样本容量n=400(大于30,属于大样本),可以使用正态分布(Z分布)近似计算。置信水平为95%,对应的Zα/2=1.96。
标准误 = s / √n = 80 / 20 = 4
置信区间 = x̄ ± Zα/2 × 标准误 = 520 ± 1.96 × 4 = 520 ± 7.84
总体月均消费的95%置信区间为512.16元—527.84元
”
第四步:解读置信区间
“95%置信区间”的正确理解:如果重复进行100次同样的抽样估计,会得到100个不同的置信区间,其中大约95个区间会包含总体真实均值μ。
第五步:回答老板的问题
“在95%的置信水平下,全量用户的月均消费在512元到528元之间。抽样误差约为±8元。这个估计结果有95%的可信度——如果我们重复抽样100次,大约有95次的结果会落在这个区间内。”
这就是一套完整的“样本统计量 → 点估计 → 区间估计 → 结论解读”的参数估计实战流程。
”
结尾:从“描述数据”到“推断总体”——CDA专业认证的方法论进阶
很多数据分析师精通描述性统计,能熟练计算均值、中位数、标准差,但当被问到“用样本如何推断总体”“点估计和区间估计有什么区别”“95%置信区间如何理解和计算”时,却常常语塞。
描述性统计回答的是“数据长什么样”,参数估计回答的是“总体数据可能是什么样”。两者的结合,构成了数据分析从“描述过去”到“推断未来”的能力跃迁。
在2025年新考纲的背景下,参数估计从更高层级下放至一级,这一变化释放了明确的信号:数据分析师需要具备从样本推断总体的核心能力,而非仅仅停留在描述性统计层面。CDA一级的课程体系完整覆盖了参数估计的所有核心知识点,包括点估计与区间估计的基本概念、置信区间的计算方法以及估计量的评价标准。
参数估计是CDA数据分析师从“描述性分析”走向“推断性分析”的必经之路。无论是对用户满意度进行区间估计,还是评估A/B测试的显著性差异,参数估计都为数据驱动的业务决策提供了可靠的量化依据。
下一步行动:
- 找一份真实的业务数据,尝试用样本数据推断总体的均值和比例
- 练习在不同置信水平(90%、95%、99%)下计算置信区间,理解置信水平与置信区间宽度的权衡关系
- 思考你日常工作中哪些场景适合用点估计、哪些适合用区间估计
样本是有限的,但掌握参数估计的人能让它说出总体的真相。
”
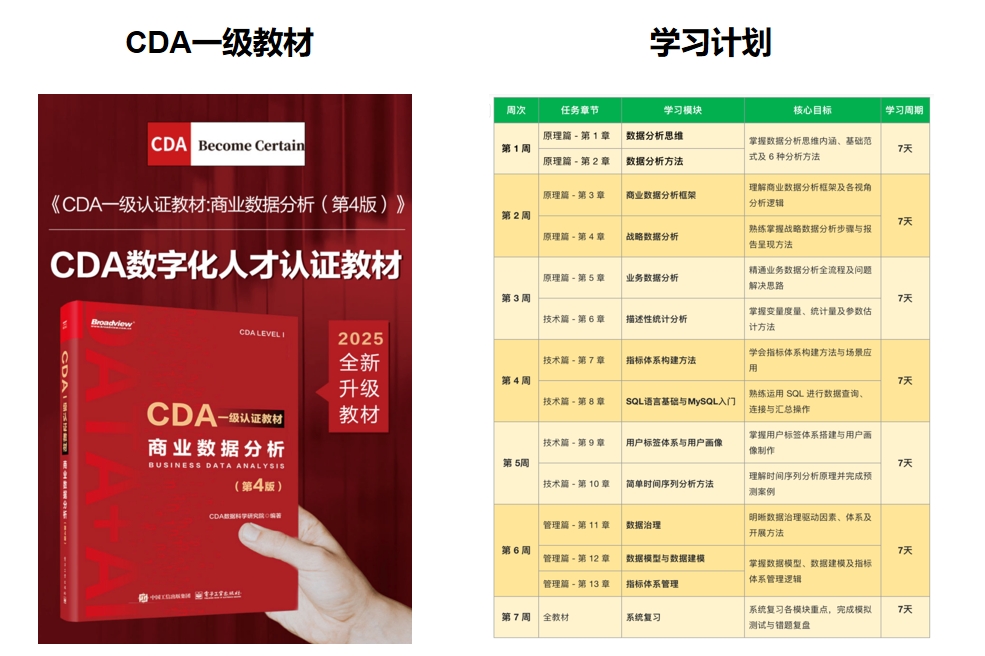
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330