在数据清洗、统计分析与数据质量检测工作中,箱型图(又称箱线图、Box Plot)是最直观、最高效的可视化分析工具之一。相较于柱状图、折线图仅能展示数据大小与变化趋势,箱型图可以完整呈现数据的分布特征、集中趋势、离散程度以及异常值分布。Excel作为普及度最高的办公工具,内置一键生成箱型图的功能,无需复杂代码即可快速完成数据可视化与异常筛查。本文将系统讲解Excel箱型图的构成含义、标准解读方法、实操绘制步骤、业务分析逻辑及常见误区,帮助使用者通过箱型图快速读懂数据、识别异常、完成数据质量研判。
一、Excel箱型图概述与核心价值
箱型图是一种用于展示连续型数值数据分布的统计图表,适用于单组数据分布分析、多组数据差异对比、批量异常值识别等场景。在数据分析流程中,箱型图常作为数据清洗的前置工具,广泛应用于电商经营分析、工业质量检测、学生成绩分析、用户行为数据统计等场景。
相较于其他图表,Excel箱型图具备三大核心优势:第一,不受极端数据干扰,能够客观展示数据整体分布;第二,可直观识别全部异常离群点,精准区分正常波动与错误数据;第三,支持多组数据并列对比,快速识别不同样本的数据差异,是低成本、高效率的数据分析工具。
二、Excel箱型图完整结构与专业释义
想要精准解读箱型图,首先需要掌握其五大核心组成元素,所有解读逻辑均围绕中位数、四分位数、上下须、异常值展开,每个结构对应明确的数据统计学含义。
1. 下四分位数(Q1):数据从小到大排序后,前25%位置的数值,代表数据低位分界线。
2. 中位数(Q2):数据中间位置的数值,代表数据的整体集中水平,相比均值更抗干扰,不会被极端值拉高或拉低。
3. 上四分位数(Q3):数据排序后,前75%位置的数值,代表数据高位分界线。
4. 箱体:由Q1与Q3围成的矩形区域,包含数据集50%的核心数据,箱体越窄,数据越集中;箱体越宽,数据波动越大、离散程度越高。
5. 上下须(触须):箱体向上、向下延伸的线段,代表数据正常波动的最大、最小范围,须的端点为正常数据的极值。
6. 离散异常点:图表中独立的空心圆点,落在上下须之外,代表超出正常波动区间的异常值、离群点。
基于四分位数可计算核心指标:四分位距IQR=Q3-Q1,也是箱型图识别异常值的核心依据,正常数据区间为【Q1-1.5IQR,Q3+1.5IQR】,超出该区间即为异常值。
三、Excel箱型图标准生成实操步骤
新版Excel(2016及以上)内置原生箱型图功能,无需插件,一键生成标准可视化图表,具体操作流程如下:
第一步,整理数据。将需要分析的连续型数值数据(销售额、销量、时长、成绩等)整理为单列或多列规范数据,剔除空白单元格,保证数据格式统一。
第二步,插入图表。选中全部数据区域,点击顶部菜单栏【插入】,在图表选项中选择【插入统计图表】,点击【箱型图】,系统自动生成可视化箱型图。
第三步,参数优化。右键点击图表,可设置显示中位数标签、隐藏/显示异常点、调整箱体样式,同时可开启“包含均值点”,实现均值与中位数双重对比分析。
第四步,多组对比设置。若需对比两组及以上数据,只需将多组数据并列录入,生成的箱型图会独立展示各组分布,直观完成横向对比。
四、Excel箱型图全方位解读方法
箱型图的解读核心分为四个维度:看集中趋势、看离散程度、看数据偏态、看异常离群点,四者结合可完整还原数据真实状态。
(一)看集中趋势:判断数据整体水平
集中趋势主要依靠中位数判断,中位数在箱体中的位置直接反映数据中心水平。中位数位置居中,说明数据分布对称,整体数值均衡;中位数偏上,说明多数数据偏高,低数值较少;中位数偏下,说明多数数据偏低,高数值较少。多组数据对比时,中位数越高,代表样本整体水平更优,例如两组店铺销量数据,中位数更高的店铺整体经营表现更好。
(二)看离散程度:判断数据稳定性
箱体宽度与须的长度,决定数据的稳定性与离散程度。箱体窄、须短,代表50%核心数据高度集中,整体数据波动小、稳定性强;箱体宽、须长,代表数据分散严重,高低值差距大、数据稳定性差。在工业质控、业绩考核中,稳定性越强的数据,代表生产水平、经营状态越平稳。
(三)看数据偏态:判断数据分布特征
通过箱体与须的对称关系,可快速判断数据偏态类型。上下须长度基本一致、中位数居中,数据近似正态分布,属于标准优质数据;上须长、下须短、中位数偏下,数据呈右偏分布,存在少量极高数值拉高整体区间;下须长、上须短、中位数偏上,数据呈左偏分布,存在少量极低数值拉低整体区间。偏态解读可帮助分析数据不均衡的业务原因,如右偏销量数据代表存在少量爆款高销量单品。
(四)看异常离群点:识别错误与极端数据
图表中所有独立的空心圆点,均为统计学意义上的异常值,是箱型图最核心的分析价值。异常点数量越少,数据质量越高;异常点集中在上方,代表存在极端高值;异常点集中在下方,代表存在极端低值。结合业务场景可区分异常类型:录入错误、系统bug产生的无效异常值需清洗剔除;真实业务极端数据需单独记录、专项分析。
五、实操案例:Excel箱型图业务解读应用
以电商店铺30日日销售额数据为例,通过箱型图解读完整数据特征:生成箱型图后可见,箱体较窄、中位数居中,说明店铺每日销售额核心数据稳定,日常营收波动小;上侧存在2个离散异常点,下侧无异常值;上须略长于下须,数据轻微右偏。
完整分析结论:该店铺日常销售数据整体稳定、营收均衡,数据质量较高;存在两日销售额远超正常区间,属于极端高值,结合业务可判定为活动大促带来的正常峰值数据,非错误数据,无需清洗;整体数据轻微右偏,说明店铺偶尔出现爆发式营收增长,具备增长潜力。
六、箱型图解读常见误区与注意事项
在Excel箱型图解读过程中,极易出现主观误判,影响数据分析准确性,需规避以下核心误区。
第一,异常点不等于错误数据。箱型图标记的异常值仅为统计学极值,不代表数据错误,必须结合业务场景判断,不可直接删除,避免丢失关键极值信息。
第二,箱体宽窄不代表数据好坏。箱体宽仅代表数据波动大,在部分业务场景中属于正常现象,如节假日销量波动、季节性数据变化,无需强行优化数据。
第三,不适用分类数据解读。箱型图仅适用于销售额、时长、销量等连续型数值数据,无法用于性别、品类等分类数据,强行使用会导致解读无效。
第四,多组对比需统一标准。多组箱型图对比时,需保证数据统计维度、单位、周期一致,否则对比结果无参考意义。
七、总结
Excel箱型图是数据分析中简洁、高效、实用的可视化工具,通过中位数、四分位数、箱体、须线与异常点五大结构,可全方位解读数据的集中趋势、离散程度、分布形态与异常情况。相较于传统的数值统计,箱型图将抽象的统计数据可视化,能够快速帮助使用者判断数据质量、识别异常极值、对比多组差异、挖掘数据特征。
在日常数据清洗、经营复盘、质量检测、学术统计等场景中,熟练掌握Excel箱型图的绘制与解读方法,能够快速提升数据分析效率,精准甄别有效数据与异常数据,为后续的统计检验、数据建模、业务决策提供高质量的数据支撑,是数据分析从业者必备的基础能力。
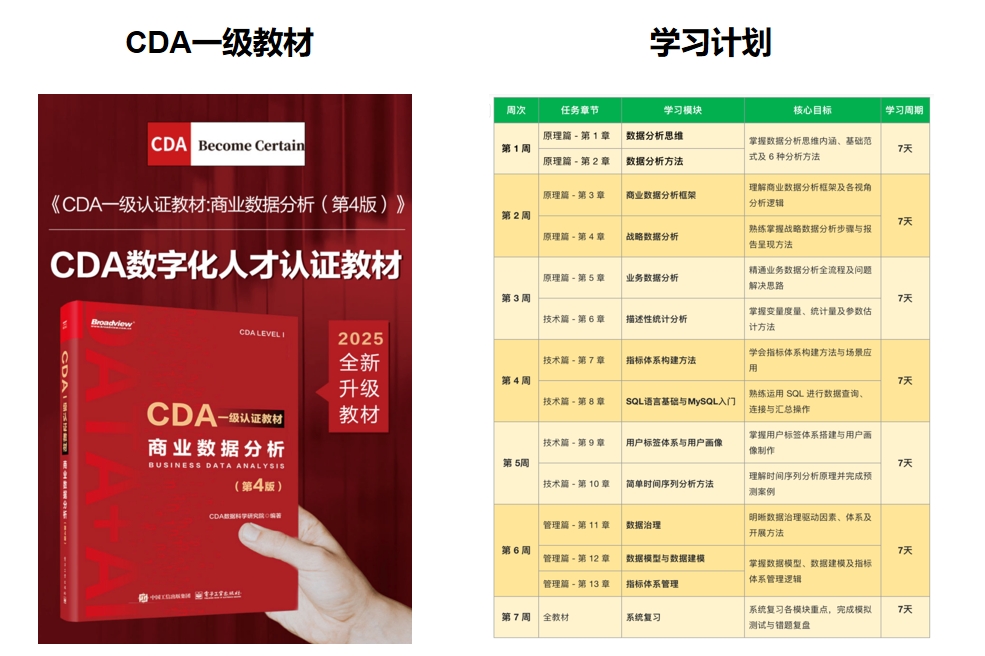
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330