在机器学习建模与数据分析实战中,特征维度爆炸、冗余信息干扰、模型泛化能力差是高频痛点。面对用户画像、企业经营、医疗检测、金融风控等多维度数据集,盲目纳入全部特征建模,不仅会提升训练成本、降低模型运行效率,还容易引发过拟合,导致模型在实际业务中预测失效。而随机森林算法,凭借集成学习的优势、抗噪声能力强、适配非线性数据等特点,成为分类与回归场景的常用模型;更关键的是,它内置的特征重要性分析能力,能高效量化各特征对预测结果的贡献度,成为特征筛选、模型优化、业务解读的核心工具。
很多人使用随机森林时,仅停留在“训练模型、输出预测结果”层面,忽略了特征重要性分析的核心价值。事实上,特征重要性是随机森林模型的“附加红利”,也是打通机器学习模型与业务理解的关键桥梁,既能实现数据降维、精简模型,又能挖掘核心影响因素,让黑盒模型具备可解释性。本文将从随机森林基础逻辑、特征重要性原理、计算方法、实操流程、应用场景及避坑指南,全方位拆解随机森林中的特征重要性分析,助力建模与数据分析效率双提升。
一、前置认知:随机森林算法核心逻辑
随机森林是经典的集成学习算法,核心是通过构建多棵独立的决策树,形成“群体决策”的模型结构,克服单棵决策树过拟合、稳定性差的缺陷,其核心运行逻辑遵循双重随机性,也是特征重要性计算的基础:
样本随机:Bootstrap自助采样:从原始数据集中有放回地随机抽取样本,构建多组不同的训练子集,每组子集对应训练一棵决策树,保证决策树之间的独立性;
模型预测时,分类场景采用多棵决策树投票机制,回归场景采用多棵决策树均值融合机制,最终输出稳定、泛化能力强的预测结果。而特征重要性,正是基于每棵决策树的节点分裂过程,量化每个特征对模型决策的平均贡献度。
二、随机森林特征重要性:核心原理与计算方法
特征重要性,简单来说就是用数值指标衡量每个特征对模型预测结果的影响程度,分值越高,代表该特征对模型的贡献越大、越关键;分值越低,代表特征越冗余,甚至可直接剔除。随机森林中主流有两种计算方法,适用场景不同,解读逻辑一致。
1. 基于不纯度减少的特征重要性(内置默认方法)
这是随机森林最常用、调用最便捷的内置方法,也是Sklearn库中随机森林模型的默认计算方式,核心依托决策树节点分裂的不纯度变化计算。
核心原理
决策树节点分裂的核心目标,是通过特征划分让子集的“不纯度”降低(分类任务用基尼系数、信息熵,回归任务用均方误差)。一个特征在决策树分裂中,带来的不纯度减少量越多,说明该特征的区分能力越强、重要性越高。
随机森林会遍历所有决策树,计算每个特征在所有分裂节点上的平均不纯度减少量,最终归一化后得到该特征的重要性得分(通常取值0-1,所有特征得分之和为1)。
适用场景
数据集特征量适中、无明显异常值、训练速度要求高的分类与回归任务,日常建模快速筛选核心特征首选。
2. 基于排列的特征重要性(Permutation Importance,更稳健)
也叫置换重要性,是一种更通用、更稳健的方法,不受决策树不纯度计算的限制,结果更贴合实际业务预测效果。
核心原理
模型训练完成后,保持其他特征不变,随机打乱某一个特征的样本取值顺序,破坏该特征与目标变量的真实关联,重新输入模型预测,对比打乱前后模型的精度下降幅度。精度下降越多,说明该特征对模型预测越关键,重要性越高。
优势与适用场景
避免不纯度方法对高基数特征(如类别多、数值范围大)的偏倚,结果更公平;
适合高维数据、建模后期模型优化、业务解读需求高的场景。
三、特征重要性分析的核心价值:不止于数据降维
在数据分析与机器学习全流程中,随机森林特征重要性分析的价值贯穿始终,是模型优化与业务洞察的双重利器:
高效特征筛选,解决维度灾难:剔除重要性极低的冗余特征、无关特征,减少数据维度,降低模型训练时间与算力消耗,同时缓解过拟合,提升模型泛化能力;
破解黑盒模型,提升可解释性:机器学习模型常被诟病“不可解释”,通过特征重要性排序,能清晰说明哪些因素主导预测结果,让模型决策有据可依,尤其适配金融、医疗等强监管、需解释的行业;
挖掘业务核心,指导决策落地:脱离纯数据层面,结合业务场景解读核心特征,找到影响目标变量的关键因素。比如用户流失预测中,定位“月活跃度、消费频次、客服投诉次数”为核心特征,指导运营针对性留存;
优化数据采集,降低成本:明确核心特征后,后续数据采集可聚焦关键指标,减少无关数据的采集成本,提升数据整体质量。
四、实操全流程:随机森林+特征重要性分析(Python版)
以下为日常建模的标准化流程,基于Python的Sklearn库实现,代码可直接复用,适配分类与回归任务。
步骤1:环境配置与数据准备
导入所需库,加载数据集,完成基础数据清洗(处理缺失值、异常值、分类特征编码),划分训练集与测试集。
import pandas as pd
import numpy as np
from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
from sklearn.inspection import permutation_importance
import matplotlib.pyplot as plt
data = pd.read_csv("业务数据集.csv")
X = data.drop("目标变量列", axis=1)
y = data["目标变量列"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
rf = RandomForestClassifier(n_estimators=100, random_state=42)
rf.fit(X_train, y_train)
步骤3:计算并提取特征重要性
impurity_importance = rf.feature_importances_
feature_importance_df = pd.DataFrame({
"feature": X.columns,
"importance": impurity_importance
}).sort_values(by="importance", ascending=False)
perm_result = permutation_importance(rf, X_test, y_test, n_repeats=10, random_state=42)
perm_importance = perm_result.importances_mean
feature_importance_df["perm_importance"] = perm_importance
步骤4:可视化与结果解读
绘制柱状图直观展示特征重要性排序,快速定位核心特征。
plt.figure(figsize=(12,6))
plt.barh(feature_importance_df["feature"][:10], feature_importance_df["importance"][:10])
plt.xlabel("特征重要性得分")
plt.ylabel("特征名称")
plt.title("随机森林特征重要性Top10")
plt.gca().invert_yaxis()
plt.show()
步骤5:基于重要性筛选特征,重构模型
设定重要性阈值(如剔除得分<0.01的特征),保留核心特征,重新训练模型,对比模型精度与运行效率。
五、业务场景实战案例
案例1:金融风控——逾期还款预测
数据集包含用户年龄、收入、负债比、征信查询次数、历史逾期次数、工作年限等15项特征,通过随机森林特征重要性分析,得出历史逾期次数、负债比、征信查询次数为Top3核心特征,其余特征重要性极低。
落地应用:剔除冗余特征后,模型精度提升2%,训练速度提升40%;风控策略聚焦核心特征,简化审核流程,降低坏账率。
案例2:电商运营——用户复购预测
针对用户消费数据,特征重要性排序显示近3个月消费频次、客单价、是否领取优惠券对复购影响最大,性别、地域等特征重要性可忽略。
落地应用:针对高价值核心特征用户,推送专属优惠券与复购活动,精准提升复购率,减少无效营销投入。
六、常见误区与避坑指南
误区1:特征重要性高=因果关系强
避坑:特征重要性仅反映特征与目标变量的相关性与模型贡献度,不代表因果关系,业务决策需结合行业常识与逻辑验证,不可仅凭重要性得分判定因果。
误区2:盲目剔除低重要性特征
避坑:部分低重要性特征可能是业务必备指标,或在细分场景中发挥作用,剔除前需结合业务验证;建议保留少量边缘重要性特征,避免丢失关键信息。
误区3:高基数特征偏倚(不纯度方法缺陷)
避坑:不纯度方法会偏向取值多、数值范围大的高基数特征,导致得分虚高,精准建模建议使用排列重要性,结果更客观。
误区4:特征重要性得分一成不变
避坑:特征重要性受样本数据、模型参数(决策树数量、深度)影响,数据更新或参数调整后,需重新计算重要性,保证结果时效性。
七、参数优化建议
n_estimators:决策树数量,建议设置100-200,数量过少结果不稳定,过多增加训练时长;
max_depth:限制树深度,避免过拟合,同时让特征重要性计算更稳健;
random_state:固定随机种子,保证特征重要性结果可复现。
八、总结
随机森林算法本身已是兼顾性能与易用性的经典模型,而特征重要性分析更是其核心附加值,完美解决了机器学习建模中“维度冗余、模型不可解释、业务难落地”三大核心痛点。
对于数据分析与建模人员而言,使用随机森林时,绝不能只关注预测精度,更要挖掘特征重要性的价值:用它精简数据、优化模型,用它解读业务、指导决策,实现从“数据建模”到“价值输出”的完整闭环。无论是日常数据降维、机器学习建模,还是业务问题诊断、策略制定,结合特征重要性的随机森林,都是高效、实用的核心工具,也是提升数据分析与建模能力的必备技能。
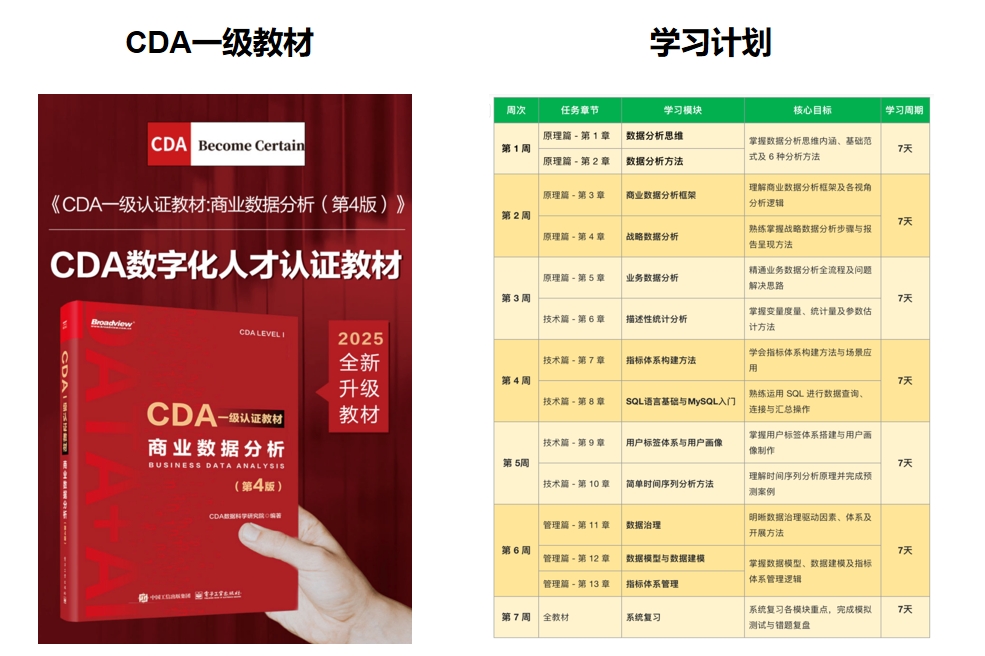
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330