很多数据分析师精通Excel函数和透视表 ,但当被问到“数据从哪里来”“表和视图有什么区别”“数据库管理系统和SQL 是什么关系”时,却常常答不上来。在企业的真实工作场景中,数据很少是现成的Excel文件 ,而是存储在各类数据库中的结构化信息。掌握数据库的核心概念,是数据分析师从“会处理数据”走向“会获取数据”的必经之路。
” 引言:为什么“读懂数据库”是数据分析师的第一关? 小林是一名数据分析师,入职某零售企业后接到的第一个任务是:“从销售系统数据库中提取近3个月的订单明细数据”。小林打开数据库工具,面对那一排排陌生的表名和字段 名,他发现——自己很清楚“分析Excel数据”该怎么算,却不知道“把数据从数据库里弄出来”的第一步是什么。
在企业环境中,数据资产几乎都沉淀在数据库中,而非现成的Excel文件。数据分析师日常工作中面临的“数据从哪来、怎么取、取完怎么用”等基础问题,都绕不开对数据库的理解。
一、数据库的核心认知:CDA视角下的数据“仓库” 1. 什么是数据库? 数据库(Database)是一个有组织的数据集合,旨在高效地存储、管理和检索数据。数据库是存放企业数据资产的“核心大本营”,也是CDA数据分析师工作的“数据起点”。
2. 数据库分类(CDA高频考点) 根据数据模型的差异,数据库可分为关系型数据库 和非关系型数据库 。
关系型数据库 (RDBMS)典型代表 :MySQL 、Oracle、PostgreSQL 、SQL Server等。核心优势 :支持ACID事务(原子性、一致性、隔离性、持久性),适合复杂查询和事务密集型场景。例如金融系统对数据的准确性和完整性要求极高,会优先选择关系型数据库 。适用场景 :事务处理、数据管理、复杂查询等场景。
非关系型数据库 (NoSQL ) 是一类不使用传统关系模型来存储数据的数据库。分类 :按存储结构可分为键值型(如Redis)、文档型(如MongoDB)、列族型(如Cassandra)、图型等。核心优势 :水平扩展性强、读写性能高,适合海量数据、低延迟的场景。例如,Redis通过内存存储和单线程模型实现微秒级响应。适用场景 :海量数据存储 、高并发写入、灵活的数据结构 。
3. 表的核心构成要素 在关系型数据库 中,表(Table) 是数据的基本单位,由行和列组成。每一行代表一条记录,描述一个完整的业务事件;每一列代表一个字段 ,描述一种业务属性(如订单金额)。主键(Primary Key) 是表中唯一标识每一行的字段 或字段 组合,确保数据的唯一性,主键不能为空值。外键(Foreign Key) 是指向另一个表主键的字段 ,用于建立表与表之间的关系,维护数据的完整性。
在数据分析和多表查询中,主键始终是CDA分析师处理多表关联的“锚点”。
二、核心对象详解:表与视图——考试中的“必考点” 表是存储数据的实体容器 ,视图则是基于一个或多个表的查询结果构建的虚拟表 。掌握表和视图的区别,是CDA一级“数据库应用”部分的明确考点要求。
1. 数据表(Table):固化数据的“实体容器” 数据表是数据库中用于物理存储数据 的实体结构,相当于“数据档案柜”。核心特征 :占用物理存储空间 ;数据独立存在 ;可直接修改数据内容 。
2. 视图(View):简化查询的“虚拟窗口” 视图是基于一个或多个表的查询结果构建的虚拟表 ,其本身不存储数据,仅在内部封装了查询语句。每次访问视图时,数据库会重新执行其关联的查询逻辑,返回最新的数据结果。
视图的主要作用 :
简化复杂查询 :视图可以根据分析流程,将复杂的业务逻辑(如多表连接、分组、排序等)封装成简单的查询。分析人员使用视图时,不需要关心表的结构、连接关系和筛选条件,大幅降低查询代码的复杂度。增强数据安全 性 :在创建视图时,数据库管理员可以隐藏敏感字段 。同时可为不同级别的用户设置不同的视图访问权限,从而确保用户仅能获得与需求相关的数据,提升数据库的数据安全 性。
3. 表与视图的核心差异对比(CDA高频必考点)
对比维度
数据表
视图
CDA选择建议
数据存储 物理存储数据,占用空间
仅存查询逻辑,不存数据
长期稳定数据→表;实时关联数据→视图
数据更新 可直接增删改查
操作受限制(聚合函数、去重场景无法修改)
需修改数据→表;仅查询→视图
查询效率 直接读取数据
每次访问需动态执行查询语句
大数据量频繁访问→表;临时查询→视图
依赖关系 独立存在
依赖底层基本表,源表变化时视图自动更新
需动态数据→视图;稳定结构→表
三、CDA与数据库的“沟通语言”:SQL 的三层能力框架 SQL (结构化查询语言,Structured Query Language)关系型数据库 的标准编程语言,几乎适用于所有的主流关系型数据库 管理系统。
(一)领会层:SQL 语句的基本语法 核心规则 :SQL 中可以使用表别名和列别名来增强代码可读性,但存在执行顺序限制。SQL 语句的执行顺序为:FROM → JOIN → WHERE → GROUP BY → HAVING → SELECT → ORDER BY。别名在WHERE子句后计算,因此WHERE子句中不能使用列别名,但SELECT、FROM和JOIN子句中可以使用表别名。
(二)熟知层:从数据中“抽丝剥茧” 熟知层要求能够选取需要的列、过滤重复的行、筛选符合条件的行。
选取需要的列 (SELECT):SELECT 字段 1, 字段 2 FROM 表名; 仅查询必要字段 能显著减少I/O开销。过滤重复的行 (DISTINCT):SELECT DISTINCT 字段 FROM 表名;筛选符合条件的行 (WHERE):通过比较运算符和逻辑运算符筛选满足条件的数据。
(三)应用层:分组汇总、连接查询与子查询 1. 对查询结果排序(ORDER BY)与限制(LIMIT) :SELECT … FROM … ORDER BY 字段 名 ASC/DESC; 升序(ASC)或降序(DESC)排序。LIMIT子句用于限制返回记录数。
2. 在查询结果中创建新列(使用AS设置别名) :SELECT 字段 1, 字段 1 * 0.5 AS ‘计算列名称’ FROM 表名;
3. 分组汇总和筛选(GROUP BY + HAVING) :GROUP BY配合聚合函数实现数据分组(SUM求和、AVG平均值、COUNT计数、MAX最大值、MIN最小值)。HAVING子句在数据分组之后 执行筛选。
WHERE在数据聚合 前筛选原始数据行;HAVING在数据聚合 后筛选分组后的结果。
4. 多表横向连接查询(JOIN考点) :在企业真实数据中,一张表的信息永远不够,必须连接多个表才能完成完整分析。考试要求重点掌握三种连接方式:
连接类型
核心逻辑
实际业务场景
内连接(INNER JOIN) 只返回两张表中都匹配的记录
分析已付款的订单及其客户信息
左连接(LEFT JOIN) 返回左表全部记录,右表匹配不上显示NULL
保留所有用户,匹配其订单记录
右连接(RIGHT JOIN) 返回右表全部记录,左表匹配不上显示NULL
与左连接对称,应用较少
5. 多表纵向合并查询(UNION / UNION ALL) :UNION ALL合并结果集保留所有行(含重复行,速度快);UNION会对合并后的结果集执行去重操作。
6. 子查询(嵌套查询) :在SELECT内部嵌套另一个SELECT语句,通常与IN、NOT IN、EXISTS等关键字组合使用,解决“筛选条件依赖另一张表统计结果”的复杂问题。
四、数据库、DBMS与SQL 的三角关系 DATABASE、DBMS与SQL
数据库(DATABASE) :是实际 存储数据的容器,可视为各种数据实体(表)的集合。DBMS(Database Management System,数据库管理系统) :是用于操作和管理数据库的软件系统 ,例如MySQL 、Oracle等。SQL 编程语言 。它是一套通用的标准语言,用于向DBMS发送指令,去读取、更新和操作Database中的结构化数据。
五、实战演练:从一份“电商订单分析需求”完成完整的SQL 查询 背景 你是某电商公司的CDA数据分析师。数据库中有三张核心表:
用户表(user) :user_id(主键)、user_name、city、reg_date订单表(orders) :order_id(主键)、user_id、order_amt、order_status、order_date商品表(product) :product_id(主键)、product_name、category
分析任务:筛选出近3个月的已支付订单 ,统计每个城市 已支付订单的总金额(GMV),并筛选出GMV大于10万元的城市 。
完整操作流程 阶段一:数据获取与多表横向连接(INNER JOIN)
SELECT FROM orders oINNER JOIN user u ON o.user_id = u.user_idWHERE o.order_status = '已支付' AND o.order_date >= DATE_SUB (CURDATE (), INTERVAL 3 MONTH );阶段二:分组汇总与分组筛选(GROUP BY + HAVING)
SELECT SUM (o.order_amt) AS city_gmvFROM orders oINNER JOIN user u ON o.user_id = u.user_idWHERE o.order_status = '已支付' AND o.order_date >= DATE_SUB (CURDATE (), INTERVAL 3 MONTH )GROUP BY u.cityHAVING city_gmv > 100000 ORDER BY city_gmv DESC ;关键考点 :WHERE在分组之前筛选原始订单数据;GROUP BY按城市聚合;HAVING在聚合计算之后筛选结果;ORDER BY最终排序输出。这个完整流程覆盖了CDA一级要求的主要SQL 核心语法,从数据连接到条件筛选、从分组汇总到筛选输出,展现了数据库查询在业务分析中的实际应用。
这就是一套完整的“数据连接 → 条件过滤 → 分组汇总 → 分组筛选 → 排序输出 ”的SQL 实战流程。
” 结尾 很多数据分析师会写SELECT * FROM,但当被问到“表和视图有什么区别”“内连接和左连接分别适用什么场景”“GROUP BY和HAVING的执行顺序是什么”时,却答不上来。
2025年新考纲进一步强化了对SQL 实际应用能力的考核,更侧重考查考生工作中的实际操作技能,确保认证价值与个人职业能力成长深度契合。新教材拓展了跨数据库通用查询语法,由旧版仅针对MySQL 扩展到覆盖SQL Server等主流数据库,并强化了模型合理性检验等实战内容。
数据库应用(PART 8)是CDA一级“从数据接入走向分析输出”的全链路枢纽,将表结构 处理、SQL 查询与业务数据分析紧密衔接。这部分考核贯穿数据库分类的领会、表视图差异的熟记到SQL 多表连接与子查询的综合应用,确保每一位CDA分析师都具备从企业核心数据库中高效、准确获取数据的核心能力。
下一步行动 :
打开你企业的数据库管理工具,查看业务表的结构,理解表与表之间的关系和主键/外键连接 选择常用的几类SELECT加聚合函数进行分组统计,熟悉GROUP BY和HAVING的执行顺序 用INNER JOIN和LEFT JOIN连接用户表和订单表,对比数据量增减逻辑差异
数据库是企业数据的“心脏”,SQL 是CDA数据分析师与这颗心脏对话的“标准语言”;掌握它们,你才能真正让数据为你所用。
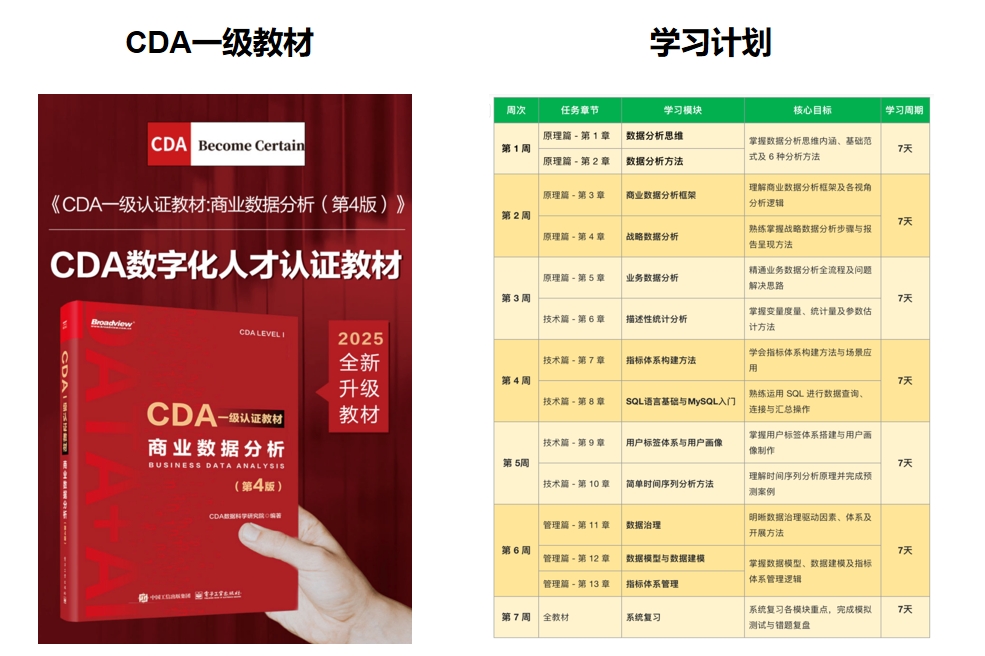
” 推荐学习书籍 《CDA一级教材 》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ ! 


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330