核心资源推荐
考点57:变量度量类型与分布类型
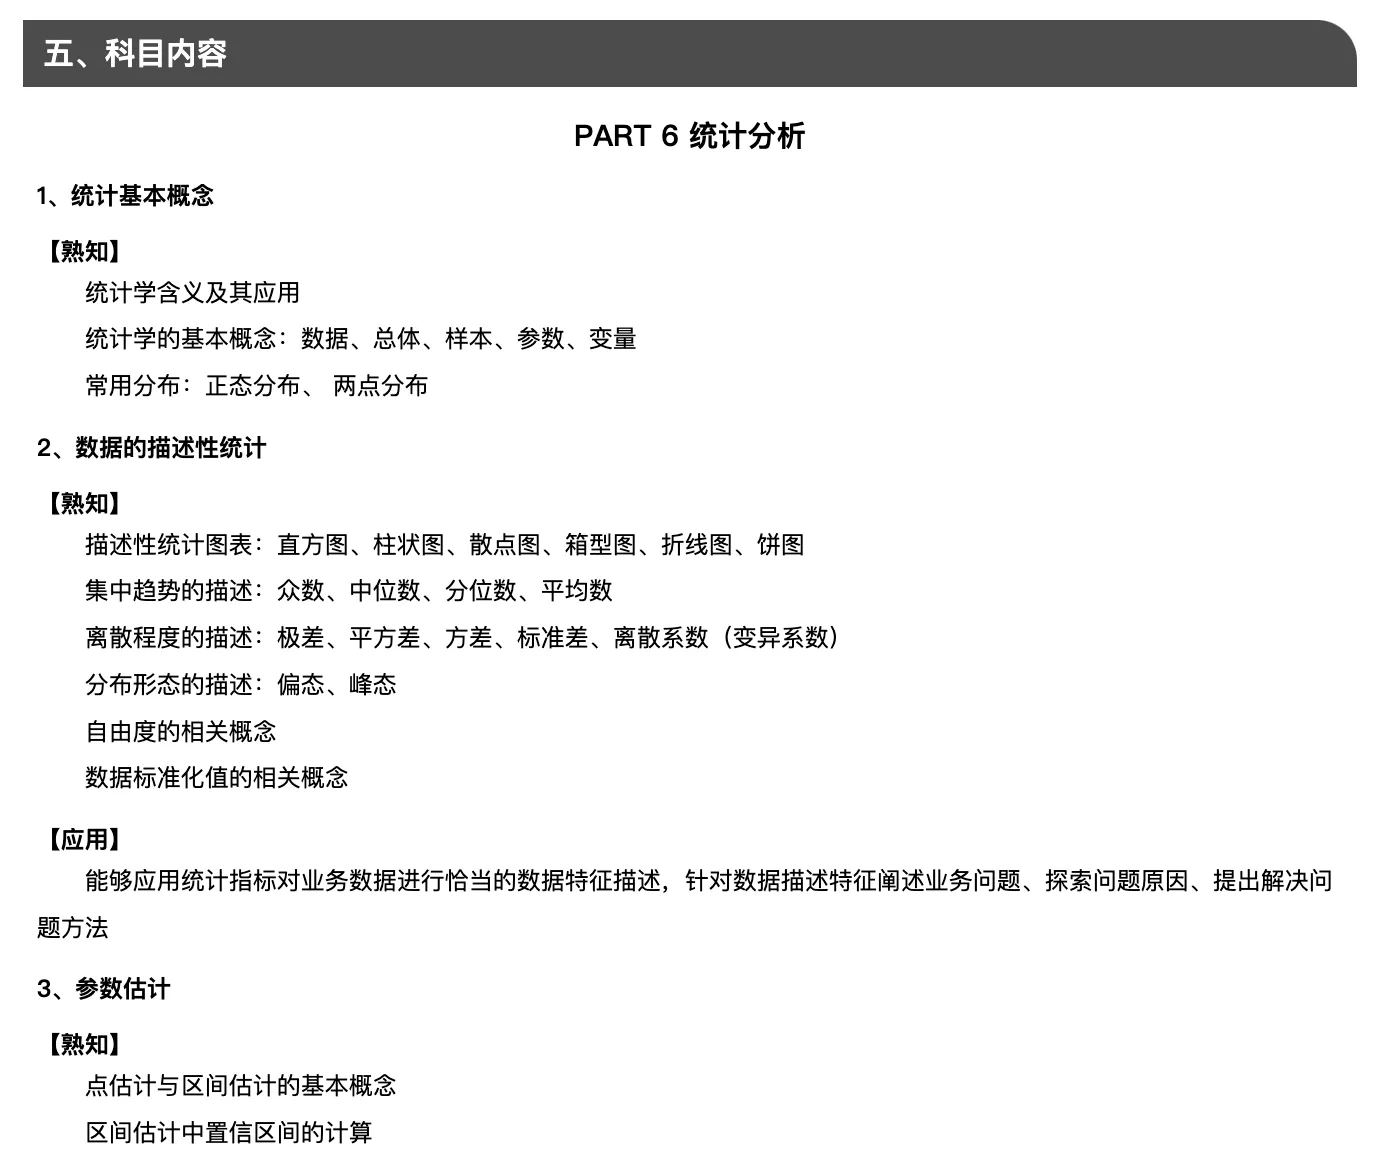
描述性统计分析的基础,明确变量的度量属性与分布特征,是后续统计量计算、统计制图的前提。
1. 变量度量类型(核心分类)
变量按度量属性分为分类变量与连续变量(含离散变量),两类变量的统计处理方式差异显著:
- 分类变量:
- 名义变量(无序):类别间无大小/次序关系,如性别(男/女)、民族、居住城市、行业类型;
- 等级变量(有序):类别间有明确高低/次序关系,如消费者满意度(高/中/低)、教育程度(小学<初中<高中<大学)、年龄段(青年/中年/老年);
- 关键说明:分类变量可能以数值编码存储(如“1=汉族、2=回族”),但数据分析时需按分类属性处理,不可直接进行数学运算(如求均值无意义)。
- 连续变量:
- 定义:在规定区间内可任意取值,取值为数值型且可进行数学运算;
- 包含离散变量:取值为有限个或可列个孤立数值(如家庭子女数、订单数量),商业数据分析中无需单独区分,统一归为连续变量处理;
- 示例:收入、网站流量、GDP、产品价格、交易金额。
2. 变量分布类型(核心假设与特征)
分布类型是对变量取值规律的抽象概括,商业数据分析中需基于分布假设选择分析方法:
离散数据的概率分布:
二项分布:描述固定次数独立实验中“成功”发生的概率(如多次营销触达的转化成功次数),由成功概率(p)和实验次数(n)定义;
伯努利分布:二项分布的特例(n=1),描述单次实验的成功/失败概率(如单次广告点击是否转化);
泊松分布:描述一定时间/空间内随机事件发生次数(如某时段内客服接起电话数量),仅由平均发生率(λ)定义,假设事件独立。
连续数据的概率分布:
均匀分布:变量各取值出现概率相同,无集中趋势,概率密度函数恒定(如随机抽样中的编号分布);
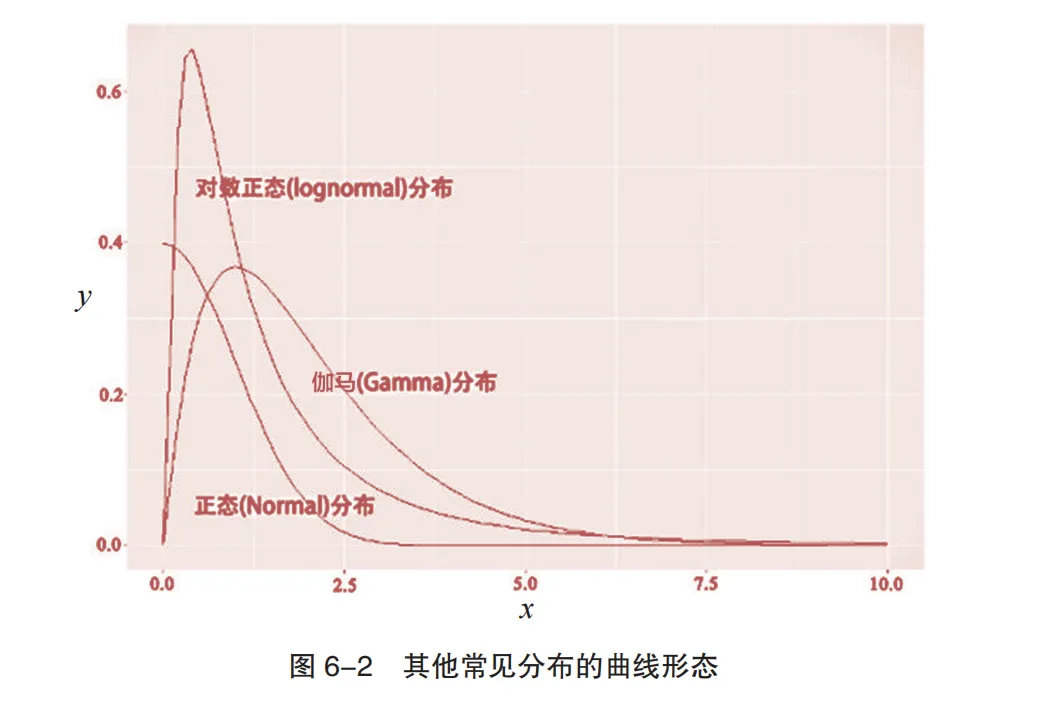
正态分布(高斯分布):核心分布类型,概率密度函数呈钟形对称,中心集中在均值(μ),由均值和标准差(σ)完全定义,满足“均值=中位数=众数”,常用于近似自然现象与业务数据(如用户消费金额分布);
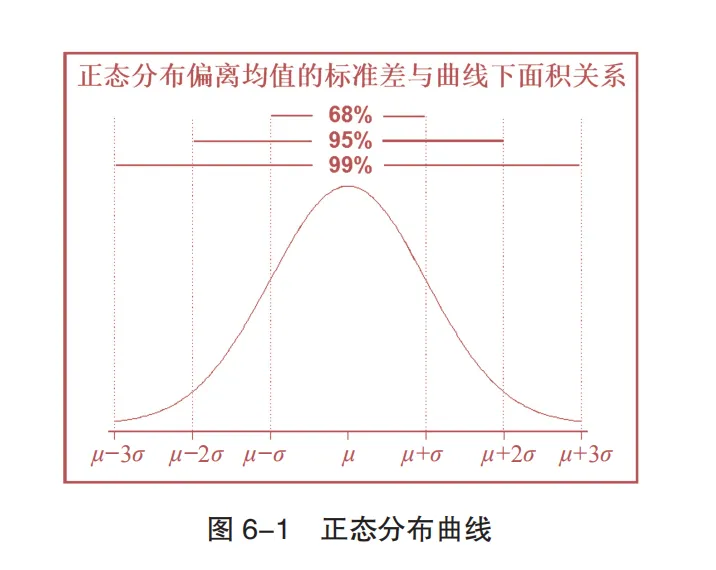
对数正态分布:变量取对数后服从正态分布,适用于原始数据呈指数增长的场景(如用户生命周期价值),是商业分析中处理右偏数据的常用分布;
伽马分布:描述事件发生一定次数的等待时间(如设备故障间隔时间),由形状参数和尺度参数定义;
指数分布:伽马分布的特例,描述独立随机事件的等待时间(如两次用户下单的间隔时间)。
3. 分布形态解读(以正态分布为例)
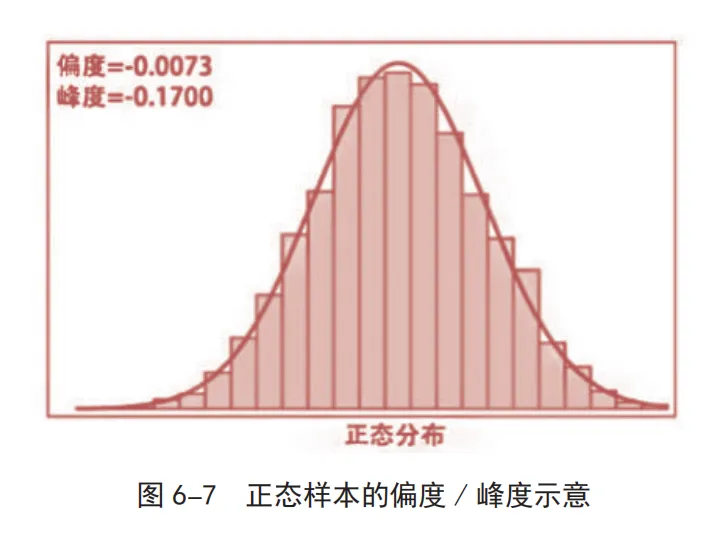
- 正态分布曲线特征:关于均值(μ)对称,呈钟形,68%的取值落在μ±σ范围内,95%落在μ±2σ范围内,99.7%落在μ±3σ范围内;
- 偏态分布说明:实际业务数据常偏离正态分布(如收入数据右偏),可通过对数转换等方式适配分析需求。
考点58:分类变量的统计量
针对分类变量的核心描述指标,用于概括类别分布特征,支撑后续可视化呈现。
核心统计量(按变量类型适配)
- 名义变量:仅需两类统计量即可完整描述:
- 频次:某类别出现的具体次数(如“未出险用户3028人”);
- 百分比:某类别频次占总样本的比例(如“未出险用户占比71.5%”)。
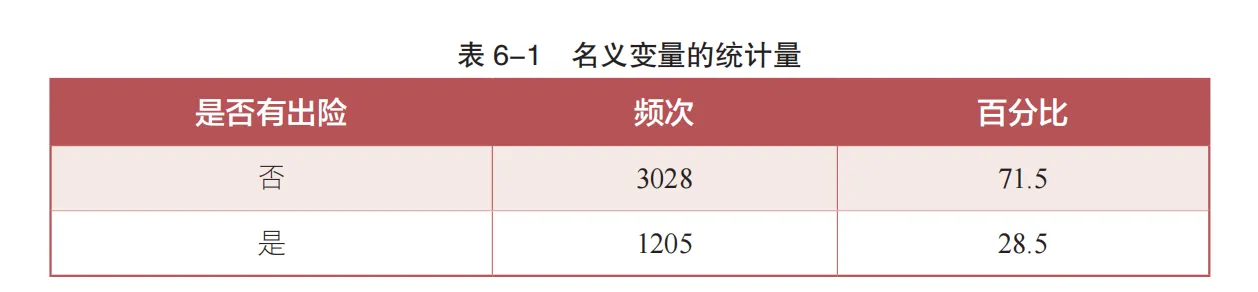
- 等级变量:需补充累积类统计量体现次序特征:
- 频次/百分比:与名义变量一致,描述单个类别的分布;
- 累积频次:从最低等级到当前等级的频次累计(如“满意度≥中等的用户累计250人”);
- 累积百分比:累积频次占总样本的比例(如“满意度≥中等的用户占比62.5%”)。
可视化呈现
分类变量的统计结果常用柱形图展示,以柱子高度对应频次或百分比,直观呈现类别分布差异(如“是否出险”的柱形图中,未出险类别柱子高于出险类别)。
考点59:连续变量的统计量
针对连续变量的核心描述指标,从集中趋势、离散程度、分布形状三个维度全面概括数据特征。
1. 集中趋势统计量(描述数据“中心位置”)
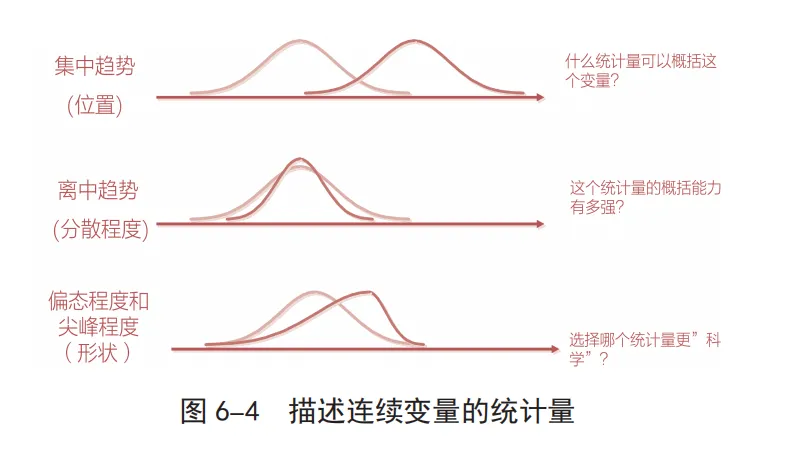
用于提炼数据的代表性数值,反映数据的整体水平:
平均数(均值):
- 定义:所有数据取值的算术平均,计算公式为 ( 为单个数据,n为样本量);
- 适用场景:数据分布较均匀、无极端值时(如正常用户的日均消费金额);
- 局限性:受极端值影响显著(如少数高收入人群会拉高整体平均工资),此时需结合其他指标使用。
中位数:
- 定义:将数据从小到大排序后,位于中间位置的数值(样本量为奇数时取中间值,偶数时取中间两个值的平均);
- 核心优势:不受极端值影响,适用于偏态分布数据(如收入、房价等右偏数据);
- 关联指标:四分位数(25%分位数Q1、75%分位数Q3)、百分位数(如90%分位数,反映前10%数据的临界值)。
众数:
- 定义:数据中出现频次最高的取值(如某商品最畅销的价格区间);
- 特点:可用于分类变量与连续变量,适用于描述“最常见”的特征,如“众数为300元,即300元价格的商品销量最高”。
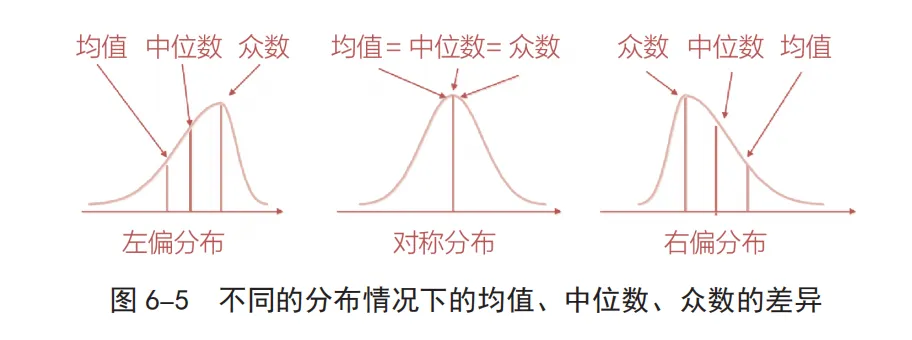
直方图是观察连续变量分布的最直观的工具。
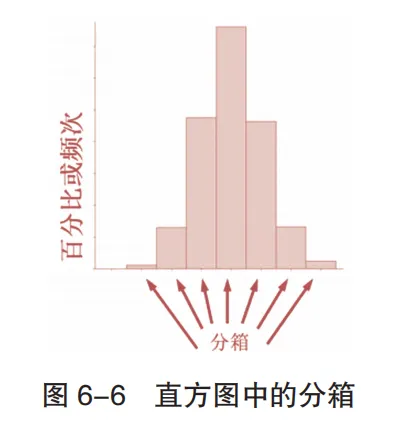
2. 离散程度统计量(描述数据“分散程度”)
反映数据取值的波动范围与离散情况,补充集中趋势指标的局限性:
- 极差:
- 定义:数据最大值与最小值的差值(极差=最大值-最小值);
- 特点:计算简单,但仅受两端极端值影响,无法反映中间数据的离散情况(如“收入极差为50万元,但多数用户收入集中在5-10万元”)。
- 方差与标准差:
- 方差:各数据与均值差值的平方和的平均值,计算公式为 ;
- 标准差(S):方差的平方根,与原数据单位一致,更易解读;
- 核心意义:标准差越小,数据越集中于均值;越大则波动越大(如“A产品标准差为50元,B产品为100元,说明A产品价格更稳定”)。
- 四分位距(IQR):
- 定义:75%分位数(Q3)与25%分位数(Q1)的差值(IQR=Q3-Q1);
- 优势:剔除极端值影响,仅反映中间50%数据的离散程度,适用于偏态数据。
3. 分布形状统计量(描述数据“分布形态”)
补充集中趋势与离散程度,明确数据的偏斜与陡峭特征:
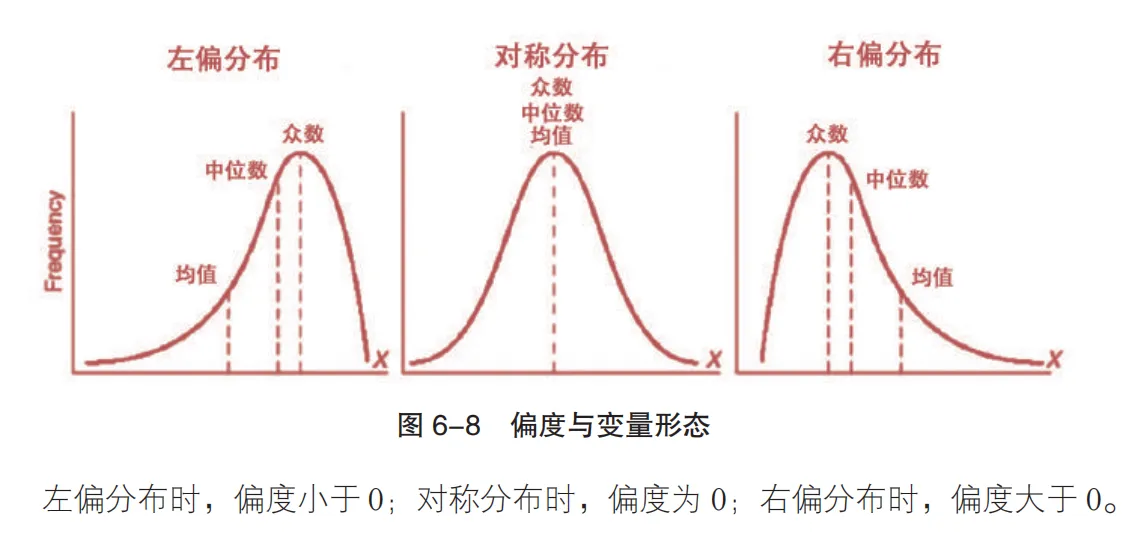
- 偏态系数:
- 定义:衡量数据分布的不对称程度,取值范围无绝对限制;
- 解读:系数>0为右偏(长尾在右,如收入数据,少数高收入拉偏);系数<0为左偏(长尾在左,如考试成绩,少数低分拉偏);系数=0为对称(如正态分布)。
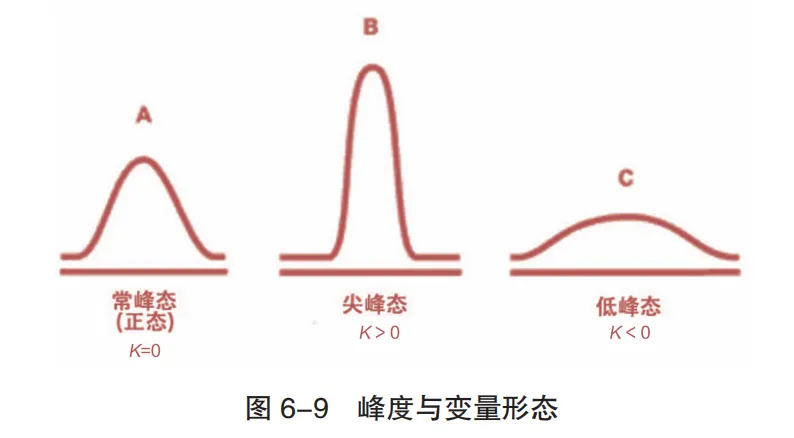
- 峰态系数:
- 定义:衡量数据分布的陡峭程度,以正态分布的峰态系数(0)为基准;
- 解读:系数>0为尖峰分布(数据集中于均值,极端值少,如核心用户的消费金额);系数<0为平峰分布(数据分散,极端值多,如广泛用户的随机浏览时长)。
看到这里,无论你是想入行数据分析的新手,还是已经走在 CDA 认证备考路上的同学,不必等整块的学习时间,用好日常零碎时间,跟着下面的计划现在就能开始。
| 时间段 |
任务章节 |
手册对应考点 |
核心目标 |
| 10月14日-10月17日 |
第一章 数据分析思维
第二章 数据分析方法 |
1-26 |
掌握数据分析思维内涵、基础范式及6种分析方法,掌握数据分析方法体系与典型应用,完成第一章、第二章练习题 |
| 10月18日-10月21日 |
第三章 商业数据分析框架
第四章 战略数据分析 |
27-51 |
理解商业数据分析框架及各视角分析逻辑,熟练掌握战略数据分析步骤与报告呈现方法,完成第三章、第四章练习题 |
| 10月22日-10月27日 |
第五章 业务数据分析
第六章 描述性统计分析 |
52-62 |
精通业务数据分析全流程及问题解决思路,掌握变量度量、统计量及参数估计方法,完成第五章、第六章练习题 |
| 10月28日-11月6日 |
第七章 指标体系构建方法
第八章 SQL语言基础与MySQL |
63-70 |
学会指标体系构建方法与场景应用,熟练运用SQL进行数据查询、连接与汇总操作,完成第七章、第八章练习题 |
| 11月7日-11月10日 |
第九章 用户标签体系与用户画像
第十章 简单时间序列分析方法 |
71-79 |
掌握用户标签体系搭建与用户画像制作,理解时间序列分析原理并完成预测案例,完成第九章、第十章练习题 |
| 11月11日-11月14日 |
第十一章 数据治理
第十二章 数据模型与数据建模第
十三章 指标体系管理 |
80-103 |
明晰数据治理驱动因素、体系及开展方法,掌握数据模型与数据建模逻辑,掌握指标体系管理逻辑,完成第十一章、第十二章、第十三章练习题 |
| 11月15日-11月25日 |
全教材系统复习 |
-- |
系统复习各模块重点,完成模拟测试与错题复盘 |
上一篇:CDA教材知识点 | 业务数据的特征、处理与透视分析(考点55-56)
CDA教材知识点合集(持续更新中)
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330