在CDA(Certified Data Analyst)数据分析师的工作链路中,数据读取是连接原始数据与后续分析的关键桥梁。如果说数据采集 是“获取数据原料”,那么数据读取就是“打开原料仓库”的核心动作——只有精准、高效地读取数据,才能为数据清洗 、建模、洞察挖掘筑牢基础。随着企业数据量激增、数据格式 愈发多元(结构化、半结构化、非结构化),掌握科学的数据读取方法、规避读取过程中的常见陷阱,已成为CDA必备的核心基本功。本文将系统拆解CDA数据读取的核心价值、常用方法、全流程实操要点与避坑指南,助力CDA高效完成数据读取环节,提升整体分析效率与质量。
一、核心认知:数据读取对CDA的价值与核心原则 数据读取并非简单的“打开文件”或“查询数据”,而是CDA基于分析需求,精准定位数据来源、选择适配读取方式、验证数据完整性的过程。其核心价值在于快速获取符合需求的数据,同时规避因读取方式不当、数据理解偏差 导致的后续分析失误。
1. 数据读取的核心价值 对CDA而言,规范的数据读取能实现三大核心价值,直接影响分析工作的效率与质量:
提升分析启动效率 :精准的读取方法能快速定位并提取目标数据,避免在“找数据、试读取”上浪费时间,让CDA更快进入核心分析环节;
保障数据原始质量 :科学的读取方式能减少数据丢失、格式错乱等问题,保留数据的原始完整性,为后续清洗、建模减少不必要的返工;
适配多元分析需求 :不同分析场景(如实时监控、批量分析、深度建模)对数据读取的时效性、批量性要求不同,灵活的读取能力能精准匹配各类需求。
2. CDA数据读取的核心原则 为确保数据读取环节精准落地,CDA需遵循四大核心原则,避免出现方向性偏差 :
需求导向原则 :先明确分析目标,再确定读取的数据范围、字段 、时间维度,避免“全量读取、盲目筛选”。例如,分析“月度用户留存率”时,只需读取当月新增用户数据及后续留存节点数据,无需读取全年全量用户行为数据;
适配性原则 :根据数据格式 (CSV、Excel、数据库表、JSON、日志)选择对应的读取方法与工具,确保读取过程顺畅、数据格式 不错乱;
完整性校验原则 :读取后第一时间验证数据的完整性,包括字段 完整性、记录条数一致性、关键字段 无缺失,避免因读取不完整导致分析结论偏差 ;
高效性原则 :针对海量数据或实时数据,选择高效的读取方式(如批量读取、增量读取、分区 读取),平衡读取速度与资源占用。
实战提醒 :CDA在数据读取前,建议先梳理《数据读取需求清单》,明确数据来源、目标字段 、时间范围、格式要求与读取优先级,避免读取过程中反复调整。
二、CDA核心数据读取方法全解析 CDA日常工作中接触的数据格式 多样,不同数据格式 对应的读取方法与工具存在差异。以下是针对常见数据类型 的核心读取方法,涵盖工具选型、实操步骤与适用场景:
1. 结构化数据读取:企业核心业务数据的主流读取方式 结构化数据(如数据库表、CSV、Excel)是企业最核心的数据类型 ,包含订单数据、用户数据、销售数据等,也是CDA最常读取的对象。
(1)数据库表读取:海量结构化数据的核心读取方式
适用场景 :读取企业内部数据库(MySQL 、Oracle、Hive 、ClickHouse等)中的业务数据,适用于批量数据查询、海量数据提取 场景;
工具与实操 :①使用SQL 语句:通过SELECT语句精准筛选目标字段 与数据范围,常用语法包括字段 筛选(SELECT 字段 1,字段 2)、条件过滤(WHERE 时间>'2025-01-01')、限制条数(LIMIT)、排序(ORDER BY);②工具辅助:通过Navicat、DBeaver等数据库可视化工具,图形化操作生成查询语句,直接读取数据并导出;③批量/增量读取:针对Hive 等大数据引擎,使用分区 查询(WHERE dt='2025-01-01')实现增量读取,减少资源占用;
优势 :读取精准度高,支持复杂条件筛选,可直接对接后续分析工具(如Python、BI工具);
注意事项 :①熟悉数据库表结构 与字段 含义,避免读取错误字段 (如混淆“订单金额”与“支付金额”);②海量数据读取时避免全表扫描,使用索引 优化SQL 语句;③注意数据权限,仅读取职责范围内的数据。
(2)CSV/Excel文件读取:轻量结构化数据的快速读取方式
适用场景 :读取本地或共享文件中的轻量数据(如小批量用户调研数据、月度销售汇总数据),适用于快速分析、临时数据处理 场景;
工具与实操 :①基础工具:通过Excel、WPS直接打开读取,适用于简单查看与筛选;②编程工具:使用Python的pandas 库,通过read_csv()、read_excel()函数读取,支持自定义分隔符、编码格式、表头行;例如:import pandas as pd; df = pd.read_csv('sales_data.csv', encoding='utf-8', sep=',');③BI工具:通过Tableau、Power BI直接导入文件读取,快速生成可视化图表;
优势 :操作简单、读取速度快,无需数据库权限,适用于轻量分析场景;
注意事项 :①读取CSV文件时注意指定正确的编码格式(如UTF-8、GBK),避免中文乱码;②读取Excel文件时注意区分工作表(sheet_name参数),避免读取错误工作表;③大文件(超过100MB)不建议用Excel直接打开,优先使用Python或数据库工具批量读取。
2. 半结构化/非结构化数据读取:复杂数据场景的关键读取方式 随着数字化发展,CDA需处理的半结构化数据(JSON、XML)、非结构化数据(日志、文本、图片)日益增多,这类数据的读取需针对性选择方法。
(1)JSON/XML数据读取:接口返回与配置数据的核心读取方式
适用场景 :读取API接口返回数据、系统配置文件、用户行为埋点数据(多为JSON格式),适用于实时数据获取、第三方数据对接场景;
工具与实操 :①Python编程:使用json库(loads()函数)解析JSON字符串,将其转化为字典/列表便于处理;使用xml.etree.ElementTree库解析XML文件;例如:import json; data = json.loads(api_response);②专业工具:通过Postman调用API后直接查看JSON数据,或使用Notepad++打开JSON/XML文件,安装格式化插件便于读取;
注意事项 :①解析前先查看数据结构 (如通过print(data.keys())查看JSON顶层字段 ),避免层级定位错误;②处理嵌套较深的JSON数据时,使用递归或循环逐层提取,避免数据遗漏;③注意数据类型 转换(如将JSON中的字符串格式时间转为datetime类型)。
(2)日志数据读取:用户行为与系统运行数据的读取方式 日志数据多为非结构化文本(如APP操作日志、服务器运行日志),格式灵活但读取难度较高。
适用场景 :分析用户行为路径、排查系统故障、监控服务器性能,适用于深度行为分析与系统运维分析场景;
工具与实操 :①轻量读取:使用Notepad++、Sublime Text打开日志文件,通过搜索功能定位关键信息;②批量解析:使用Python的re库(正则表达式 )提取日志中的核心字段 (如用户ID、行为类型、时间戳、设备信息);③海量日志:通过ELK Stack(Elasticsearch、Logstash、Kibana)实现日志的批量读取、结构化处理与可视化;例如:用Logstash配置正则表达式 过滤日志,提取目标字段 后存入Elasticsearch,再通过Kibana查询读取;
优势 :能处理非结构化文本数据,适配日志数据的灵活格式;
注意事项 :①先梳理日志格式规则(如字段 分隔符、时间格式),再编写解析规则;②使用正则表达式 时注意匹配准确性,避免漏提或错提数据;③海量日志读取时优先使用分布式工具,避免本地工具卡顿。
三、CDA数据读取全流程:从需求到验证的闭环管理 高效的数据读取并非单一方法的应用,而是一套“需求梳理→工具选型→数据读取→质量验证→格式适配”的闭环流程。CDA需全程把控,确保每个环节衔接顺畅,为后续分析做好准备。
1. 第一步:需求梳理——明确读取目标 结合业务分析需求,明确核心读取目标:①数据来源(数据库、文件、接口、日志);②目标字段 (需读取的核心字段 清单,剔除无关字段 );③时间范围(如近3个月、2025年Q1);④数据量级(预估读取数据条数,判断读取工具与方式);⑤后续用途(如用于Python建模、BI可视化、报表统计)。
2. 第二步:工具选型——匹配数据类型 与需求 根据数据类型 与读取需求选择适配工具:①结构化海量数据:优先选择数据库SQL 查询+Python批量读取;②轻量结构化数据:选择Excel直接读取或pandas 快速读取;③API接口数据:选择Python+requests 库调用接口后解析读取;④海量日志数据:选择ELK Stack批量读取与解析。
3. 第三步:数据读取——精准执行读取操作 按照选型的工具与方法执行读取操作,过程中注意:①参数配置准确(如文件编码、分隔符、数据库连接信息);②海量数据读取时采用分批读取策略(如pandas 的chunksize参数),避免内存溢出;③实时数据读取时注意接口调用频率限制,避免触发封禁。
4. 第四步:质量验证——确保数据可靠 这是数据读取的关键环节,CDA需通过多重校验确保数据质量 :①字段 完整性校验:检查目标字段 是否全部读取,无缺失;②记录条数校验:对比读取后的数据条数与预期(如数据库查询结果条数、文件总行数),确认无遗漏;③关键字段 有效性校验:检查关键字段 (如时间、金额、用户ID)格式是否正确、无异常值 (如时间为“0000-00-00”、金额为负数);④一致性校验:对比不同来源的同一数据(如数据库表数据与导出CSV数据),确保读取结果一致。
5. 第五步:格式适配——对接后续分析 将读取并验证后的data调整为适配后续分析的格式:①Python建模:将数据转化为DataFrame 格式,规范字段 类型(如将字符串时间转为datetime、金额字段 转为float);②BI可视化:将数据导出为CSV/Excel格式,或直接对接数据库,确保字段 名称规范、无重复;③报表统计:整理数据为表格形式,补充字段 说明,便于报表制作。
四、CDA数据读取避坑指南:常见误区与应对策略 CDA在数据读取过程中,常因忽视细节导致数据质量 问题或效率低下,需重点规避以下误区:
1. 误区1:全量读取数据,忽视需求筛选 表现:直接读取全表数据或完整文件,再进行筛选,导致内存占用过大、读取速度慢;规避:读取前通过SQL 条件、文件筛选参数精准定位目标数据,仅读取需要的字段 与记录。
2. 误区2:忽视编码格式,导致中文乱码 表现:读取CSV、JSON等文件时未指定编码格式,出现中文乱码;规避:优先尝试UTF-8编码,若乱码则切换为GBK、GB2312等编码格式,或通过文本工具查看文件原始编码。
3. 误区3:未验证数据完整性,直接用于分析 表现:读取后未校验字段 与条数,直接进入清洗或建模环节,导致后续发现数据缺失后返工;规避:将数据验证作为读取后的必选步骤,输出《数据读取验证报告》,确认数据无误后再推进。
4. 误区4:单一工具应对所有场景,效率低下 表现:无论数据量级与格式,均使用Excel读取,导致大文件卡顿或无法打开;规避:根据数据类型 、量级灵活选择工具,避免“一刀切”。
5. 误区5:忽视数据库性能,盲目执行复杂查询 表现:读取数据库数据时执行无索引 的全表扫描、复杂关联查询,导致数据库性能下降;规避:读取前查看表索引 ,优化SQL 语句,避免高峰时段执行海量数据查询。
五、结语:数据读取是CDA的“入门关”,更是“基础关” 对CDA数据分析师而言,数据读取看似是基础操作,实则直接决定了后续分析工作的效率与质量。在数据量日益庞大、格式愈发复杂的今天,CDA不能仅满足于“会读取”,更要追求“精准、高效、合规”地读取。
掌握不同数据类型 的读取方法,遵循“需求导向-工具适配-质量验证”的闭环流程,规避常见误区,能让CDA在数据读取环节少走弯路,将更多精力投入到核心的数据分析与价值挖掘中。未来,随着大数据技术的发展,数据读取的工具与方法会持续迭代,但“精准匹配需求、保障数据质量 ”的核心原则不会改变。CDA需持续学习新工具、新方法,不断提升数据读取能力,筑牢数据分析的基础,真正发挥数据的核心价值。
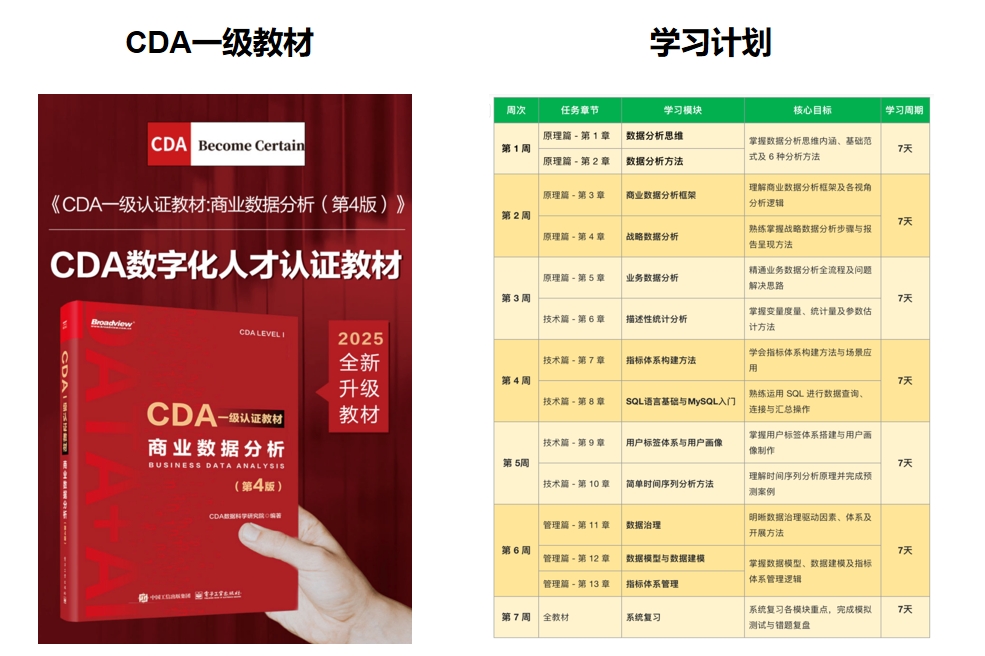
推荐学习书籍 《CDA一级教材 》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ ! 


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330