京公网安备 11010802034615号
经营许可证编号:京B2-20210330
SPSS聚类分析过程解析
SPSS手把手的教程案例不错,数据小兵是一个专注SPSS研究的博客,里面涉及SPSS各种经典分析方法的实际操作过程解析。今天给大家推荐的是《利用SPSS进行聚类分析的过程》。
案例过程涉及到spss层次聚类中的Q型聚类和R型聚类,单因素方差分析,Means过程等,是一个很不错的多种分析方法联合使用的 聚类分析案例。
案例数据源:有20种12盎司啤酒成分和价格的数据,变量包括啤酒名称、热量、钠含量、酒精含量、价格。数据来自《SPSS for Windows 统计分析》data11-03。
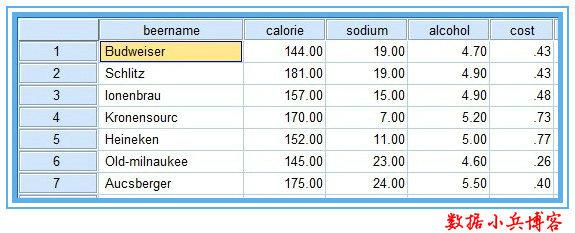
【一】问题一:选择那些变量进行聚类?——采用“R型聚类”
1、如何筛选聚类变量?现在我们有4个变量用来对啤酒分类,是否有必要将4个变量都纳入作为分类变量呢?热量、钠含量、酒精含量这3个指标是要通过化验员的辛苦努力来测定,而且还有花费不少成本,如果都纳入分析的话,岂不太麻烦太浪费?所以,有必要对4个变量进行降维处理,这里采用spss R型聚类(变量聚类),对4个变量进行降维处理。输出“相似性矩阵”有助于我们理解降维的过程。
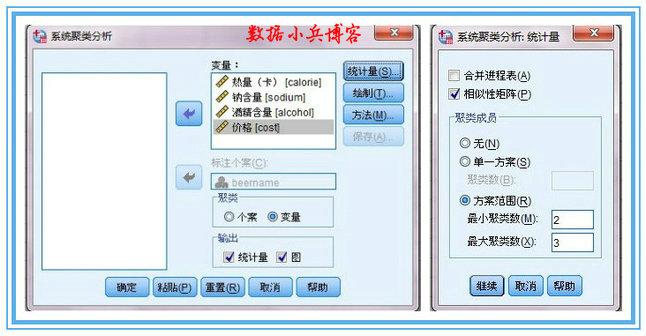
2、4个分类变量量纲各自不同,这一次我们先确定用相似性来测度,度量标准选用pearson系数,聚类方法选最远元素,此时,涉及到相关,4个变量可不用标准化处理,将来的相似性矩阵里的数字为相关系数。若果有某两个变量的相关系数接近1或-1,说明两个变量可互相替代。
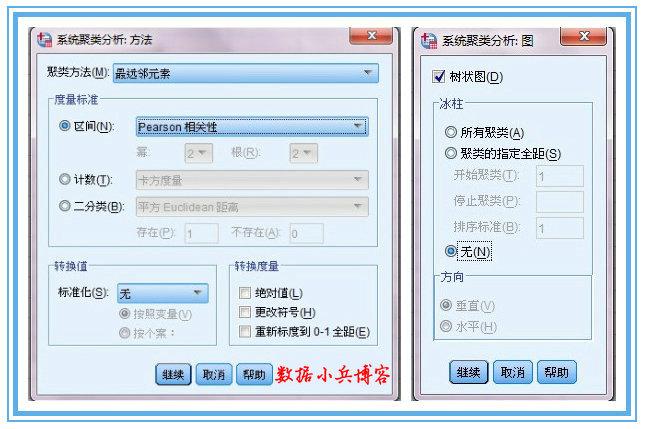
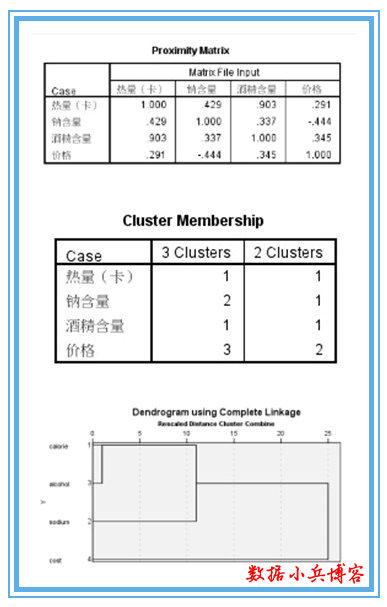
3、只输出“树状图”就可以了,个人觉得冰柱图很复杂,看起来没有树状图清晰明了。从proximity matrix表中可以看出热量和酒精含量两个变量相关系数0.903,最大,二者选其一即可,没有必要都作为聚类变量,导致成本增加。至于热量和酒精含量选择哪一个作为典型指标来代替原来的两个变量,可以根据专业知识或测定的难易程度决定。(与因子分析不同,是完全踢掉其中一个变量以达到降维的目的。)这里选用酒精含量,至此,确定出用于聚类的变量为:酒精含量,钠含量,价格。
【二】问题二:20中啤酒能分为几类?——采用“Q型聚类”
1、现在开始对20中啤酒进行聚类。开始不确定应该分为几类,暂时用一个3-5类范围来试探。Q型聚类要求量纲相同,所以我们需要对数据标准化,这一回用欧式距离平方进行测度。
2、主要通过树状图和冰柱图来理解类别。最终是分为4类还是3类,这是个复杂的过程,需要专业知识和最初的目的来识别。我这里试着确定分为4类。选择“保存”,则在数据区域内会自动生成聚类结果。
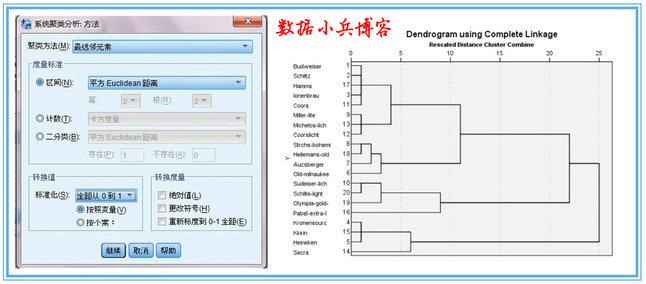
【三】问题三:用于聚类的变量对聚类过程、结果又贡献么,有用么?——采用“单因素方差分析”
1、聚类分析除了对类别的确定需讨论外,还有一个比较关键的问题就是分类变量到底对聚类有没有作用有没有贡献,如果有个别变量对分类没有作用的话,应该剔除。
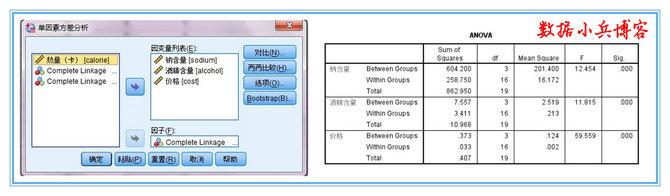
2、这个过程一般用 单因素方差分析来判断。注意此时,因子变量选择聚为4类的结果,而将三个聚类变量作为因变量处理。方差分析结果显示,三个聚类变量sig值均极显著,我们用于分类的3个变量对分类有作用,可以使用,作为聚类变量是比较合理的。
【四】问题四:聚类结果的解释?——采用”均值比较描述统计“
1、聚类分析最后一步,也是最为困难的就是对分出的各类进行定义解释,描述各类的特征,即各类别特征描述。这需要专业知识作为基础并结合分析目的才能得出。
2、我们可以采用spss的means均值比较过程,或者excel的透视表功能对各类的各个指标进行描述。其中,report报表用于描述聚类结果。对各类指标的比较来初步定义类别,主要根据专业知识来判定。这里到此为止。
数据分析咨询请扫描二维码
若不方便扫码,搜微信号:CDAshujufenxi
CDA数据分析师 出品 作者:李诗怡 定义: 用户增长核心分析框架,刻画用户从接触产品到自发推荐的全生命周期,五个递进环节构建 ...
2026-09-15在数字化营销与精细化用户运营时代,企业传统的广撒网式营销模式成本高、转化率低,已无法适配精准商业竞争需求。客户画像作为大 ...
2026-09-15 很多数据分析师精通描述性统计,能熟练计算均值、中位数、标准差,但当被问到“用500个样本如何推断10万用户的真实满意度” ...
2026-09-15在MySQL数据库数据查询与数据分析中,GROUP BY与ORDER BY是使用频率极高的核心关键字。二者语法结构相似,常搭配使用,但核心功 ...
2026-09-14随着数字化治理、智慧运营、数字孪生技术的普及,数字体征成为衡量业务状态、系统运行、城市治理与企业经营健康度的核心体系。数 ...
2026-09-14 很多数据分析师沉迷于复杂的模型和算法,却忽略了数据分析的一项基础能力——描述性统计。事实上,大量商业分析问题,用描述 ...
2026-09-14在MySQL数据库运维与开发实践中,经常出现一种典型现象:数据库实际存储的数据量很小,数据表条数少、文件体积低,但服务器整体 ...
2026-09-11 很多数据分析师能熟练计算均值、标准差,但当被问到“总体和样本有什么区别”“参数和统计量有什么关系”“数据级别的高低如 ...
2026-09-11CDA数据分析师 出品 作者:李诗怡 定义: 将同一时间段内因具备相同属性或共同经历的用户划分为群体,分析其留存与生命周期价值 ...
2026-09-11在零售、商超、餐饮、线下门店等实体商业运营中,客流与销售额是衡量门店经营状态的两大核心指标。销售额是门店经营的最终结果, ...
2026-09-10在数据可视化体系中,柱形图是最基础、应用最广泛的图表类型,其中**累计柱形图(堆积柱状图)**是兼顾整体总量与内部结构的核心 ...
2026-09-10 许多数据分析师精通Excel函数和SQL查询,但当面对一张上万行的销售明细表,要快速回答“哪个地区销量最高”“哪款产品增长最 ...
2026-09-10在Python Pandas数据分析中,DataFrame是承载结构化数据的核心载体,数据清洗、数据修正、条件赋值、字段更新等实操场景,都离不 ...
2026-09-09 很多数据分析师掌握了Excel函数、会写SQL查询,但当被问到“数据从哪里来”“数据加工有哪些步骤”“如何使用分析工具连接数 ...
2026-09-09卡方检验(Chi-Square Test)是统计学中针对分类数据的经典显著性检验方法,核心用于判断两个离散分类变量是否相互独立、数据实 ...
2026-09-09CDA数据分析师 出品 作者:李诗怡 1. 销售漏斗阶段判断 题目:销售漏斗模型中,通过广告、社交媒体等方式触达品牌信息(如浏览品 ...
2026-09-07在Python数据分析中,Pandas库的DataFrame是最核心、最常用的结构化数据表对象,类似于Excel的二维表格,具备规整的行列结构、字 ...
2026-09-07在数据分析、经营复盘、业绩预测与经济统计工作中,平均增速(平均增长率)是衡量数据长期变化趋势、业务发展快慢的核心指标。不 ...
2026-09-07 很多数据分析师精通Excel单元格操作,但当被问到“表结构数据的基本处理单位是什么”“字段和记录的本质区别”“为什么表结 ...
2026-09-07随着大数据技术的快速发展,商业竞争逐步从传统的经验式经营转变为数据驱动的精细化运营。海量的用户行为数据、交易数据、运营数 ...
2026-09-04