优化网站信息架构
如何让用户更方便快捷地在网站上寻找到他们需要的信息,当然不能脱离博客的主题——网站数据分析,所以这里主要介绍的是如何通过网站分析来优化网站,实现用户对信息的快速获取,首先介绍的是网站的信息架构。
关于信息架构,网站设计的同学才是专家,我在这里只是班门弄斧,根据大学里面阅读的信息架构类文献资料的一些残存的记忆,再加上这几天临时抱佛脚的简单温习,在这里表述一下我的一点拙见。
信息架构的定义
根据维基百科的定义,信息架构(Information Architecture,简称IA)是在信息环境中,影响系统组织、导览、及分类标签的组合结构。它是基于信息架构方法论,并运用计算机技术管理和组织信息的一个专门学科。信息架构并非一开始就应用于网站设计,其起源于情报科学,最初应该是用于图书馆等地方的信息组织和信息检索的。
《用户体验的要素——以用户为中心的WEB设计》这本书中对信息架构的定义基于网站设计:信息架构着重于设计组织分类和导航的结构,从而让用户可以提高效率、有效地浏览网站的内容。
具体的就不再多说的,可能各有各的理解,这里直接来看一个实例——Wordpress的信息架构模式:
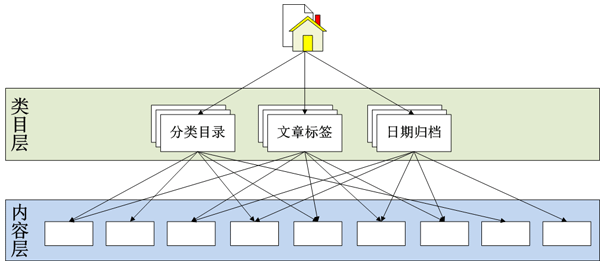
当然,上面这个图只能展示一个大体的网站信息架构,中间的类目层也许不止一层,会有大类、子类、子子类……底层可以是文章也可能是页面或者一些其他的具体内容。而网站的内部关系也往往因为全局或局部导航、网站内链和内容关联等功能的存在而复杂的多,图上的箭头也会密集很多,但我们无需罗列所有内容间的关系,关键是在理清基本的结构。
信息架构的类型
还是参考《用户体验的要素——以用户为中心的WEB设计》中对信息架构的几个分类:
层次结构(Hierarchical Structure)
也叫树形结构,是最常见的网站信息架构模式,上面举例的Wordpress的信息架构就是典型的层次结构。树形结构中箭头的方向不一定是自上而下的,也可能是自下而上或者是双向的,而内容层之间也会因为一些关联链接的存在而存在同层次间的指向箭头。
矩阵结构(Matrix Structure)
矩阵结构比较注重“维”的概念,即从多维的角度来检索信息,如时间、地域、内容分类等,典型的应用就是内容管理系统(CMS)网站或者电子商务类网站,比如你浏览豆瓣的电影时可以筛选:2010年—美国—科幻,也许这个时候《钢铁侠2》就呈现在你面前了。
线性结构(Sequential Structure)
看到线性结构也许你马上会想到面包屑,它将网站中最重要的一个信息架构路线展现了出来,即使它无法为你提供你在网站上的平面坐标,但至少它显示了你现在正处于关键线路的哪个点上;当然,网站的一些关键路径一般也是按照线性结构涉及的,比如用户注册流程或电子商务网站的购买流程等。
网站分析与信息架构
根据网站业务模式的不同,可以选择适合自己网站的信息架构的模式,无论是上面的哪种信息架构模式,只要设计和运用合理,用户便能够在你的网站上以最方便的形式、最快的速度找到他们需要的信息。
但当我浏览某些网站时,有时真的会让我感觉到“找不到北”,结果就是直接关闭该页面,如果不希望让已经进入了你的网站的用户轻易地离开,网站信息架构的好坏将直接影响网站的用户体验。所以我们需要通过一些方法来检验网站的信息架构是否满足用户的信息检索的需求。
1.尝试整理出类似上面例子中的网站信息架构图
这个是最简单最直观的方法,如果你的网站信息架构足够清晰,那么画出这样的图对你来说也绝非难事;而当网站的应用比较复杂、内容比较宽泛,那么可能要整理出网站的整体信息架构就会相对困难,但我相信一个设计优秀的网站只要稍加整理,大体的信息架构图还是画得出来的;而当你绞尽脑汁就是理不清你的网站的信息架构的头绪的时候,那么说明你的网站需要优化了。
2.通过网站分析的方法验证信息架构的合理性
本文的副标题是“让用户更容易地找到需要的信息”,所以我们需要分析用户是否能够在你的网站上方便快捷地找到他们需要的信息,这里推荐一种方法——寻找网站中的迷失用户(Lost Visits)。
在一个合理的信息架构下,大多数的用户是不会在你的网站上迷路的;反之,混乱的信息架构会导致大量的用户迷失方向,就像是进入了一个巨大的迷宫。那么如何寻找这些迷失用户?我们可以先分析下这类用户的行为,最明显特征的就是:连续点击好几个页面,每个页面都只是初步浏览(因为没有找到他们需要的信息)就转到另外的页面或直接离开了。所以我们可以借助网站分析中的两个度量:
浏览页面数(Depth of Visit):一次访问中用户总的浏览页面数;
页面平均停留时间(Avg. Time on Page):一次浏览中用户在每个页面的平均停留时间,即该次访问总停留时间(Time on Site)/该次访问页面数(Depth of Visit)。
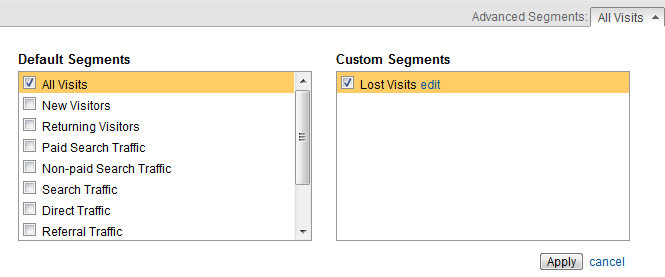
我们可以用户细分的方法把那些浏览页面数较多,但页面平均停留时间较短的用户浏览看作是迷失用户,具体的数值可以根据网站自身的特点进行定义,比如我定义我的博客中浏览页面数大于等于4,而页面平均停留时间小于等于15秒的Visits为迷失用户的浏览行为,我们可以借助Google Analytics中的高级群组(Advanced Segment)来区分出这类用户,关于如何使用Google Analytics的高级群组功能,可以参考蓝鲸的文章——Google Analytics功能篇—高级群组,如下图:
当然,你可能会说这种用户区分的方法不准确,这类用户不一定就是迷失用户,也有可能他们确实找到并浏览了具体内容,但因为内容不够吸引人或者其他原因而马上离开了该页面。所以这里用高级群组划分出来的这类Visits的数量不能看作是迷失用户的一个绝对数值,我们只能认为里面的大部分Visits都是迷失用户,而不排除存在某些另类。所以更合理的方法是通过计算这类Visits占网站总Visits的比例情况来分析网站的信息架构到底是否合理,我们可以在Google Analytics上面选取网站的All Visits和Lost Visits进行比例和趋势的比较,如下图:
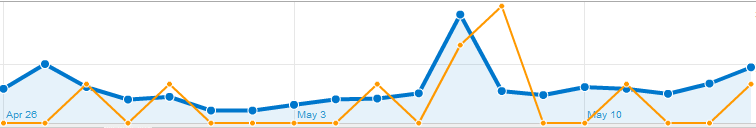
网站中迷失用户浏览的所占比例只需通过Lost Visits/All Visits就可以计算得到,但这个时候你还是无法根据这个计算结果来评判网站的信息架构到底是好是坏,因为还缺少一个基准线(Benchmark)或者说是评判标准。在Google Analytics上面的Visitors标签下,提供了“Sites of similar size”的基准比较(Benchmarking),你可以选择与你的网站相似类型的网站作为基准线进行数据比较,这的确是个很好的参考,因为通过比较能够更加明确你的网站在同类型网站中的优势和劣势,为网站优化指明方向。GA借助其强大的数据平台可以为我们提供基准线,但也许对于上面这个例子会显得无能为力,这个时候需要我们理性地自己去选择一个合适的基准线,比如我的博客目前类目和内容都还比较少,那么我可能会定义我的网站的迷失用户比例应该控制在1%以下;但如果对于一个应用和内容比较复杂的网站,那么基准线显然会需要定得更高一点。一旦某段时间的数据越过了基准线,就需要关注一下网站的信息架构是不是在趋于混乱了,是不是该进行一下整理和优化了。
总之,一个好的信息架构能够帮助用户更容易地找到他们需要的信息,从而有效地提升网站的用户体验,所以,尝试着去优化下你的网站的信息架构。如果你有更好的方法能够有效地检验网站的信息架构的优劣,或者能够明确地分析得到网站信息架构的哪些细节上存在缺陷,希望能与我交流,我期待网站分析方法在优化网站信息架构方面的更多的应用。


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330