R语言中大型数据集的回归
众所周知,R语言是一个依赖于内存的软件,就是说一般情况下,数据集都会被整个地复制到内存之中再被处理。对于小型或者中型的数据集,这样处理当然没有什么问题。但是对于大型的数据集,例如网上抓取的金融类型时间序列数据或者一些日志数据,这样做就有很多因为内存不足导致的问题了。
这里是一个具体的例子。在 R 中输入如下代码,创建一个叫 x 的矩阵和叫 y 的向量。
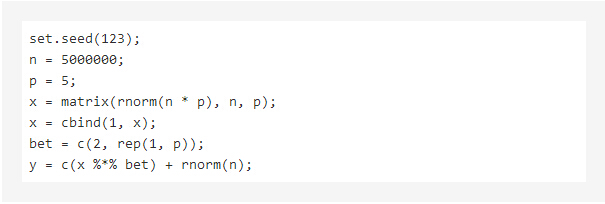
如果用内置的 lm 函数对 x 和 y 进行回归分析,就有可能出现如下错误(当然,也有可能因为内存足够而运行成功):
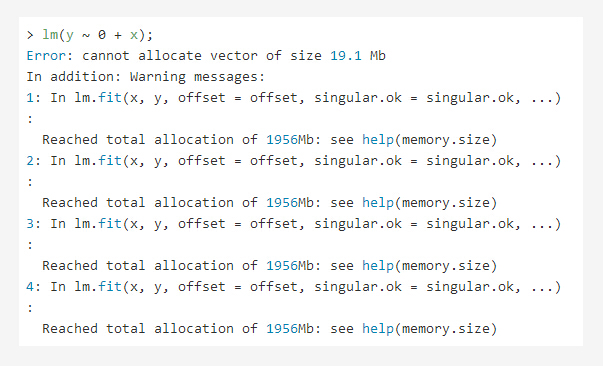
本文代码运行的电脑的配置是:
CPU: Intel Core i5-2410M @ 2.30 GHz
Memory: 2GB
OS: Windows 7 64-bit
R: 2.13.1 32-bit
在 R 中,每一个 numeric 数 占用 8 Bytes,所以可以估算到 x 和 y 只是占用 5000000 7 8 / 1024 ^ 2 Bytes = 267 MB,离运行的电脑的内存 2 GB 差很远。问题在于,运行 lm() 函数会生成很多额外的变量塞满内存。比如说拟合值和残差。
如果我们只是关心回归的系数,我们可以直接用矩阵运算来计算 β^ :

在本文运行的计算机中,这个命令成功执行, 而且很快(0.6秒)(我使用了一个优化版本的 Rblas, 下载)。然而,如果样本变得更加大了,这个矩阵运算也会变得不可用。可以估算出,如果样本大小为 2GB / 7 / 8 Bytes = 38347922 ,x 和 y 自己就会占用了全部内存,更不要说其他计算过程中出现的临时变量了。
怎么破?
一个方法就是用数据库来避免占用大量内存,并且直接在数据库中执行 SQL 语句等。数据库使用硬盘来保存数据,并且执行 SQL 语句时只是占用少量内存,所以基本上不用过于担心内存占用。不过有得有失,要更加关注完成任务所占用的时间。
R 支持很多数据库,其中 SQLite 是最轻量级和简单的。有一个 RSQLite 包,允许用户在 R 中对 SQLite 进行操作。这些操作包括了对 SQLite 数据库进行读写,执行 SQL 语句和在 R 中获取执行结果。所以,如果我们能够把需要的算法“翻译”到 SQL 语句版本,数据集的大小只受限于硬盘的大小和我们能够接受的执行时间。
采用上面的那个例子,我这里说明我们会怎样用数据库和 SQL 语句来对数据集进行回归。首先我们要把数据塞到硬盘上面。
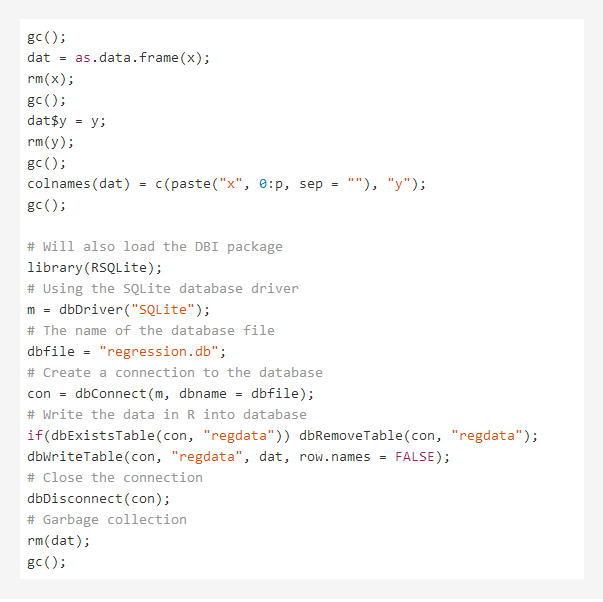
上述代码有很多 rm() 和 gc() ,函数,这些函数是用来移除没有用的临时变量和释放内存。当代码运行完毕的时候,你就会发现在你的工作空间中有一个 320M 左右的 regression.db 文件。然后就是最重要的一步了:把回归的算法转化为 SQL。
我们有
β^=(X′X)−1X′y
而且,无论 n 有多大,X′X 和 X′y 的大小总是 (p+1)∗(p+1) 。如果变量不是很多,R 处理矩阵逆和矩阵乘法还是很轻松的,所以我们的主要目标是用 SQL 来计算 X′X 和 X′y 。
由于 X=(x0,x1,…,xp),所以 X′X 可以表达为:
$$%
而每一个矩阵元素都可以用 SQL 来计算,比如说:
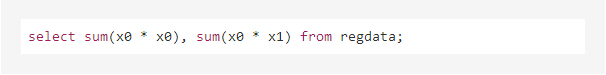
我们可以用 R 来生成 SQL 语句,然后把语句发送到 SQLite :
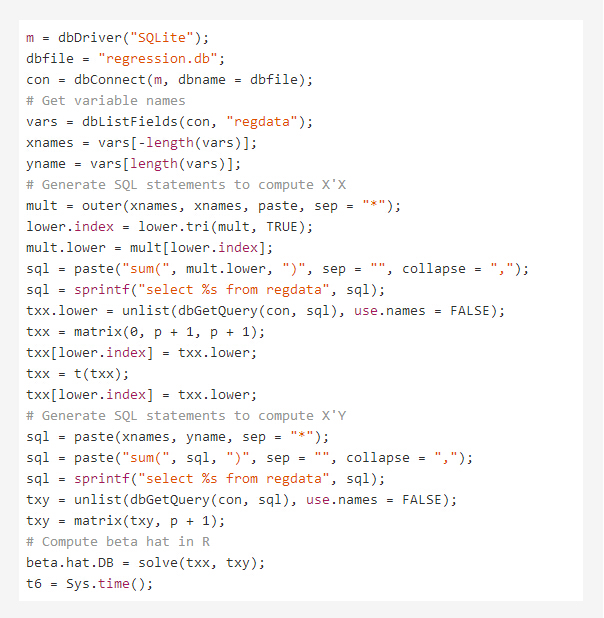
我们可以检查这个结果:
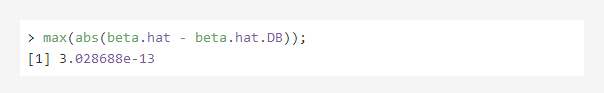
可以看出差别是舍入误差导致的。
以上计算用了大约 17 秒,远远超出矩阵运算的时间。不过它也几乎没有占用额外的内存空间。实际上我们采用了“时间换空间”的策略。此外,你可能还发现,我们可以通过多个对数据库的连接同步地计算 sum(x0*x0), sum(x0*x1), ..., sum(x5*x5) ,所以如果你有一个多核的服务器(而且硬盘足够快),你还可以通过适当的安排大量地减少运行时间。


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330