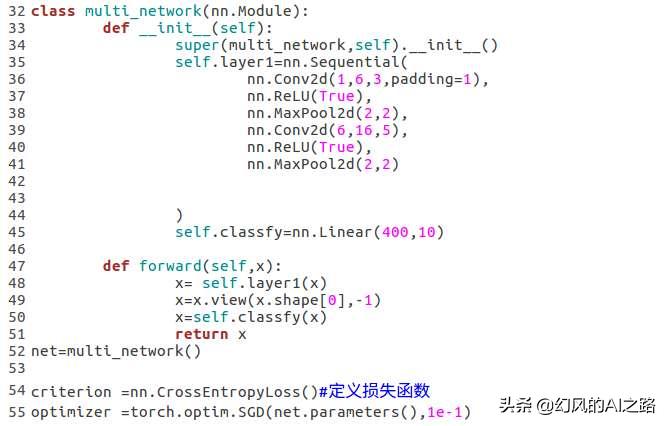
在深度学习的世界里,模型从 “一无所知” 到 “精准预测” 的蜕变,离不开两大核心引擎:损失函数与反向传播。作为最受欢迎的深度学习框架之一,PyTorch 凭借其动态计算图和自动求导机制,将这两大机制的实现变得灵活而高效。本文将深入解析 PyTorch 中损失函数的设计逻辑、反向传播的底层原理,以及二者如何协同推动模型参数优化,最终实现从数据到知识的转化。
一、损失函数:模型性能的 “裁判官”
损失函数(Loss Function)是深度学习训练的 “指南针”,它量化了模型预测结果与真实标签之间的差异,为模型优化提供明确的方向。在 PyTorch 中,损失函数不仅是一个计算指标,更是连接模型输出与反向传播的关键桥梁。
模型训练的本质是 “试错优化”:通过损失函数计算误差,再基于误差调整参数。例如,当训练图像分类模型时,若输入一张猫的图片,模型却预测为狗,损失函数会将这种 “错误” 转化为具体的数值(如交叉熵损失值)。这个数值越大,说明模型当前的参数配置越不合理,需要更大幅度的调整。
PyTorch 的torch.nn模块提供了丰富的内置损失函数,覆盖几乎所有主流深度学习任务,其设计逻辑与任务类型深度绑定:
回归任务:常用MSELoss(均方误差损失),通过计算预测值与真实值的平方差衡量误差,适用于房价预测、温度预测等连续值输出场景;
分类任务:CrossEntropyLoss(交叉熵损失)是标配,它结合了 SoftMax 激活和负对数似然损失,能有效处理多类别分类问题,广泛应用于图像识别、文本分类;
序列任务:NLLLoss(负对数似然损失)常与 LSTM/Transformer 结合,用于自然语言处理中的序列标注、机器翻译等场景;
自定义场景:对于特殊任务(如目标检测中的边界框回归),开发者可通过torch.autograd.Function自定义损失函数,只需实现前向计算(forward)和反向梯度计算(backward)逻辑。
选择合适的损失函数直接影响模型收敛速度和最终性能。例如,在样本不平衡的分类任务中,若直接使用交叉熵损失,模型可能偏向多数类;此时需改用WeightedCrossEntropyLoss,通过为少数类赋予更高权重平衡误差。
二、反向传播:误差梯度的 “回溯算法”
如果说损失函数是 “裁判”,那么反向传播(Backpropagation)就是 “教练”—— 它根据损失值计算每个参数的梯度,指导模型如何调整参数以降低误差。这一机制的核心是微积分中的链式法则,而 PyTorch 的自动求导引擎(Autograd)将这一复杂过程封装成了一行代码的操作。
深度学习模型由多层神经元组成,每一层的输出都是上一层输入与权重参数的非线性变换。假设模型参数为,损失函数为,反向传播的目标是计算损失对每个参数的偏导数,即 “梯度”。
以两层神经网络为例,输出,其中为激活函数。根据链式法则,损失对的梯度需从输出层反向推导:先计算对的梯度,再通过激活函数的导数传递至,最终得到所有参数的梯度值。这一过程如同 “从结果追溯原因”,精准定位每个参数对误差的贡献。
PyTorch 的动态计算图与 Autograd
PyTorch 的反向传播能力依赖于其动态计算图机制:当执行前向计算时,PyTorch 会实时构建一个记录张量运算的有向图,图中每个节点是张量,边是运算操作。例如,y = W @ x + b会生成包含 “矩阵乘法”“加法” 节点的计算图。
当调用loss.backward()时,Autograd 引擎会沿计算图反向遍历,根据链式法则自动计算所有 requires_grad=True 的张量(通常是模型参数)的梯度,并将结果存储在张量的.grad属性中。这一过程完全自动化,无需开发者手动推导梯度公式,极大降低了深度学习开发门槛。
需要注意的是,PyTorch 默认每次反向传播后会清空梯度(为节省内存),因此在多轮迭代中需通过optimizer.zero_grad()手动清零梯度,避免梯度累积影响参数更新。
三、协同工作流:从损失计算到参数优化
在 PyTorch 中,损失函数与反向传播并非孤立存在,而是与优化器(Optimizer)共同构成模型训练的 “铁三角”。其完整工作流程可概括为 “前向计算→损失评估→反向求导→参数更新” 的循环:
前向传播(Forward Pass):将输入数据传入模型,得到预测结果;
反向传播:调用loss.backward(),Autograd 沿计算图反向传播误差,计算所有参数的梯度;
参数更新:优化器(如 SGD、Adam)根据梯度调整参数,执行optimizer.step()完成一次迭代。
import torch
import torch.nn as nn
import torch.optim as optim
x = torch.tensor([[1.0], [2.0], [3.0], [4.0]], requires_grad=False)
y_true = torch.tensor([[2.0], [4.0], [6.0], [8.0]], requires_grad=False)
model = nn.Linear(in_features=1, out_features=1)
loss_fn = nn.MSELoss()
optimizer = optim.SGD(model.parameters(), lr=0.01)
for epoch in range(1000):
&
&
&
&
&
&
&
&
&
&
&
&
&
在这个示例中,损失函数(MSE)不断量化预测值与真实值的差距,反向传播通过loss.backward()计算权重和偏置的梯度,优化器再根据梯度将参数向降低损失的方向调整。经过 1000 轮迭代,损失值会逐渐趋近于 0,模型学到的映射关系。
四、进阶技巧:解决损失与反向传播的常见问题
在实际训练中,损失函数与反向传播的配置直接影响模型性能,以下是需重点关注的问题及解决方案:
1. 梯度消失与爆炸
当模型层数较深时,梯度可能在反向传播中逐渐趋近于 0(消失)或急剧增大(爆炸)。PyTorch 中可通过梯度裁剪缓解:
torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)
分类任务中误用 MSE 损失会导致梯度更新不稳定(因 SoftMax 与 MSE 组合的梯度特性),应优先选择交叉熵损失;回归任务若标签存在异常值,可改用L1Loss(平均绝对误差)增强鲁棒性。
3. 自定义损失函数的梯度实现
当内置损失函数无法满足需求时,自定义损失需确保backward方法正确实现梯度计算。例如,实现带权重的 MSE 损失:
class WeightedMSELoss(torch.nn.Module):
&
&
&
&
&
&
&
&
&
结语:理解核心机制,掌控模型训练本质
PyTorch 的强大之处,在于将损失函数的 “误差量化” 与反向传播的 “梯度计算” 无缝衔接,通过动态计算图和 Autograd 让复杂的深度学习训练变得直观可控。无论是基础的图像分类还是复杂的大语言模型训练,其核心逻辑始终围绕 “损失驱动梯度,梯度优化参数” 的循环。
深入理解这一机制,不仅能帮助开发者更高效地调试模型(如通过梯度大小判断参数是否有效更新),更能在面对特殊任务时灵活设计损失函数和优化策略。在深度学习从 “黑箱” 走向 “可控” 的过程中,掌握损失函数与反向传播的协同原理,是每个 PyTorch 开发者的必备素养。
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330