写在开头
先还原一个你大概率见过的场面。
立项会上有人说:我们得做用户画像。
于是团队关进会议室,白板写满便利贴,两小时后产出这么个人物——「李婷,32 岁,产品经理,一线城市,周末喜欢爬山、爱喝咖啡」,配一张素材站里笑得很职业的照片。贴在墙上,拍照存档。
三个月后有人问:李婷最想解决的问题是什么?
没人答得上来。
这篇原文的第一句话就很扎人:
大多数用户画像都是虚构作品。 它们在会议室里凭手感画出来,配一张库存照片和一个机灵的名字,然后在项目剩下的时间里被安静地忽略。
”
问题不在格式,不在模板,而在——它不是从证据里长出来的。所以没人真的信它,也就没人敢拿它做决定。
一、先记住一条规则
原文把整套方法论压在一句话里:
一份画像,只有在它能改变某个决策时,才值得做。如果你说不出它会影响哪个决策,那你做的其实是装饰品。
”
这句话是后面所有步骤的底色。它也是最好的自测题:拿你手上那份画像,说出一个被它改变过的具体决定。说不出来,它就该被合并或砍掉。
二、六步:从研究到一份活着的画像
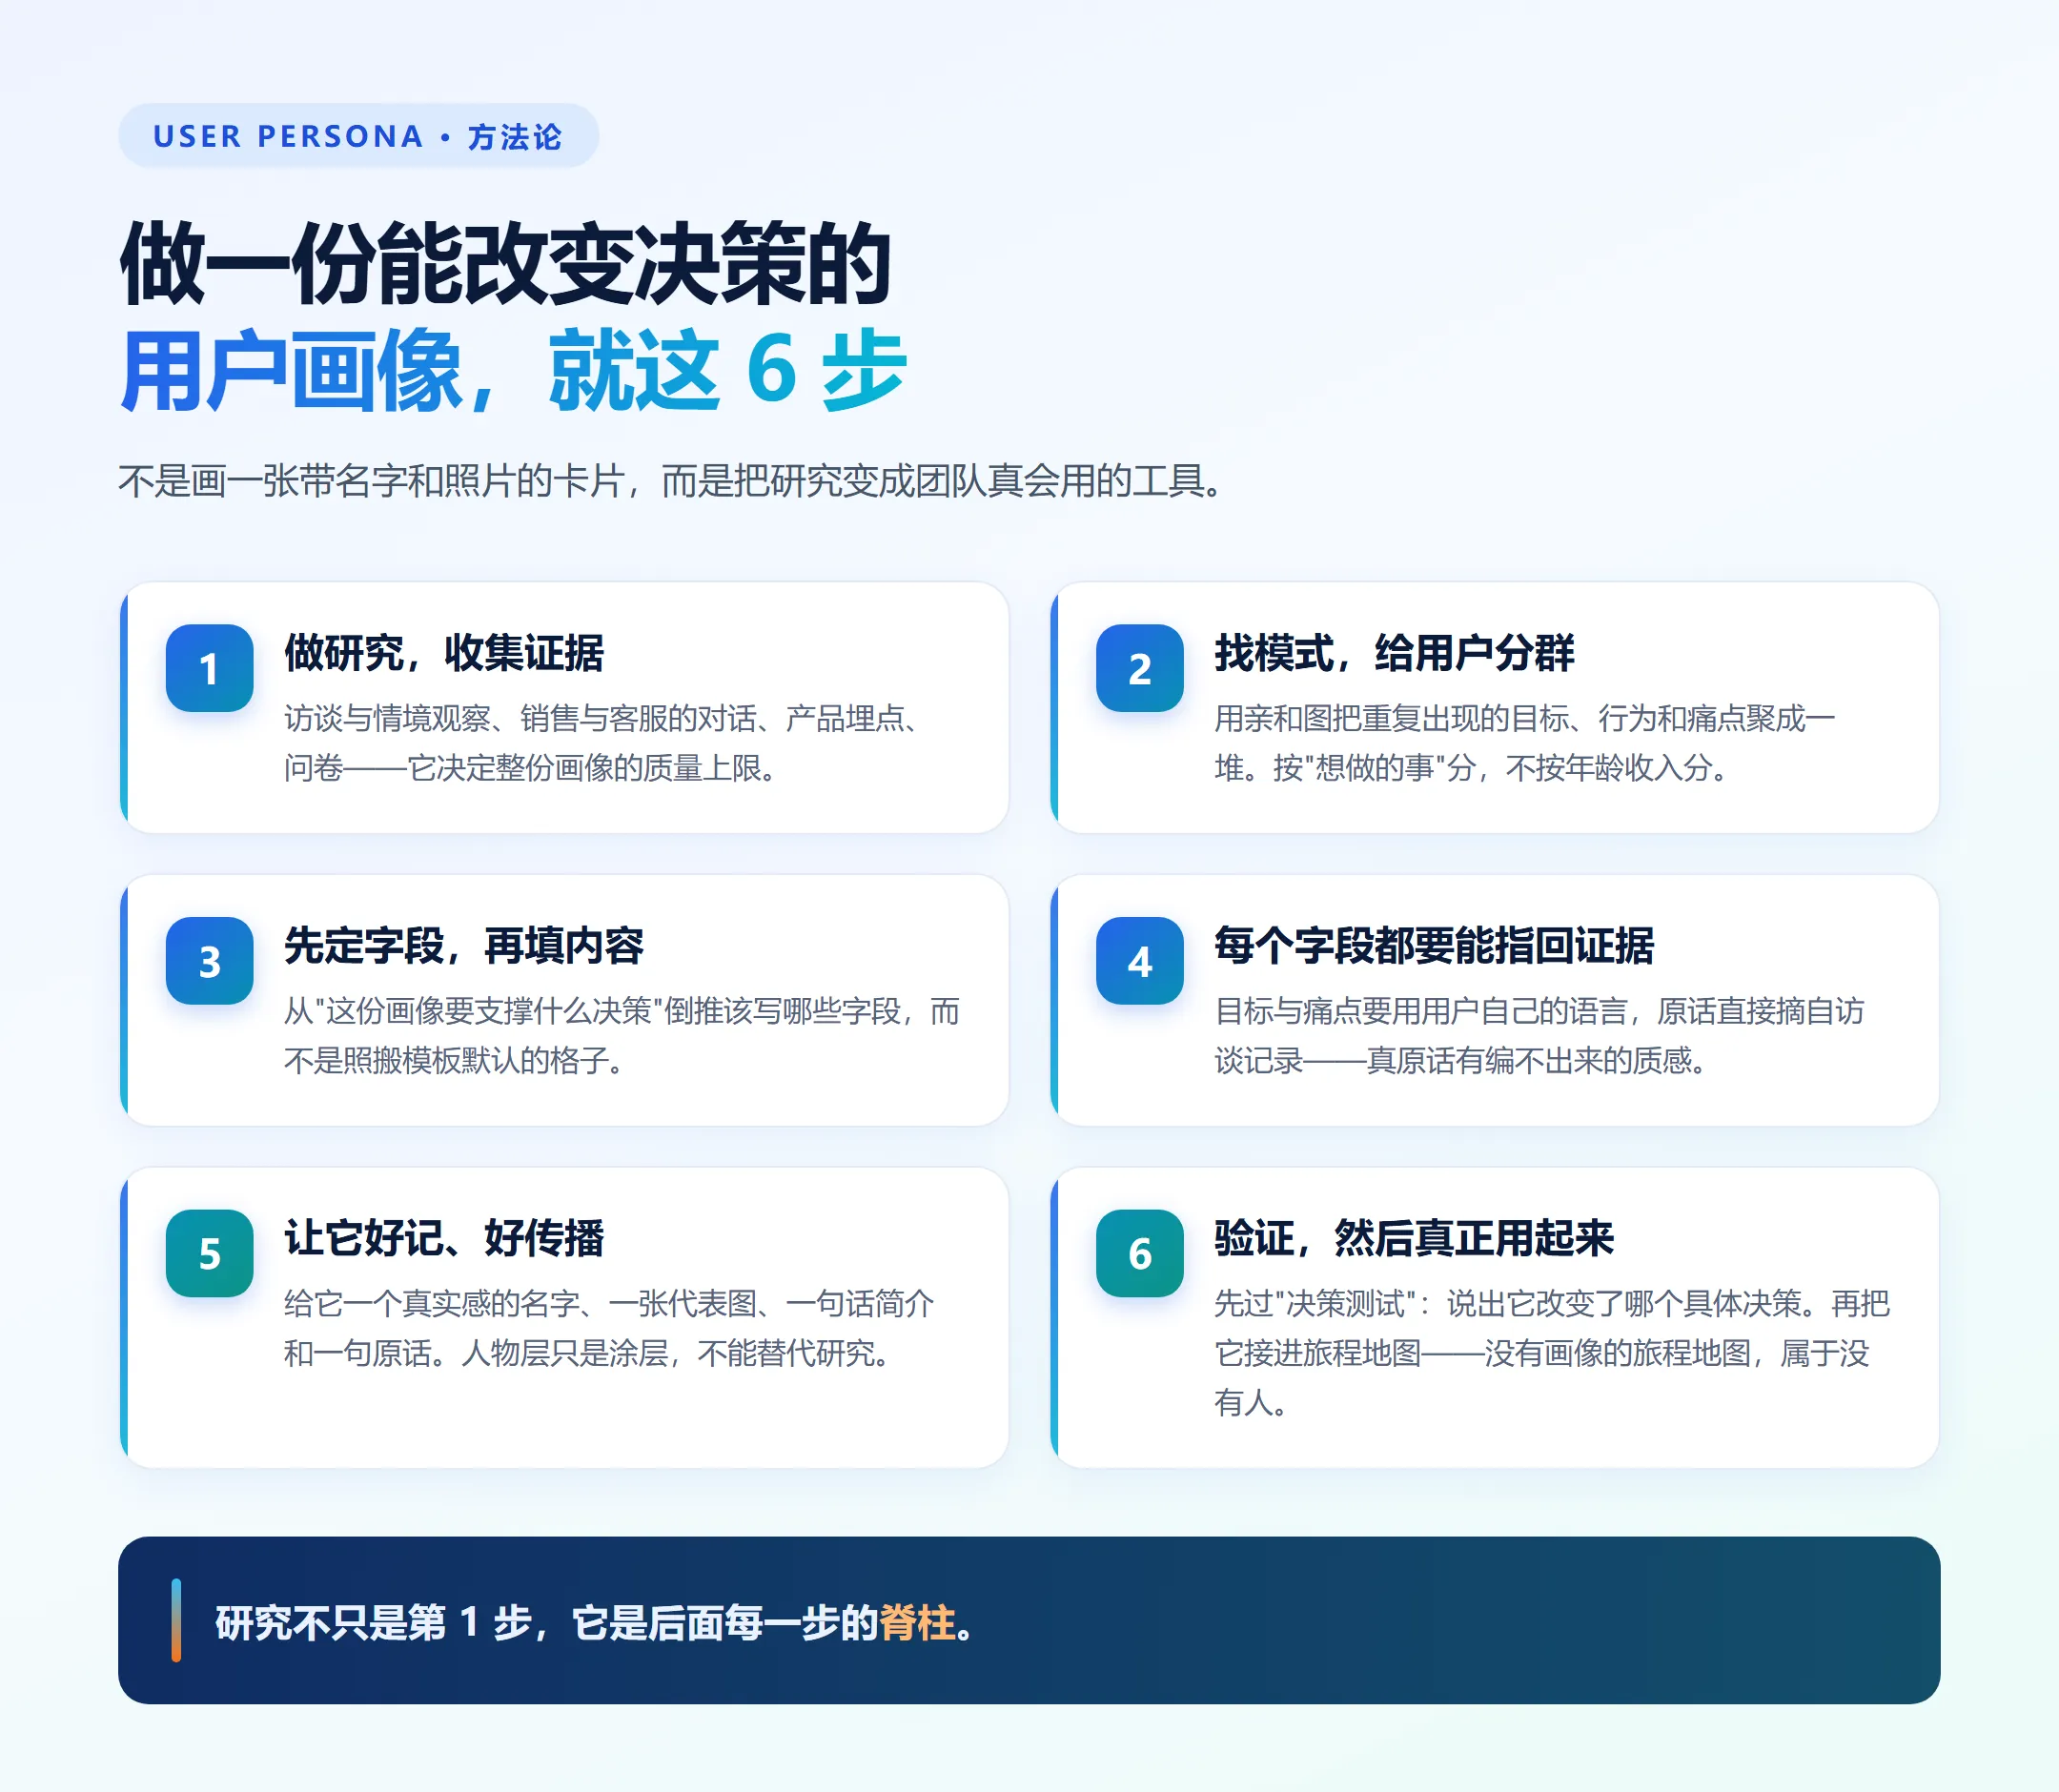 创建用户画像的 6 个步骤
- 做研究、收集证据 —— 访谈、埋点、工单、问卷。后面每一步都建在这一步之上。
- 找模式、给用户分群 —— 把重复出现的目标和行为,聚成真正有差异的群体。
- 先定字段 —— 按「要支撑什么决策」选字段,而不是照搬模板默认的格子。
- 用研究把字段填满 —— 每个字段都要有出处,原话直接摘自访谈记录。
- 让它好记、好传播 —— 名字、照片、一句话简介,让它能在会议上被引用。
- 验证,然后真正用起来 —— 拿真实用户验,过「决策测试」,接进旅程地图。
下面逐个说。
三、第 1 步:把证据拿回来
这一步是绝大多数指南敷衍过去的一步——它们说一句「先做点研究」,然后把剩下的篇幅全花在排版和配色上。
但画像质量的天花板,就是底下证据的质量。
原文建议混着用两类来源:定性研究告诉你人们「为什么」这样行动,定量数据告诉你这个行为「有多普遍」。
具体来源清单:
- 用户访谈与情境观察 —— 去看、去听,而不是让用户预测自己的行为
- 客服和销售的日常对话 —— 一个现成的、未经修饰的用户语言库,多数团队都浪费了
- 产品埋点 —— 它展示用户真正做了什么,而不是他们说自己做了什么
- 工单和 CRM 数据 —— 用客户自己的话说出反复出现的摩擦点
访谈问法上,原文给了一句可以直接抄的话术:
「能不能带我过一遍你上次做这件事的过程?」永远比「你希望有什么功能?」好用。
”
理由也很妙:
人们预测自己「会做什么」时很不可靠,但回忆自己「上周二做了什么」时相当可靠。
”
那到底要做多少研究才够?
原文的答案是:做到你不再听到新东西为止。
实践中大概是每个你怀疑存在的细分群体,访谈 5 到 8 个人。到这个量级,主题开始重复,新的访谈不再带来意外,只在确认——这个信号叫饱和(saturation)。
还有一条差异值得记住:
- B2B 研究通常需要更少但更深的对话,因为总体人群小、角色定义清楚
- B2C 更依赖定量的量,去确认一个模式在庞大且多样的用户基上站得住
最后,如果你现在完全没有研究,可以从「原型画像(proto-persona)」起步——用团队现有假设先写一版。但要明确标注它是待验证的假设,而不是成品。原型画像和研究型画像服务的是不同阶段,关键是别把前者当成后者。
四、第 2 步:找模式,然后分群
这一步是「研究型画像」和「精心装饰的猜测」之间的分界线,也是几乎所有人都会跳过的一步。
做法是把原始材料摊开,找出重复出现的目标、行为和痛点:给原话打标签,把互相呼应的丢成一堆,再给每一堆命名。这个技术叫亲和图(affinity mapping)——从原话到主题、从主题到分群的路径,就发生在这一步。
原文给了一个很实用的区分:
一条抱怨是段轶事。跨多个访谈、从十几个人嘴里说出同样的抱怨,才是值得围绕它做设计的模式。
”
然后是这一步最关键的判断标准——按行为和动机分群,不按人口统计分群:
| 按人口统计分群 |
按行为与动机分群 |
| 按年龄、收入、职位分组 |
按「用户想完成的那件事」分组 |
| 会把想要同一结果的人拆开 |
让目标相同的人留在一起 |
| 会把目标完全不同的人合在一起 |
把真正不同的需求分开 |
| 很少改变你实际做出来的东西 |
能直接映射到产品和设计决策 |
道理很简单:两个年龄、收入、职位完全相同的人,如果要做的事不同,就属于两个画像;两个纸面上毫无相似之处的人,如果行为一致、想要的结果一致,就是同一个画像。
还有一条防止画像膨胀的规则:
如果两个群体最终导向同一份路线图,那它们只是同一个人穿了两套衣服。
”
五、第 3 步:先决定「写什么」
先定字段,再填内容。而且字段要按它要支撑的决策来选——模板里默认的那几个格子,是别人的决策,不是你的。
原则只有一条:以目标、动机、行为和痛点为主,人口统计信息是背景,不是头条。
很多画像指南一边警告「别过度关注人口统计」,一边又把年龄和收入放在模板最上面。别犯这个错。
年龄很少改变你做出来的东西,但用户想完成的那件事,几乎总会。
”
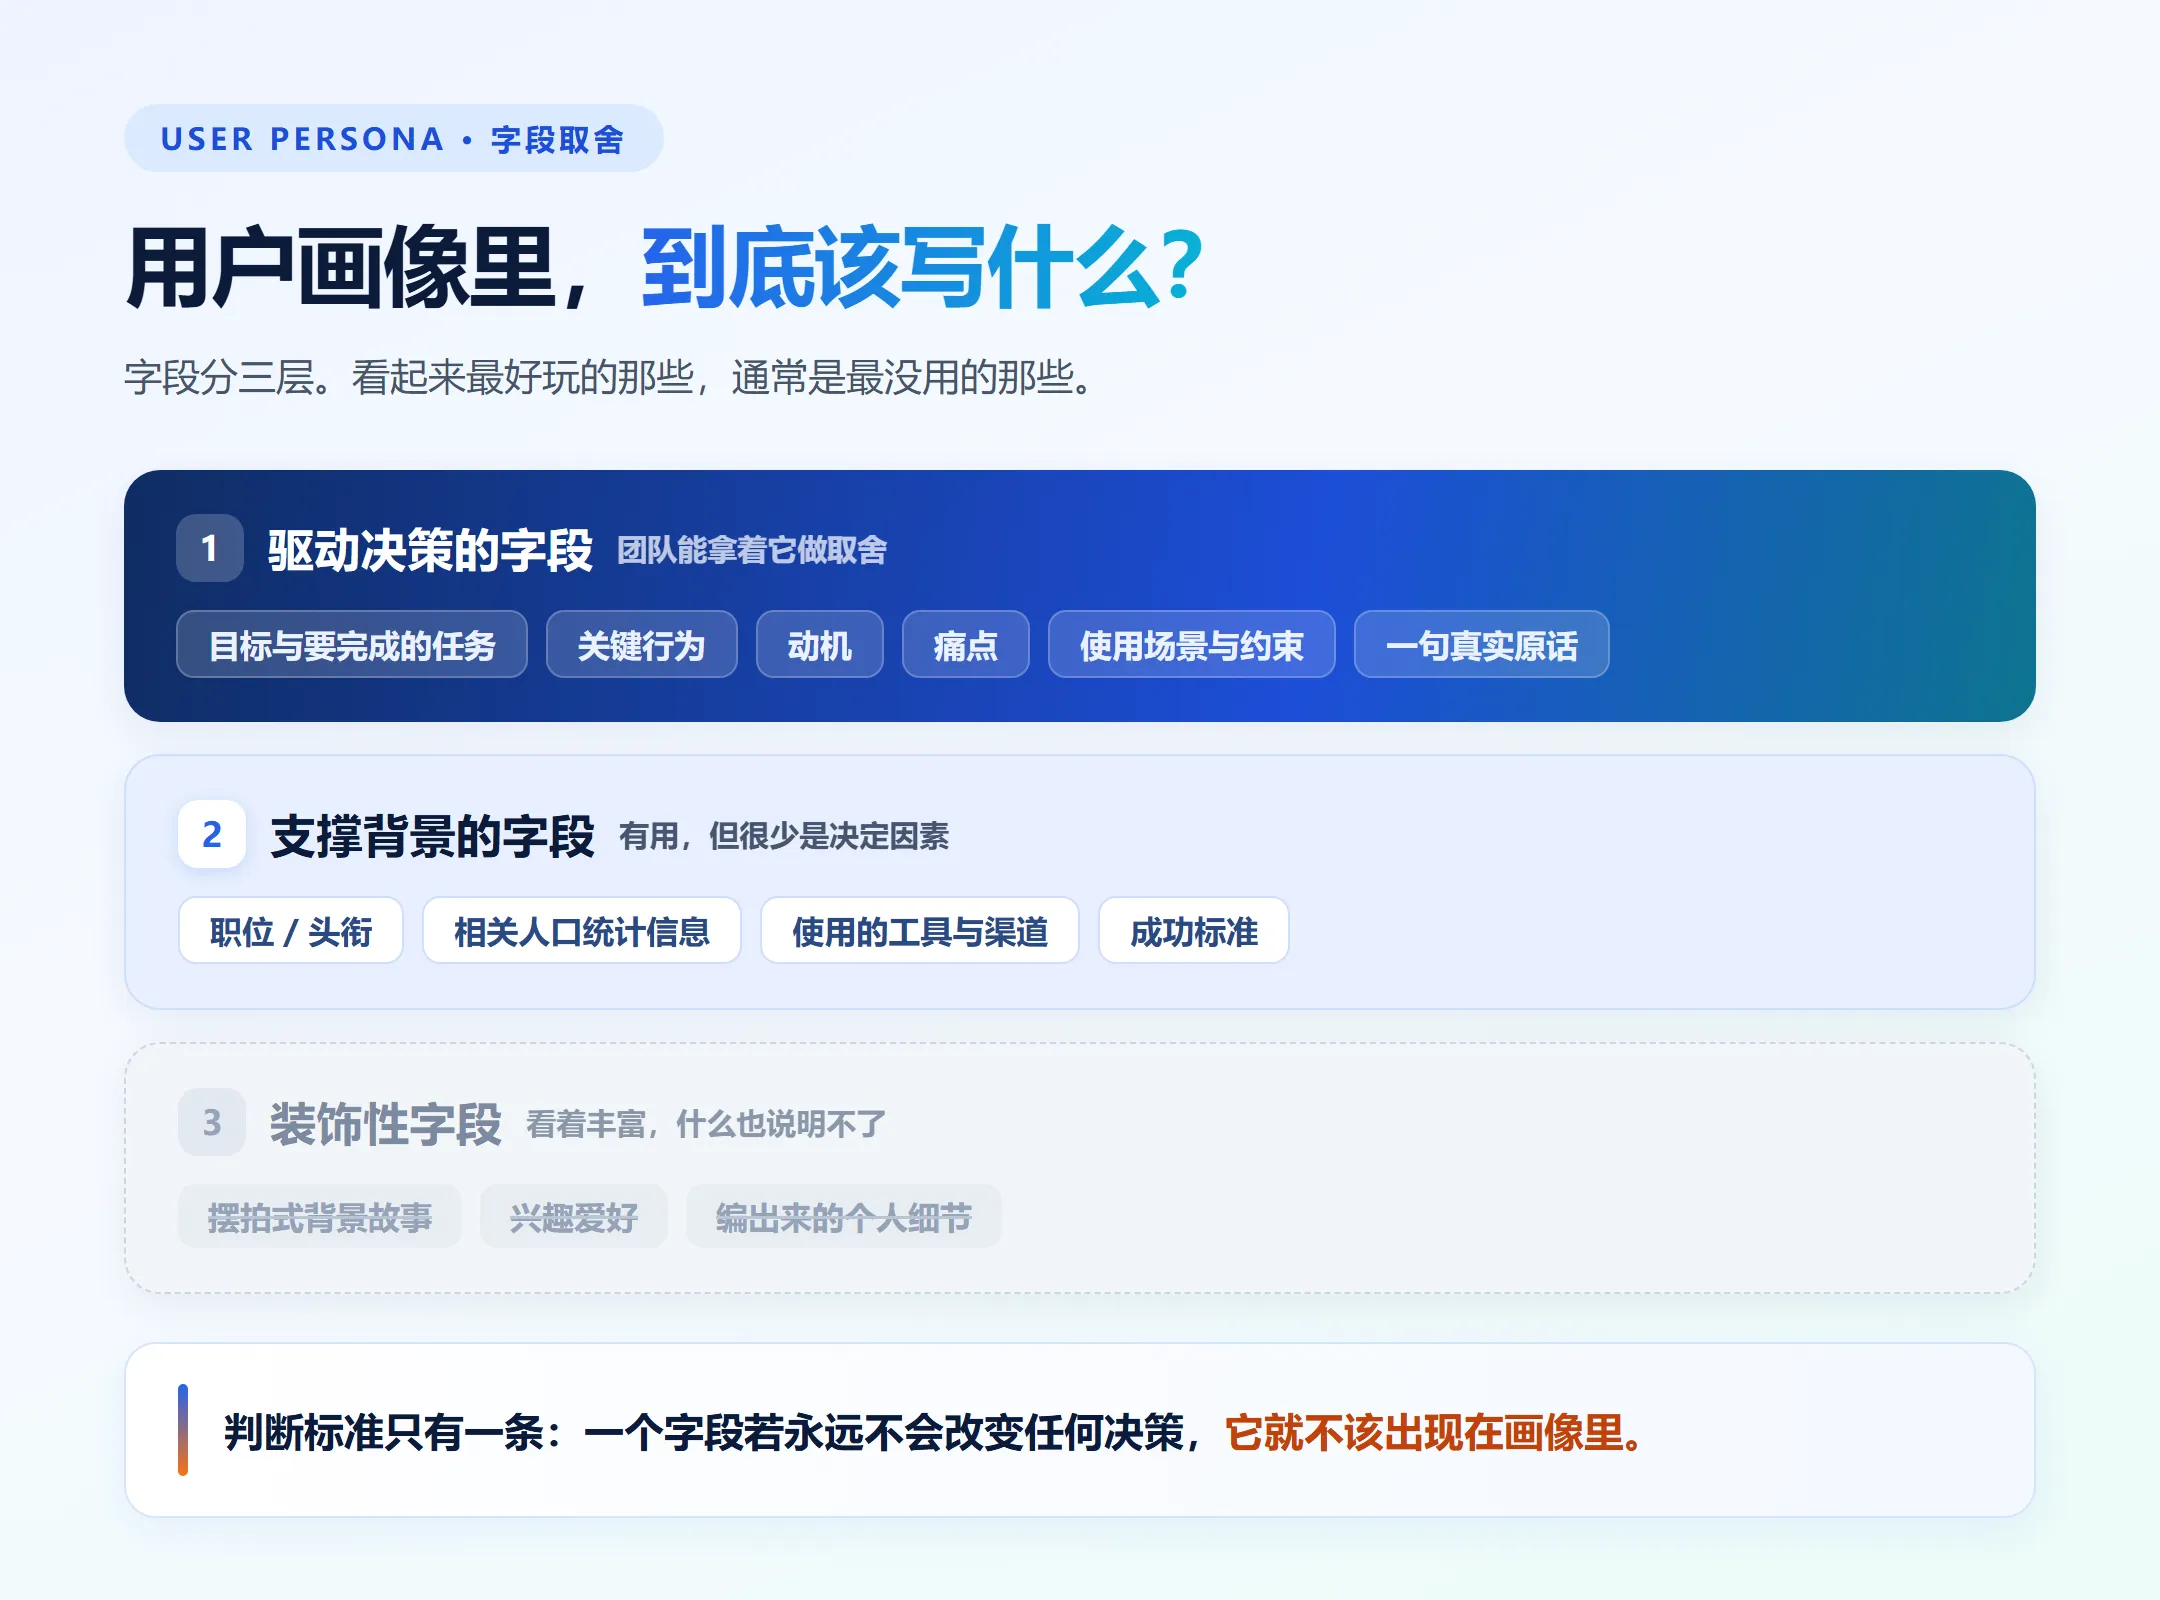 用户画像字段的三层结构
字段分三层:
- 驱动决策的:目标与要完成的任务、关键行为、动机、痛点、使用场景、一句真实原话
- 支撑背景的:职位头衔、相关人口统计信息、使用的工具与渠道、成功标准
- 装饰性的:摆拍式背景故事、兴趣爱好、编造的个人细节
判断标准:一个字段如果永远不会改变任何决策,它就不该出现——不管它让这份画像看起来多完整。
原文也承认,针对 B2B、SaaS、电商这些具体场景,现成的画像模板很多、作为起点也好用。但有一条底线:别让模板反过来决定什么才重要。字段是为决策服务的,不是反过来。
六、第 4 步:每个字段都要有出处
用你整理后的研究填满每个字段,而不是用想象力。
画像里的每一条主张,都应该能追溯到某个真实的人说过或做过的事。如果你指不出某个特征背后的证据,它就是猜的——而猜,正是画像第一次被熟悉用户的人看到时丢掉可信度的原因。
两点具体要求:
- 目标与痛点要具体,并且用用户自己的语言。 代表原话要从访谈记录里直接摘,而不是写一句「听起来很对」的话。真原话有一种编不出来的质地,也正是它能在满屋子怀疑者面前让画像站住脚。
- 一份画像只对应一个细分群体。 最大的诱惑是把两个群体平均成一个「典型用户」,但那会造出一个真实不存在、也没有任何真实客户完全共享其需求的人。别做这种混合,也别造「精确的假象」——编出来的薪资、虚构的清晨作息,看起来很细,支撑的决策数为零。
七、第 5 步:让它好记、好传播
人物层很重要,但它是在研究之上的一层,永远不能替代研究。
一个名字、一张照片、一句话简介、一句真实原话,能让画像变得可以被谈论:
「运营部的 Olivia 绝不会忍受这样的注册流程」——这是一句团队在计划会上真的能用起来的话。
”
这就是人物层的职责:让证据变得有粘性。
做法上:给一个真实感的名字和一张有代表性的图,简介控制在几句话内,能说清「这个人是谁、想干什么」就够了,再多都是废话。
然后,让它成为一个活着的东西,而不是一份开场会后就会死掉的幻灯片。存在某人网盘里的画像,已经在通往「无关」的路上了。它应该待在团队工作的地方,保持可分享,并且和它影响的那些旅程与决策连在一起。
八、第 6 步:验证,然后真的用起来
一份没被验证过的画像,仍然只是一个假设。原文给了两种验证方式:
- 拿给每天都在和这类用户打交道的同事看,观察他们是否认得这个人
当现实和画像冲突时,现实赢,你改。
然后跑决策测试(decision test):对每一份画像,说出一个它应该改变的具体决策——最近的或即将到来的都行。这一个问题,比任何排版功夫都更能让一套画像保持诚实。
一份不改变任何决策的画像,应该被合并或砍掉。如果你说不出它改变了什么,它就没在挣自己的位置。
”
最后才是真正开始有回报的地方,也是大多数指南停笔的地方——用起来:
- 把画像喂进旅程地图,是最直接的用法——一张背后没有明确画像的旅程地图,只是一条属于任何人的通用流程;是画像给了这张地图一个视角
还有保持更新:按固定节奏复盘,通常是每季度或每半年一次;并且在触发条件出现时刷新——产品大改、进入新市场,或者新研究已经对不上了。
画像一旦不再反映真实用户,它就开始安静地误导它接触到的每一个决策。
”
九、到底需要几份画像?
大多数团队3 到 5 份就够。这个数量足够容纳真正不同的需求,又少到团队能记住、真的用起来。
3–5 份主画像,对大多数团队足够了。超过五六份,人们就记不住谁是谁了,这套画像也就不再被使用。
”
长长的画像名单通常是症状,不是成就——它意味着你按「不改变决策的属性」做了分群。用原文的话说:
你不是在丢掉细节,你是在移除噪音。
”
原文还提了一个常被忽略的做法:定义一份「负向画像(negative persona)」——你故意不服务的那类用户。说清你愿意让谁失望,会让每一个「服务谁」的决策都变得更清晰,也给了团队说「不」的许可。
十、五个反复出现的错误
- 把假设包装成事实。 用内部意见拼出来、从未拿真实用户验证过。格式看起来越是正规,就越危险。
- 用人口统计打头。 年龄收入放最上面,目标和行为埋在下面——这刚好把真正驱动决策的东西颠倒了。
- 画像太多。 画像越多感觉越严谨,实际通常意味着分群更弱、整套没人记得住。
- 把画像当成一次性交付物。 做一次就再不更新,慢慢偏离现实,直到它变成「积极地错」。
- 让它落灰。 为了一场工作坊而做,汇报一次,之后再没进过任何一个真实的产品、设计或旅程决策。一份不改变你工作方式的画像,浪费了投入其中的全部研究。
十一、常见问答
原型画像(proto-persona)和研究型画像差在哪?
原型画像是还没有研究时,用团队现有认知快速画的一版草图,用来在早期让大家对齐想法。研究型画像则要拿真实用户数据(访谈、埋点等)验证过。原型画像是个合法的起点,风险在于把它误当成成品、再也不回去验证。
用户画像、买家画像、ICP、用户分群,到底是不是一回事?
不是,它们在不同的层面回答不同的问题:
- 用户画像(user persona)——描述使用产品的人,答的是「怎么为这个人设计和构建」
- 买家画像(buyer persona)——描述做购买决策的人,答的是「怎么说才能拿下这单」;在 B2B 里,这通常是另一个人
- ICP(理想客户画像)——描述的是最匹配的公司或客户账户,不是个人,靠公司规模、行业、营收这类企业特征来定
- 用户分群(segment)——是按共同属性做的统计分组
原文的说法很干脆:分群和 ICP 管的是该出现在哪里、优先攻哪些账户;买家画像管的是该说什么话成交;用户画像管的是这个人进了产品之后,该为他做什么。在 B2B 里,签合同的人可能一辈子不会打开那套软件——这正是这几个词必须分开用的原因。
画像多久更新一次?
按固定节奏复盘,通常是每季度或每半年;出现实质性变化时随时刷新:产品大改、进入新市场,或者研究结论已经和画像对不上。画像是活文档,一旦不再反映真实用户,它就开始误导依赖它的决策。
画像和旅程地图是什么关系?
画像定义了「这张旅程地图代表谁的体验」。通常每份主画像配一张自己的旅程地图,或者在共享地图里有自己的视图,这样痛点和优先级始终挂在一个具体、真实的群体上,而不是一个平均出来的「所有人」。没有画像在背后,旅程地图就是一条没有归属的通用流程——是画像给了它视角。
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !



 京公网安备 11010802034615号
经营许可证编号:京B2-20210330