在Python数据分析与数据清洗工作中,Pandas是最核心的数据处理库,DataFrame是结构化数据的标准存储格式。在实时数据采集、循环数据生成、接口数据接收、批量数据拼接等场景中,程序经常以字典(dict)格式获取单条结构化数据,需要将单个字典按行逐条插入已有DataFrame,实现数据累积与数据集更新。字典 key 对应数据表字段、value 对应字段数值,天然适配数据表行结构。因此掌握字典按行追加DataFrame的标准写法、规避报错问题、熟练高效拼接逻辑,是Python数据分析的必备基础能力。本文将系统讲解原理、实现方法、常见报错、优化方案与实战应用。
一、业务场景与技术原理
在数据分析实战中,很多动态数据都是以字典形式产生:爬虫单条结果、接口单条返回数据、循环计算生成的单条指标、用户单条行为记录等。这类数据无法一次性批量生成完整DataFrame,只能逐条生成、逐行追加。
字典与DataFrame行数据具备天然映射关系:字典的键(key)对应DataFrame列名,字典的值(value)对应该行各列的具体数据。将字典按行插入DataFrame,本质就是将键值对结构转化为数据表单行记录,并拼接到原有数据表末尾。
Pandas中实现字典按行插入,最通用、最易懂的方式是先创建空DataFrame,再通过循环逐条追加字典数据。核心方法为 append() 方法与 pd.concat() 拼接方法。
1. 基础逐行插入完整代码
import pandas as pd
df = pd.DataFrame(columns=["姓名","年龄","城市","薪资"])
row1 = {"姓名":"张三","年龄":22,"城市":"北京","薪资":8000}
row2 = {"姓名":"李四","年龄":25,"城市":"上海","薪资":12000}
row3 = {"姓名":"王五","年龄":23,"城市":"广州","薪资":9500}
df = df.append(row1, ignore_index=True)
df = df.append(row2, ignore_index=True)
df = df.append(row3, ignore_index=True)
print(df)
参数说明:ignore_index=True 代表重置行索引,避免每次追加产生重复索引,保证数据表索引连续有序,是逐行插入的必备参数。
三、新版本推荐:concat 拼接插入(高效稳定)
在新版Pandas中,append方法已被逐步弃用,官方推荐使用 pd.concat() 实现字典行追加,运行效率更高、稳定性更强,适合大批量循环插入场景。
标准高效写法
import pandas as pd
df = pd.DataFrame(columns=["姓名","年龄","城市","薪资"])
row_list = [
{"姓名":"张三","年龄":22,"城市":"北京","薪资":8000},
{"姓名":"李四","年龄":25,"城市":"上海","薪资":12000},
{"姓名":"王五","年龄":23,"城市":"广州","薪资":9500}
]
for row in row_list:
new_df = pd.DataFrame([row])
df = pd.concat([df, new_df], ignore_index=True)
print(df)
该写法兼容性强、无版本报错,是目前工业级数据处理的主流逐行插入方式。
四、字典按行插入核心优势
1. 字段自动匹配,无需手动排序
字典key会自动与DataFrame列名匹配,即使字典字段顺序错乱,数据也能精准对应列插入,不会出现数据错位、串列问题,适配动态字段场景。
2. 适配动态增量数据
适合数据逐条生成的场景,无需提前准备完整数据集,支持边计算、边采集、边插入,实现动态数据表更新。
3. 代码简洁、可读性强
字典结构直观易懂,key对应列、value对应数据,逻辑清晰,相比于列表插入,可维护性更强,适合长期迭代项目。
五、常见报错与避坑要点
1. 未设置 ignore_index 导致索引重复
逐行追加时若不重置索引,每行默认保留原字典索引,会导致索引重复、排序混乱、后续筛选报错。所有追加操作必须开启 ignore_index=True。
2. 字典字段与列名不匹配导致空值
若字典key不存在于DataFrame表头,会自动生成新列;若表头字段在字典中缺失,该行对应位置会生成空值NaN,造成数据缺失。插入前需保证字典字段与数据表列名一致。
3. 大批量循环append效率极低
append属于原地复制拼接,大批量循环会极大降低运行速度、占用内存。数据量大时,建议先收集所有字典至列表,最后一次性concat拼接,大幅提升效率。
未定义columns的空DataFrame无法匹配字典字段,会出现结构错乱,初始化DataFrame必须提前定义表头字段。
六、高效优化方案:先收集后批量插入
针对大量动态数据,最优实践为:循环收集字典 → 一次性拼接DataFrame,极大提升运行效率,是数据分析工程化标准写法。
import pandas as pd
df = pd.DataFrame(columns=["姓名","年龄","城市","薪资"])
temp_list = []
for i in range(5):
temp_dict = {"姓名":"用户"+str(i),"年龄":20+i,"城市":"深圳","薪资":8000+i*1000}
temp_list.append(temp_dict)
df = pd.concat([df, pd.DataFrame(temp_list)], ignore_index=True)
print(df)
七、实际业务应用场景
爬虫逐条获取网页数据,封装为字典,逐行插入DataFrame,最终汇总为结构化数据表,用于后续清洗、去重、导出Excel。
2. 接口数据实时更新
调用API接口单条返回结构化字典数据,通过逐行插入实现数据表实时增量更新。
3. 循环指标计算汇总
遍历多组数据、循环计算单条指标,将每次计算结果字典逐行汇总,生成最终指标统计表。
4. 用户行为日志结构化整理
解析单条日志为字典结构,逐条插入数据表,实现日志数据结构化归档与分析。
八、总结
字典按行插入DataFrame是Python数据分析中动态数据结构化处理的核心技术。字典键值对与数据表行列结构高度适配,能够精准、便捷地实现单条数据增量插入。在使用过程中,需要摒弃低效的循环append写法,采用concat拼接+临时列表缓存的工程化方案,同时规范表头匹配、索引重置、字段对齐等细节,规避空值、错位、索引混乱等问题。
熟练掌握字典逐行插入DataFrame的原理与优化方法,能够高效处理动态采集、循环计算、接口返回等各类增量数据场景,快速构建结构化数据集,为后续的数据清洗、统计分析、可视化与报表输出提供坚实的数据基础。
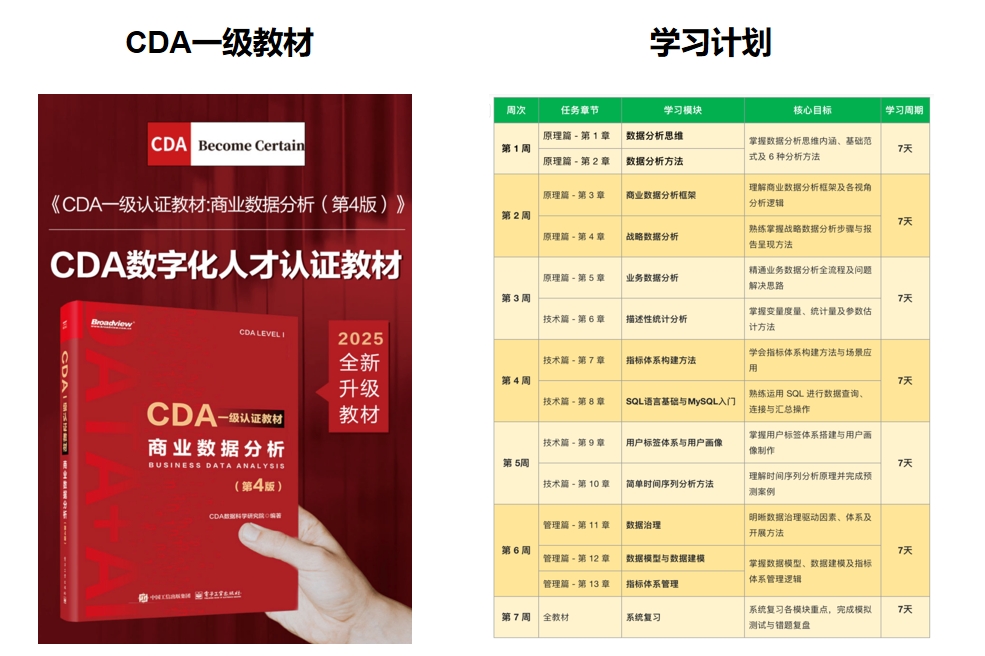
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330