在数据分析工作中,文本数据处理是高频刚需场景,用户评论、客服工单、日志信息、调研问卷、商品文案等数据都包含大量文本内容。快速统计指定关键词、特定词汇在文本列中的出现次数,是文本挖掘、舆情分析、问题复盘、用户需求提炼的基础操作。
Pandas作为Python核心数据分析库,提供了简洁高效的文本处理函数,无需复杂爬虫算法和深度学习模型,即可快速精准统计单列、多列数据中目标词汇的出现次数,适配批量数据统计、海量文本筛查、高频问题汇总等业务场景。本文将系统讲解Pandas查找统计词汇出现次数的核心原理、多种实战方法、综合业务案例及常见误区,形成标准化的文本词频统计分析流程。
一、Pandas词频统计的核心应用价值
相较于Excel手动检索、人工计数的低效方式,Pandas自动化统计词汇次数具备明显优势,适配现代批量数据分析场景,核心价值体现在三点。
第一,高效处理海量数据,面对上万、十万级别的文本明细数据,可实现秒级统计,彻底解决人工统计耗时、易错、无法批量处理的问题。
第二,统计维度灵活多样,支持精准匹配、模糊匹配、大小写适配、单关键词、多关键词批量统计,适配不同业务检索需求。
第三,可落地可复用,代码一次编写可反复调用,适配日常文本复盘、舆情监控、问题统计等常态化工作,是数据分析从业者必备的基础技能。
二、Pandas统计词汇出现次数的核心实战方法
在Pandas中,文本统计核心依托str字符串方法实现,根据业务需求分为精准统计、模糊统计、去重统计、多关键词统计四类主流方法,覆盖99%的文本词频统计场景。
(一)基础模糊统计:统计关键词总出现次数
该方法是最常用的统计方式,适用于统计文本中包含目标关键词的总次数,支持一词多匹配,即单条文本内多次出现关键词可累计计数。核心依托str.count()函数,直接遍历整列文本,累加关键词出现总频次。
核心原理:遍历DataFrame指定文本列,逐行检索目标词汇,统计所有文本中词汇的累计出现总次数。
适用场景:统计差评、投诉、卡顿、超时、破损等问题词汇的整体出现频次,判断业务高频问题。
(二)精准匹配统计:统计含关键词的文本条数
区别于累计词频,该方法不统计单文本内的重复词汇,仅统计包含该关键词的文本条目总数,依托str.contains()筛选+计数实现。
核心原理:筛选出所有包含目标关键词的文本行,对有效行数进行统计,聚焦“有多少条数据涉及该关键词”。
适用场景:统计多少条用户评论提及服务问题、多少笔工单存在异常反馈、多少条日志包含报错信息。
(三)大小写兼容统计:规避文本格式干扰
原始文本数据常存在大小写不统一问题,如“Bad”“bad”“BAD”,直接统计会导致计数遗漏。Pandas可通过忽略大小写参数,实现统一匹配统计。
核心原理:设置匹配参数忽略大小写,统一文本检索口径,保证统计数据完整、无遗漏。
适用场景:英文文本统计、用户随意输入的不规则文本数据统计。
(四)多关键词批量统计:同时检索多个词汇
实际业务中常需要同时统计多个关联词汇,如同时统计“超时”“延迟”“未送达”三类配送问题。Pandas支持正则表达式匹配,可一次性批量统计多个关键词的总频次。
核心原理:通过正则分隔多个目标词汇,批量遍历文本列,汇总所有关联关键词的出现次数。
适用场景:批量统计各类投诉问题、故障类型、用户负面反馈词汇。
(五)分组词频统计:分维度统计词汇次数
结合Pandas分组功能,可实现按区域、时间、渠道、品类分组统计关键词出现次数,实现多维度词频分析。
核心原理:先对数据维度分组,再在各组内执行关键词统计,实现差异化对比分析。
适用场景:分区域统计差评次数、分月份统计故障反馈次数、分品类统计用户投诉频次。
三、业务综合实战案例
以门店配送工单文本数据为例,数据集包含配送备注、区域、配送时间等字段,通过Pandas统计负面问题词汇频次,复盘配送核心问题。
1. 整体词频统计:统计全量工单中“超时”“破损”“漏送”三个问题词汇的总出现次数,掌握整体问题体量;
2. 条目数量统计:统计涉及配送问题的工单总条数,计算问题工单占比;
3.分组维度统计:按区域分组,统计各区域问题词汇出现频次,定位问题高发区域;
4. 数据结论输出:结合词频数据,判断核心配送痛点、薄弱区域,为运营优化提供数据支撑。
该流程完整实现了从文本数据提取、词频统计、维度拆解到业务落地的闭环,是企业文本数据分析的标准流程。
四、Pandas词频统计常见误区与避坑要点
1. 混淆总词频与条目数
str.count()统计的是词汇累计出现总次数,单条文本多次出现会重复计数;str.contains()统计的是含关键词的文本条数,二者业务意义完全不同,需根据需求合理选择。统计问题严重程度用总词频,统计问题覆盖面用条目数。
2. 未处理空值导致统计偏差
文本列存在空值、缺失数据时,直接统计会出现报错或数值偏差,统计前需通过fillna()填充空值,保证数据口径统一。
3. 未适配大小写与特殊符号
用户输入文本格式杂乱,存在大小写、空格、特殊符号,未做适配会导致部分词汇漏统计,需开启忽略大小写、去除无效符号,保证统计精准度。
4. 多关键词统计逻辑混乱
批量统计多词汇时,未使用正则表达式分隔关键词,导致匹配失效,需规范正则匹配格式,保证多词汇精准检索。
五、全文总结
利用Pandas查找统计关键词出现次数,是文本挖掘与非结构化数据分析的基础核心能力。依托count总词频统计、contains条目统计、多关键词批量检索、分组维度统计等方法,可高效解决各类文本频次分析问题。
相较于传统人工统计、Excel检索,Pandas词频统计具备高效、精准、可批量、可多维拆解的优势,能够快速从海量评论、工单、日志文本中挖掘高频问题、用户偏好、业务痛点。在实际数据分析工作中,只需区分统计业务场景,规避词频与条目混淆、空值干扰、格式不统一等误区,即可实现标准化文本词频分析,为业务复盘、问题优化、决策落地提供可靠的文本数据支撑。
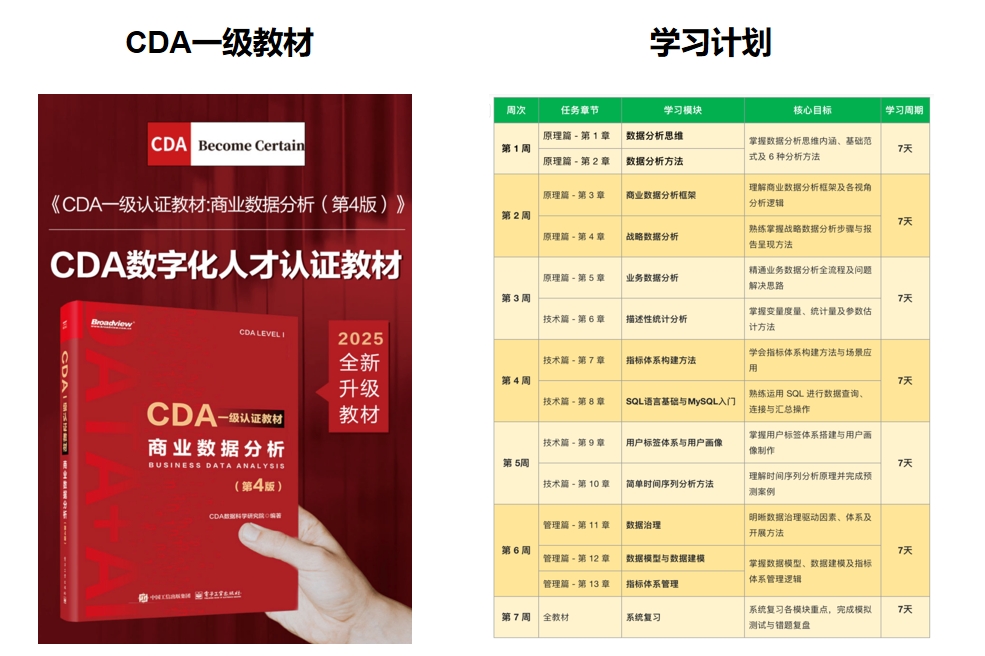
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330