关联分析是数据挖掘领域中挖掘数据间潜在关联关系的经典方法,广泛应用于零售购物篮分析、电商推荐、用户行为路径挖掘等场景。而支持度(Support)作为关联分析中最基础、最核心的指标,是判断项集间关联是否具有普遍意义的关键依据——它直接反映了特定项集在整体数据中的出现频率,决定了关联规则的“普遍性”与“代表性”。脱离支持度的关联分析,易陷入“挖掘无效小众规则”的误区,无法为业务决策提供有价值的参考。本文将从支持度的本质定义出发,拆解其计算逻辑、应用场景与实操要点,完整呈现支持度在关联分析中的核心价值。
一、核心认知:支持度的定义与本质
在关联分析中,“项集”是基础概念,指由一个或多个元素(如商品、用户行为、事件)组成的集合,分为单项集(如{牛奶})、二元项集(如{牛奶,面包})、多元项集(如{牛奶,面包,鸡蛋})。支持度则是衡量某一项集或关联规则在整体数据中出现概率的指标,核心本质是“项集的普遍存在性”。
1. 支持度的严格定义
对于项集X,其支持度Support(X)表示项集X在所有事务中同时出现的概率,计算公式为:
Support(X) = 包含项集X的事务数 / 总事务数
对于关联规则X→Y(表示“出现项集X时,同时出现项集Y”),其支持度Support(X→Y)本质是项集X与Y的联合支持度,即项集{X,Y}同时出现的概率,计算公式为:
Support(X→Y) = Support({X,Y}) = 包含项集{X,Y}的事务数 / 总事务数
2. 支持度的核心意义
支持度的核心价值在于筛选“具有统计意义的关联关系”,避免将偶然出现的小众关联误判为普遍规律。例如,在零售场景中,若{啤酒,尿布}的支持度仅为0.1%,说明这两项商品同时被购买的概率极低,即便两者存在强因果关联,也不具备大规模推广的价值;若支持度达15%,则说明该关联具有普遍性,可作为货架摆放、组合促销的重要依据。
简言之,支持度是关联规则的“入门门槛”——只有支持度达到设定阈值(Minimum Support,最小支持度)的项集或规则,才值得进一步分析其关联性强度。
二、支持度的计算方法与实操步骤
支持度的计算需基于结构化的事务数据,核心步骤为“数据准备→项集识别→频次统计→代入计算”,实操中需注意数据格式规范与统计范围界定,避免计算偏差。
1. 数据准备要求
关联分析的事务数据需满足“一行一事务,一列一项”的格式,每个事务对应一组独立的行为集合(如一次购物、一组用户操作)。例如,零售购物篮数据格式如下:
| 事务ID |
购买商品(项集) |
| 1 |
牛奶、面包、鸡蛋 |
| 2 |
牛奶、尿布、啤酒 |
| 3 |
面包、鸡蛋、火腿 |
| 4 |
牛奶、面包、尿布、啤酒 |
| 5 |
面包、尿布、啤酒 |
注:事务数据需剔除重复项、异常项(如误录入的无效商品),确保每个事务中的项集唯一且有效。
2. 分步计算示例
基于上述5条购物篮事务数据,以二元项集{牛奶,面包}和关联规则{牛奶}→{面包}为例,演示支持度计算过程:
统计包含项集{牛奶,面包}的事务数:事务1、事务4均同时包含牛奶和面包,共2条;
计算项集{牛奶,面包}的支持度:Support({牛奶,面包}) = 2/5 = 40%;
计算关联规则{牛奶}→{面包}的支持度:该规则的支持度等价于联合项集的支持度,即Support({牛奶}→{面包}) = 40%。
同理,可计算单项集支持度:如Support({牛奶}) = 3/5 = 60%(事务1、2、4包含牛奶),Support({面包}) = 4/5 = 80%(事务1、3、4、5包含面包)。
3. 关键注意事项
统计范围界定:需明确事务的时间、空间范围(如“近3个月的线下门店订单”“某电商平台的移动端订单”),避免跨范围统计导致支持度失真;
项集去重:每个事务中的项集需唯一(如同一订单中多次购买牛奶,仅计为1次),否则会高估支持度;
阈值设定逻辑:最小支持度(Minimum Support)需结合业务场景设定,过高易遗漏潜在有价值规则,过低会生成大量无效规则(如零售场景常用阈值为1%-5%)。
三、支持度的典型应用场景
支持度作为关联分析的基础指标,广泛应用于各类数据挖掘场景,核心价值是筛选普遍存在的关联关系,为业务决策提供依据。以下是三大高频场景的实操案例:
场景1:零售购物篮分析——优化商品组合与货架布局
零售行业是关联分析与支持度应用的核心场景,通过计算商品项集的支持度,可挖掘消费者的购买习惯,优化商品组合与货架摆放策略。
案例:某超市通过分析近3个月的购物篮数据,计算得出以下支持度:
Support({方便面,火腿肠}) = 6.2%;
基于此,超市采取针对性策略:将牙刷与牙膏摆放在相邻货架(高支持度项集,提升连带购买率);将方便面与火腿肠组合推出促销套餐(中等支持度,刺激消费);红酒与牛排作为高端组合,在节日期间重点陈列(小众高价值项集)。实施后,连带购买率提升12%,高端商品销售额增长18%。
场景2:电商推荐系统——构建个性化关联推荐
在电商平台中,支持度可用于筛选用户普遍青睐的商品组合,为个性化推荐提供依据,避免推荐小众冷门的关联商品。
案例:某电商平台通过分析用户订单数据,发现Support({智能手机,手机壳}) = 15.3%,Support({智能手机,无线耳机}) = 9.7%,且这两项支持度在年轻用户群体中高达22%。基于此,平台为购买智能手机的用户,优先推荐手机壳与无线耳机(高支持度项集),同时补充推荐手机膜、充电器等关联商品。优化后,推荐转化率从3.2%提升至7.8%。
场景3:用户行为分析——挖掘高频行为关联
在APP、网站运营中,支持度可用于挖掘用户行为项集的关联关系,优化产品功能布局与用户引导流程。
案例:某内容APP通过分析用户行为数据,计算得出:Support({浏览美食文章,点击美食视频}) = 12.5%,Support({收藏文章,关注作者}) = 8.9%。基于此,APP在美食文章底部增设“相关美食视频”入口,在收藏按钮旁添加“关注作者”引导,提升用户行为连贯性。优化后,用户日均使用时长增加20分钟,作者关注率提升9%。
四、支持度与其他关联指标的协同应用
单独使用支持度无法全面判断关联关系的有效性——支持度仅衡量“普遍性”,无法反映“关联性强度”与“因果性”。实际关联分析中,需结合置信度(Confidence)、提升度(Lift)与支持度协同筛选,确保规则的实用性。
1. 三大核心指标的协同逻辑
| 指标 |
核心作用 |
与支持度的协同关系 |
| 支持度(Support) |
衡量关联规则的普遍性,筛选高频关联 |
基础门槛,先筛选出支持度达标(≥最小支持度)的规则,再进一步分析 |
| 置信度(Confidence) |
衡量规则的可靠性(出现X时出现Y的概率) |
过滤“高支持度但低可靠性”的规则(如Support({雨具,雨伞})高,但置信度低,无意义) |
| 提升度(Lift) |
衡量规则的因果性(X对Y的促进作用) |
排除“伪关联”(如高支持度、高置信度但提升度≤1,说明X与Y无因果关系,仅为偶然共现) |
2. 有效关联规则的筛选标准
需同时满足以下三个条件,才能判定为有效关联规则:
Support(X→Y) ≥ 最小支持度(确保普遍性);
Confidence(X→Y) ≥ 最小置信度(确保可靠性,常用阈值为50%-80%);
Lift(X→Y) > 1(确保X对Y有正向促进作用,Lift越大,因果性越强)。
示例:关联规则{牛奶}→{面包},若Support=40%(≥5%)、Confidence=66.7%(≥50%)、Lift=1.2(>1),则为有效规则;若Lift=0.9(≤1),说明牛奶与面包的共现仅为偶然,无实际关联价值。
五、支持度应用的常见误区与避坑要点
实操中,易因对支持度的理解偏差、参数设定不当,导致关联分析结果失效。以下是高频误区及规避方法:
1. 误区1:过度追求高支持度,遗漏潜在价值规则
错误做法:将最小支持度设定过高,仅保留高频项集,遗漏小众但高价值的关联规则(如高端商品组合、特定用户群体的行为关联)。
规避方法:结合业务目标分层设定支持度阈值,如对大众商品设定1%-5%的阈值,对高端小众商品设定0.1%-0.5%的阈值;同时按用户分层、商品分类分别计算支持度,挖掘细分场景的价值规则。
2. 误区2:单独依赖支持度,误判关联有效性
错误做法:仅以支持度为标准筛选规则,将高支持度但低置信度、低提升度的“伪关联”作为决策依据。例如,{矿泉水,纸巾}支持度高,但两者无明显因果关系,仅因均为高频日用品。
规避方法:必须结合置信度、提升度协同筛选,三者同时达标才能判定为有效规则;同时结合业务逻辑验证,避免将偶然共现误判为因果关联。
3. 误区3:数据范围不当,导致支持度失真
错误做法:未界定清晰的事务范围,如将不同季节、不同区域的事务混合统计,导致支持度偏离实际业务场景。例如,冬季{羽绒服,暖手宝}的支持度高,若混合夏季数据,会低估其真实关联强度。
规避方法:按业务场景细分数据(如按季节、区域、用户群体拆分),分别计算支持度;定期复盘数据范围,结合业务变化调整统计维度。
4. 误区4:忽视项集规模对支持度的影响
错误做法:过度分析多元项集(如四元、五元项集),这类项集的支持度通常极低,且业务意义有限,反而增加分析成本。
规避方法:优先分析二元、三元项集,这类项集支持度相对合理,且业务解释性强;多元项集仅在特定场景(如复杂套餐组合)下针对性分析。
六、总结:支持度——关联分析的“普遍性标尺”
支持度作为关联分析的基础指标,其核心价值在于为关联规则设立“普遍性门槛”,筛选出具有统计意义的关联关系,避免分析陷入小众偶然的误区。无论是零售购物篮分析、电商推荐,还是用户行为挖掘,支持度都是后续深入分析的前提,但其并非唯一标准,需与置信度、提升度协同,结合业务逻辑验证,才能挖掘出真正有价值的关联规则。
掌握支持度的计算方法与应用逻辑,关键在于“精准界定数据范围、合理设定阈值、多维协同验证”。唯有如此,才能让关联分析落地为可执行的业务策略,真正发挥数据挖掘的价值,助力业务决策优化与效益提升。
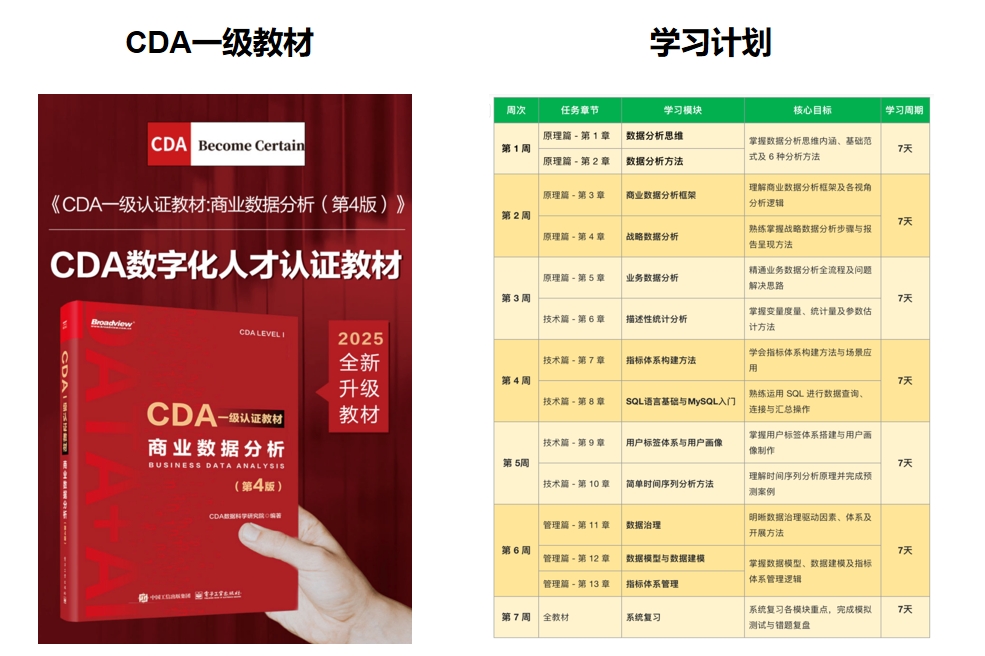
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330