在Python数据清洗、文本校验、账号密码规则校验、脏数据过滤、字符串规整化处理中,正则表达式是最高效、最常用的文本匹配工具。日常数据处理中,经常需要判断字符串是否仅包含字母与数字、剔除特殊符号、过滤非法字符、提取纯文本或纯数字。其中字母数字精准匹配与**正则取反(反向匹配)**是数据清洗的核心操作。本文将系统讲解Python正则字母、数字匹配规则、取反原理、常用语法、代码实例与落地应用,帮助实现规范化文本处理。
一、正则表达式基础元字符(字母数字核心语法)
在Python正则re模块中,针对字母与数字的匹配有固定通用元字符,是实现文本筛选的基础语法。
d:匹配任意 0-9 数字;D:匹配任意非数字(取反);
w:匹配字母、数字、下划线;W:匹配非字母、非数字、非下划线(取反);
[a-zA-Z]:仅匹配大小写英文字母;[0-9]:仅匹配数字;
^ 代表字符串开头,$ 代表字符串结尾,用于整体严格匹配。
正则中大写元字符本质就是小写的取反操作,这是Python正则反向匹配最便捷的核心逻辑。
二、纯字母+数字组合匹配(正向匹配)
正向匹配常用于账号校验、用户名校验、订单号筛选,判断字符串是否仅由字母和数字组成,不含特殊符号、空格、中文。
匹配“仅包含大小写字母+数字”:^[a-zA-Z0-9]+$
2. Python实战代码
import re
def check_letter_num(s):
res = re.match(r"^[a-zA-Z0-9]+$", s)
return res is not None
print(check_letter_num("abc123"))
print(check_letter_num("abc123!"))
print(check_letter_num("123456"))
print(check_letter_num("abc"))
该正向匹配可用于注册账号合法性校验、设备ID校验、订单号清洗等场景,过滤含有非法字符的文本。
三、正则取反操作核心原理
正则取反(反向匹配),指不匹配某类字符、匹配所有不符合规则的内容,是数据清洗剔除脏字符的关键。Python正则有两种主流取反方式:元字符大写取反、中括号^取反。
1. 元字符自带取反(最简单)
d(数字) ↔ D(非数字);w(字母数字下划线) ↔ W(非字母数字下划线)
2. 中括号内^取反(自定义取反)
[^a-zA-Z0-9]:代表匹配所有不是字母、不是数字的字符,是数据清洗最常用的自定义取反规则。
四、字母数字取反实战:过滤特殊字符
业务场景:用户昵称、备注、导入文本杂乱,存在大量特殊符号、空格、乱码,需要只保留字母和数字,剔除所有其他字符。
1. 取反匹配规则
[^a-zA-Z0-9] 匹配所有非字母、非数字字符,统一替换为空,实现文本净化。
2. 完整代码示例
import re
def clean_letter_num(s):
new_str = re.sub(r"[^a-zA-Z0-9]", "", s)
return new_str
text1 = "user123!!@@"
text2 = "abc456##789测试中文"
print(clean_letter_num(text1))
print(clean_letter_num(text2))
该方法广泛用于Excel脏数据清洗、用户数据规整、设备号脱敏、字段统一格式化。
五、常用进阶取反场景汇总
1. 只保留数字(取反非数字)
def get_only_num(s):
return re.sub(r"D", "", s)
print(get_only_num("订单12345号"))
2. 只保留字母(取反非字母)
def get_only_letter(s):
return re.sub(r"[^a-zA-Z]", "", s)
print(get_only_letter("abc123xyz"))
3. 剔除所有字母(只留数字符号)
def del_letter(s):
return re.sub(r"[a-zA-Z]", "", s)
print(del_letter("abc123xyz456"))
六、正向匹配与取反操作的业务区别
正向匹配:用于校验、判断、筛选符合规则的数据,例如判断账号是否合法、筛选标准订单号。
取反匹配:用于清洗、剔除、规整数据,过滤特殊符号、中文、乱码、空格,实现脏数据净化。
二者配合可以完成绝大多数文本处理场景:先取反清洗脏数据,再正向校验数据合法性。
七、正则字母数字匹配常见误区
1. 缺失首尾边界符导致匹配错误
不写 ^ $ 会造成“部分匹配”,例如 [a-zA-Z0-9]+ 可以匹配 “123!!!” 中的123,导致校验失效,严格校验必须加首尾限制。
2. 混淆 w 与纯字母数字
w 包含下划线,若业务不允许下划线,必须使用 [a-zA-Z0-9],不可直接使用w。
3. 取反符号写错位置
^ 只有写在中括号内才是取反,写在外面代表开头,位置错误会导致正则完全失效。
八、总结
在Python文本数据处理中,字母数字匹配与正则取反是数据清洗的基础核心能力。正向匹配 ^[a-zA-Z0-9]+$ 适用于合法性校验,能够精准判断字符串是否为纯字母数字组合;取反操作 [^a-zA-Z0-9] 与大写元字符 D、W 可以快速剔除特殊字符、中文与脏数据,实现文本标准化规整。
熟练掌握正向匹配与反向取反的组合用法,可以高效完成账号校验、字段清洗、文本过滤、数据规整等工作,是数据分析、数据预处理、自动化脚本开发的必备基础技能。
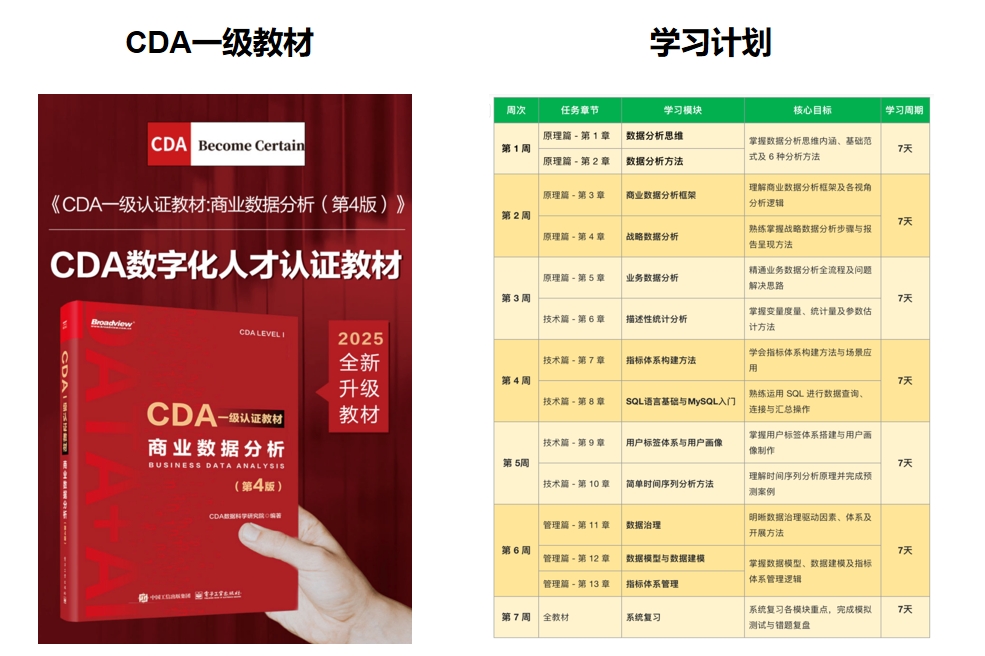
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330