在数据仓库 建设与商业智能 分析体系中,维度建模是应用最广泛的建模方法论,而事实表 维度表 表结构 设计,数据仓库 的表结构 围绕 “分析决策” 设计,核心目标是支撑多维度、多角度的业务数据统计 与洞察。很多初学者在入门数仓建模时,往往混淆两类表的定位、边界与设计逻辑,导致模型冗余、查询低效、统计口径混乱。本文将系统拆解维度表 与事实表 的核心定义、本质差异,结合电商订单经典场景给出完整可落地的建模案例,总结设计原则与常见误区,为数据仓库 入门与实战提供标准化参考。
一、核心概念:两类表的本质定位 维度建模的核心思想是 “以业务过程为核心,用度量 + 描述的方式拆解业务数据”,由此衍生出事实表 与维度表 两类完全不同的表结构 ,二者各司其职、相辅相成。
(一)事实表 :业务过程的量化度量核心 事实表 (Fact Table)是数据仓库 的核心表,用于存储业务过程事件的量化度量数据 ,每一行对应一个独立的业务事件。事实表 中存储的都是可聚合、可计算的数值型指标,也就是 “事实”,例如订单金额、销售数量、库存余量、访问时长、点击次数等。
事实表 的核心特征 是:数据量大、增长速度快、以业务事件为粒度、以关联维度的外键为核心结构。它本身不具备描述性信息,只存数值和维度 ID,所有的分类、筛选、标签属性都依托维度表 提供。
(二)维度表 :分析视角的上下文描述 维度表 (Dimension Table)是事实表 的附属描述表,用于存储业务事件的上下文属性信息 ,也就是我们观察数据的 “分析维度”。维度表 中存储的都是描述性、分类性、标签性字段 ,例如日期、地区、用户属性、商品分类、渠道来源等。
维度表 的核心特征 是:数据量小、更新频率低、属性字段 多、以单一主键为唯一标识。它是数据分析的 “视角入口”,所有的筛选、分组、标签拆解都依赖维度表 实现,是实现多维度下钻、切片分析的基础。
两类表从定位、内容、结构到更新逻辑都存在本质区别,核心差异可通过下表直观对比:
对比维度
事实表 维度表
核心定位
存储业务度量值,是分析的计算对象
存储描述属性,是分析的筛选分组依据
数据内容
数值型指标(金额、数量、时长、次数等)
文本 / 分类属性(名称、分类、等级、日期等)
主键特征
一般为事件 ID,搭配多个维度外键
单一主键(维度 ID),唯一标识一条维度记录
数据量级
数据量大,随业务事件持续增长,是数仓的主体数据
数据量小,相对稳定,记录数远少于事实表
更新方式
增量插入为主,极少修改历史数据
缓慢更新为主,可新增、修改维度属性
典型场景
订单事实表 、流量事实表 、库存事实表
日期维度、用户维度、商品维度、地区维度
简单来说:事实表 回答 “算什么”,维度表 回答 “按什么算”事实表 的度量,月份和品类是维度表 的属性。
三、经典实战案例:电商订单场景完整建模示例 我们以最通用的电商订单交易分析场景为例,完整展示事实表 与维度表 的设计逻辑、字段 结构与关联方式,最终构成标准的星型维度模型。
(一)业务背景与建模目标 业务场景:电商平台交易数据分析,需要支持按日期、用户、商品、地区四个维度,统计订单金额、订单量、商品数量、客单价等核心指标,支撑日常运营复盘与销售分析 。
建模原则:以单条订单明细为事实粒度,搭建 1 张事实表 + 4 张维度表 的星型模型。
表名:fact_order,粒度为 “单条订单商品明细”,每一行对应订单中的一个商品条目,所有外键关联对应维度表 的主键。
CREATE TABLE fact_order (BIGINT PRIMARY KEY COMMENT '订单明细ID(事实表 主键)' ,BIGINT NOT NULL COMMENT '订单ID' ,INT NOT NULL COMMENT '日期维度外键' ,BIGINT NOT NULL COMMENT '用户维度外键' ,BIGINT NOT NULL COMMENT '商品维度外键' ,INT NOT NULL COMMENT '地区维度外键' ,DECIMAL (10 ,2 ) NOT NULL COMMENT '商品订单金额(事实度量)' ,INT NOT NULL COMMENT '商品数量(事实度量)' ,DECIMAL (10 ,2 ) NOT NULL COMMENT '实付金额(事实度量)' COMMENT '订单交易事实表 ' ;该表仅保留数值度量与维度关联 ID,无任何描述性文本字段 ,保证事实表 的精简与高效。
表名:dim_date,是所有时间序列分析 的核心维度,支持按年、季度、月、周、节假日等多粒度时间统计。
CREATE TABLE dim_date (INT PRIMARY KEY COMMENT '日期ID(格式:20240615)' ,DATE NOT NULL COMMENT '完整日期' ,year INT NOT NULL COMMENT '年份' ,quarter TINYINT NOT NULL COMMENT '季度' ,month TINYINT NOT NULL COMMENT '月份' ,week TINYINT NOT NULL COMMENT '周数' ,weekday TINYINT NOT NULL COMMENT '星期几' ,TINYINT NOT NULL COMMENT '是否节假日:0否1是' COMMENT '日期维度表 ' ;表名:dim_user,存储用户的属性标签,支持按用户特征 分层分析。
CREATE TABLE dim_user (BIGINT PRIMARY KEY COMMENT '用户ID' ,VARCHAR (64 ) NOT NULL COMMENT '用户昵称' ,TINYINT COMMENT '性别:0男1女' ,TINYINT COMMENT '年龄' ,DATE NOT NULL COMMENT '注册日期' ,VARCHAR (16 ) NOT NULL COMMENT '用户等级:普通/白银/黄金/钻石' ,VARCHAR (32 ) NOT NULL COMMENT '所在城市' COMMENT '用户维度表 ' ;表名:dim_product,存储商品的分类、品牌等属性,支持按品类、品牌维度分析 。
CREATE TABLE dim_product (BIGINT PRIMARY KEY COMMENT '商品ID' ,VARCHAR (128 ) NOT NULL COMMENT '商品名称' ,category VARCHAR (32 ) NOT NULL COMMENT '商品品类' ,VARCHAR (32 ) NOT NULL COMMENT '商品品牌' ,DECIMAL (10 ,2 ) NOT NULL COMMENT '商品售价' ,DATE NOT NULL COMMENT '上架日期' COMMENT '商品维度表 ' ;表名:dim_area,存储行政区划信息,支持按地域层级下钻分析。
CREATE TABLE dim_area (INT PRIMARY KEY COMMENT '地区ID' ,VARCHAR (32 ) NOT NULL COMMENT '省份' ,VARCHAR (32 ) NOT NULL COMMENT '城市' ,VARCHAR (32 ) NOT NULL COMMENT '区县' ,VARCHAR (16 ) NOT NULL COMMENT '所属大区:华北/华东/华南等' COMMENT '地区维度表 ' ;(四)模型关联与查询示例 所有维度表 通过主键与事实表 的外键关联,形成以事实表 为中心、维度表 环绕的星型模型 。实际分析时,通过 JOIN 关联维度表 ,即可实现多维度统计。
示例:统计 2024 年上半年,各大区每个月的家电品类销售额。
SELECT SUM (f.order_amount) AS total_salesFROM fact_order fJOIN dim_date d ON f.date_id = d.date_idAND d.year = 2024 AND d.month BETWEEN 1 AND 6 JOIN dim_product p ON f.product_id = p.product_idAND p.category = '家电' JOIN dim_area a ON f.area_id = a.area_idGROUP BY d.month, a.regionORDER BY d.month, total_sales DESC ;四、维度建模的核心原则与常见误区 (一)核心设计原则
粒度优先原则 。设计事实表 首先确定粒度(如单条订单、单日汇总),粒度越细,分析灵活性越高,数据量也越大。
维度一致性原则 。同一维度在不同事实表 中共享使用,保证统计口径统一,例如日期维度同时适配订单、流量、库存多张事实表 。
缓慢变化维适配 。维度属性发生变化时,采用新增版本、覆盖更新等方式处理,保留历史分析的准确性。
(二)常见建模误区
维度属性塞入事实表 。为了少写 JOIN 直接把商品名称、用户等级等属性放入事实表 ,会导致数据冗余、更新困难、口径不一致。
事实表 粒度过粗事实表 ,看似节省空间,实则丧失了下钻分析的能力,无法支撑精细化分析。
维度表 过度拆分
五、总结 事实表 与维度表 是数据仓库 维度建模的基石,二者的分工与协作构成了数据分析的底层逻辑:事实表 承载业务的量化价值,维度表 提供分析的多元视角事实表 是数据仓库 的骨架,决定了分析的粒度与度量范围;维度表 是数据仓库 的血肉,赋予了数据多维度解读的能力。
在实际建模中,遵循 “事实精简、维度丰富、粒度合理、口径统一” 的原则,结合业务场景设计适配的星型模型,既能保障查询效率,又能支撑灵活的多维度分析 ,为业务决策提供坚实的数据支撑。
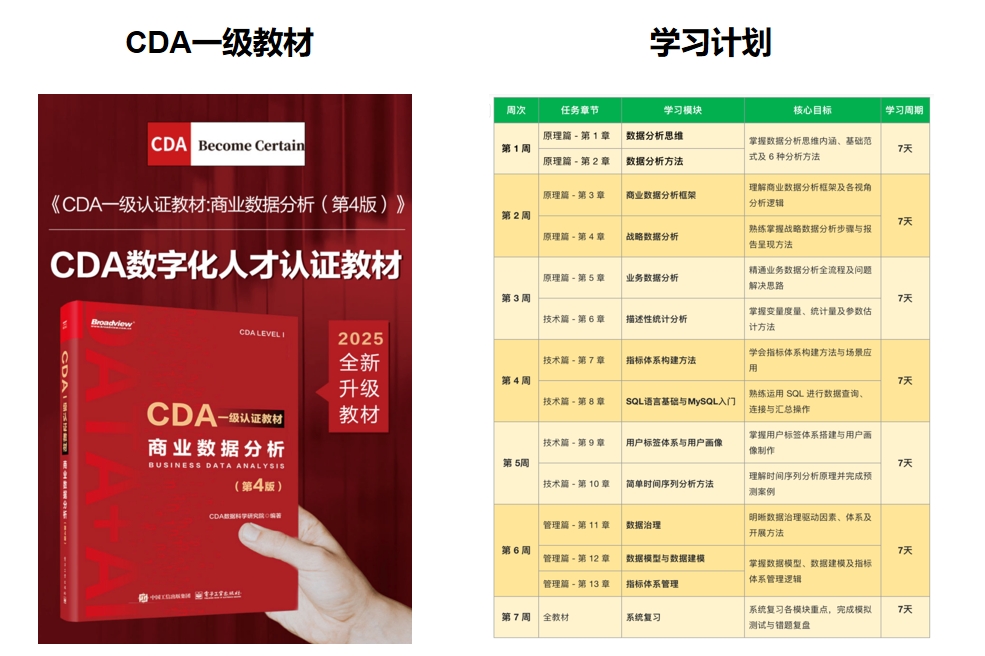
推荐学习书籍 《CDA一级教材 》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ ! 


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330