随机森林中特征重要性(Feature Importance)排名解析
在机器学习领域,随机森林因其出色的预测性能和对高维数据的适应性,被广泛应用于分类、回归等任务。而特征重要性(Feature Importance)排名作为随机森林的核心输出之一,不仅能揭示各特征对模型预测的贡献程度,还为特征选择、模型解释和业务决策提供了关键依据。本文将系统解析随机森林中特征重要性的计算原理、排名逻辑及实际应用价值。
特征重要性的核心概念与意义
特征重要性是衡量输入特征对随机森林模型预测结果影响程度的量化指标。在随机森林中,每个特征都会被赋予一个重要性得分,得分越高表明该特征在模型决策过程中发挥的作用越大。
这一指标的核心意义在于:
模型可解释性:打破 “黑箱” 模型的局限性,让开发者和决策者理解 “模型为何做出这样的预测”。例如,在信贷违约预测模型中,特征重要性排名可明确 “收入水平”“信用历史” 等因素对违约风险的影响权重。
特征筛选:从海量特征中筛选出关键变量,简化模型结构,减少计算成本,同时避免过拟合。
业务洞察:结合领域知识解读特征重要性,挖掘数据背后的业务规律。例如,在电商用户流失预测中,若 “最近 30 天登录次数” 排名靠前,可能提示需优化用户活跃度策略。
随机森林的特征重要性得分通过集成所有决策树的特征贡献度计算得出,主流方法有两种:基于不纯度的重要性和基于排列(Permutation)的重要性。
1. 基于不纯度的重要性(Gini Importance / 熵重要性)
这是随机森林默认的计算方式,其核心逻辑是:特征在决策树分裂过程中降低不纯度的能力越强,重要性得分越高。
不纯度衡量指标:对于分类问题,常用 Gini 指数(Gini impurity)或熵(Entropy);对于回归问题,常用方差(Variance)。以 Gini 指数为例,它衡量了节点中类别分布的混乱程度,值越小表示节点纯度越高(如全部为同一类别时 Gini 值为 0)。
对于单棵决策树,每当一个特征被用于分裂节点时,计算分裂前后的不纯度差值(即不纯度减少量)。
用该节点包含的样本比例加权不纯度减少量,得到该特征在当前树中的局部重要性。
对森林中所有决策树的局部重要性取平均值,即为该特征的最终重要性得分。
例如,若 “年龄” 特征在 100 棵树中多次被用于分裂,且每次分裂都显著降低了节点不纯度,其平均得分会远高于那些仅在少数树中发挥作用的特征(如 “性别”)。
2. 基于排列的重要性(Permutation Importance)
这种方法更注重特征对模型预测性能的实际影响,逻辑是:打乱某个特征的取值后,若模型预测准确率下降越明显,说明该特征越重要。
对某一特征的取值进行随机排列(打破该特征与目标变量的关联),用打乱后的数据集重新预测。
计算性能指标的下降幅度(如准确率下降值),作为该特征的重要性得分。
相比基于不纯度的方法,排列重要性不受特征类别数量影响(避免了对高基数特征的偏向),结果更稳健,但计算成本更高(需重复训练或预测)。
特征重要性排名的解读与应用
特征重要性排名并非简单的 “得分高低” 排序,需结合业务场景和模型逻辑综合解读,其核心应用场景包括:
1. 排名高低的含义
高排名特征:对模型预测起主导作用,是区分目标类别的关键变量。例如,在房价预测中,“建筑面积”“地段等级” 通常排名靠前,直接决定房价区间。
低排名特征:可能与目标变量关联较弱,或其信息已被其他高重要性特征覆盖(如 “小区绿化率” 与 “地段等级” 高度相关时,前者重要性可能较低)。
2. 排名的相对性与局限性
相对性:重要性得分是相对值(通常归一化到 0-100),需关注排名顺序而非绝对数值。例如,得分 80 与 70 的特征差异,可能小于 70 与 10 的差异。
局限性:
无法反映特征间的交互作用:若 “学历” 和 “工作年限” 共同影响收入,但单独排名可能均不突出。
对高相关性特征不敏感:两个高度相关的特征(如 “体重” 和 “BMI 指数”)可能会 “分摊” 重要性得分,导致两者排名均偏低。
受模型参数影响:随机森林中树的数量、最大深度等参数调整可能导致排名小幅波动,需多次实验验证稳定性。
3. 实例:客户流失预测中的特征重要性排名
某电信公司用随机森林预测用户流失风险,得到特征重要性排名前 5 的特征如下:
| 特征名称 |
重要性得分 |
业务解读 |
| 近 3 个月投诉次数 |
92 |
投诉未解决是流失主因 |
| 套餐性价比 |
85 |
高性价比套餐用户留存率更高 |
| 月均消费金额 |
78 |
高消费用户更关注服务稳定性 |
| 网龄 |
65 |
老用户流失风险较低 |
| 客服联系频率 |
52 |
主动关怀可降低流失风险 |
基于此排名,公司优先优化投诉处理流程,并针对高消费用户推出专属服务,3 个月后用户流失率下降 15%。
特征重要性排名的实践建议
为充分发挥特征重要性排名的价值,实践中需注意:
结合多种计算方法:同时使用不纯度重要性和排列重要性,若排名一致,则结果更可靠。
结合领域知识验证:若排名与业务常识冲突(如 “用户 ID” 排名靠前),需检查特征是否存在数据泄露或异常值。
用于特征选择:根据排名筛选前 N 个特征构建简化模型,在保证精度的前提下提升效率(如从 50 个特征中选取前 20 个)。
总结
随机森林的特征重要性排名是连接模型与业务的桥梁,通过量化特征贡献,既为模型优化提供方向,也为业务决策提供数据支撑。在解读时,需认识到其相对性和局限性,结合多种方法与领域知识综合判断。
无论是筛选关键特征、解释模型行为,还是挖掘业务规律,特征重要性排名都展现了强大的实用价值,是机器学习落地过程中不可或缺的分析工具。
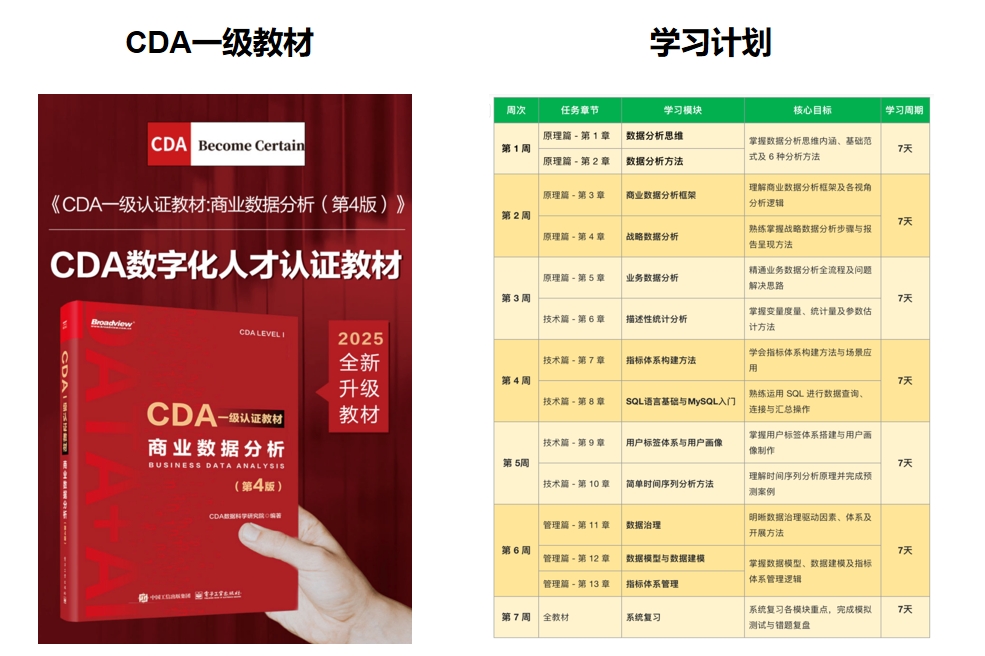
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330