京公网安备 11010802034615号
经营许可证编号:京B2-20210330
单样本t检验的spss实现
直接来看一个例子:
常规种植条件下某玉米品的平均穗重为 300g 。现在采用根外施肥(即将肥料制成液体养分,喷洒到玉米的叶面)后,调查了 20 个玉米棒 ,其穗重如表 1所示。问:改用叶面施肥后,穗重是 否显著增加了 ?(置信度为 95% 或者显著水平 α=0.05)

表1 20个玉米穗的重量(单位:g)
这是一个单尾测验,原假设和备择假设是:

原假设(无效假设):叶面施肥没有增产效果。
备择假设 :叶面施肥有增产效果
在SPSS中不能直接进行单尾测验,但是SPSS却可以输出t统计量的双侧检验相伴概率sig,将得到的相伴概率除以2,即得到单尾测验的相伴概率。将这个相伴概率与0.05进行比较,小于0.05则拒绝原假设。
单样本t检验的SPSS操作
首先将数据导入或者录入到spss中,然后依次 选择分析 <均值比较 <单样本t检验. 出现如下图所示的窗口。

将要检验的变量“穗重”选入到“检验变量”窗口,同时输入给定的用于对比的那个值,此处为常规种植条件下的穗重均值300.设置完毕后,点击确定。输出结果中的描述性统计这里就不讨论了,直接看t检验的结果。

你可以找一本统计学教材,对着t分布表,查看一下自由度为19,显著水平为0.05时,的双侧检验的t临界值,将这里得到的t值与那个临界值进行比较,如果这里的t值大于那个临界值,则拒绝原假设,这和p值小于0.05是等价的。
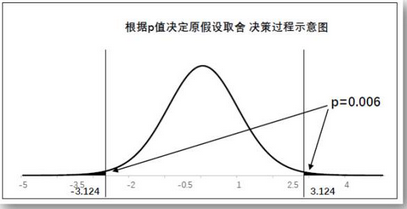
如下图所示,这里得到的双侧t检验相伴概率为0.006,那么单侧相伴概率为0.003,无论是双侧检验还是单侧检验,都可以拒绝原假设,考虑到叶面施肥后的穗重均值为300+7=307,因此认为叶面施肥能够极显著地增加穗重。

双侧检验与单侧检验
下面两张图片中,第一个图中黑色区域表示的是单侧检验的拒绝域。第二个图表示的双侧检验的拒绝域。同样是0.05的置信水平,双侧检验与单侧检验,临界值是不同的,因为黑色区域的位置不同,尽管它们的总面积是相等的。

进行大端单尾测验时,当计算得到的t统计量大于黑色区域与白色区域的临界位置对应的横轴值时,拒绝原假设。而这时,相伴概率也一定小于0.05,因此使用相伴概率和t临界值来决定原假设的取舍,原理本质上是一样的。只不过教材上进行案例讲解时,一般使用临界值,因为相伴概率计算困难。而统计软件一般直接给出相伴概率。(相伴概率即为p值或者spss输出的sig值。)

进行双侧检验时,计算得到的统计量落入两边任意一块黑色区域,就应该拒绝原假设。或者相伴概率小于0.05时,拒绝原假设。(黑色区域表示的是一个很小的概率,这样小的概率,通过一次试验一般是不会发生,如果发生,说明原假设有问题,说明真实的分布不是原假设成立时的这个分布,均值要改变才行,均值改变了才能符合被检验的数据,所以被检验的数据的均值与原来那个设定值是不同的。)
单侧检验的R语言实现
如果你一定要直接得出单侧检验的结果,那也不是没有办法,R语言可以直接得出单侧检验的结果。给出代码如下:
t_test01.1<-read.csv(file="D:/单样本t检验_玉米.csv",header=TRUE)
#载入数据
t.test(t_test01.1$穗重,
alternative =c("greater"),
mu =300, paired =FALSE,
conf.level =0.95
) #进行单样本t检验
输出结果如下
OneSample t-test
data: t_test01.1$穗重
t=3.1239, df=19, p-value =0.002794
alternative hypothesis: true mean is greater than 300
95 percent confidence interval:
303.1254 Inf
sample estimates:
mean of x
307
得到 p-value =0.002794<0.05,拒绝原假设,选择备择假设:alternative hypothesis: true mean is greater than 300。(实际均值大于300)
数据分析咨询请扫描二维码
若不方便扫码,搜微信号:CDAshujufenxi
CDA数据分析师 出品 作者:李诗怡 1. 用户标签体系 定义: 通过一系列高度精炼的特征标识,对用户属性、行为与偏好进行量化刻画 ...
2026-09-24Pandas是Python生态中用于表格数据处理的核心库,广泛应用于数据清洗、统计运算、报表输出、数据分析建模等场景。在处理极大数值 ...
2026-09-24随着数字经济快速发展,数据已成为核心生产要素,各行各业的业务沉淀、用户行为、设备运行、市场交易均产生海量数据。数据处理作 ...
2026-09-24 很多分析师每天和数据打交道,但当被问到“标签是什么”“标签和指标有什么区别”“标签体系如何设计”时,却常常答不上来。 ...
2026-09-24在时序数据分析中,大部分业务数据并非持续平稳变化,而是会在某些时间节点出现突然抬升、断崖下跌、趋势反转、波动异变等现象, ...
2026-09-23在统计学与数据分析中,研究多组数据差异最常用的方法为单因素方差分析与事后多重比较。很多数据分析初学者容易混淆两者功能,认 ...
2026-09-23 很多数据分析师每天都在写 SQL,但当被问到“DQL 的本质是什么”“SELECT 子句的书写顺序与执行顺序为何不同”“INNER JOIN ...
2026-09-23 很多数据分析师写过无数个SELECT查询,但当被问到“如何新建一张表来固化中间数据”“创建视图和创建物理表有什么区别”“视 ...
2026-09-22CDA数据分析师 出品 作者:李诗怡 1. 金字塔原理 定义: 一种“先总后分、先结论后原因”的思考和表达方式。顶层为核心观点,中 ...
2026-09-22数据收集是数据分析、数据挖掘与数字化运营的源头工作,数据收集的完整性、准确性、时效性直接决定后续数据分析结果的可信度与业 ...
2026-09-21箱线图是数据分析中用于识别数据分布、判断离散程度、筛查异常值的核心图表。相比于直方图、趋势图,箱线图可以精准区分正常数据 ...
2026-09-21 很多数据分析师精通Excel函数和数据透视表,但当被问到“数据从哪里来”“表和视图有什么区别”“数据库管理系统和SQL是什么 ...
2026-09-21在数据库数据查询与数据分析工作中,日期时间是最常用的数据类型之一。原始数据库中存储的日期格式多为标准时间戳、年月日时分秒 ...
2026-09-20在时序数据分析中,增长率是衡量数据涨跌幅度、研判发展趋势、识别周期波动的核心指标,主要分为环比增长率与同比增长率。传统Ex ...
2026-09-20 很多企业团队并非缺乏指标,而是陷入“指标失控”:仪表盘上堆满实时跳动的数据,却无法回答“当前瓶颈在哪、下一步该做什么 ...
2026-09-20CDA数据分析师 出品 作者:李诗怡 STP模型(营销战略三步法) 定义: 现代营销战略核心框架,通过市场细分(S)、目标市场选择( ...
2026-09-18在互联网产品迭代、运营优化、界面改版与策略升级过程中,主观经验判断容易造成决策偏差、盲目改版、资源浪费等问题。AB实验(AB ...
2026-09-18 很多企业并不缺少指标,缺少的是让指标“串起来、动起来、用起来”的体系。零散指标像散落一地的珠子,指标体系则是那根把珠 ...
2026-09-18在电商行业精细化运营时代,流量红利逐步消退,粗放式投流、广撒网营销模式已无法适配市场竞争需求。依托用户点击、加购、收藏、 ...
2026-09-17在数据可视化与数据分析工作中,图表是将零散数据转化为直观业务规律的核心工具。不同图表拥有专属的数据逻辑与分析维度,能够从 ...
2026-09-17