python确实是一款很实用的数据分析工具,尤其是在处理重复性工作方面。小编今天给大家推荐的这篇文章就是关于python自动化处理合同的,希望能帮助大家解放双手,实现合同的自动化处理。
文章来源: 早起Python
作者:陈熹
前言
大家好,又到了Python办公自动化系列。
今天我们继续分享一个真实的办公自动化需求:如何使Python+Excel+Word批量生成指定格式内容的合同。
主要涉及的知识点有:openpyxl模块的综合运用与Word文档的两种遍历逻辑。
需求描述
你是乙方建筑公司,手上有一份空白合同模板的Word文件,如下图:
另外还有一份Excel合同信息表,其中是所有甲方(发包人)在合同中需要填写的内容
可见一行为一个公司的全部信息,现在需要把Excel中每一个公司的信息填入空白Word合同模板中,生成各公司的合同,最终结果如下

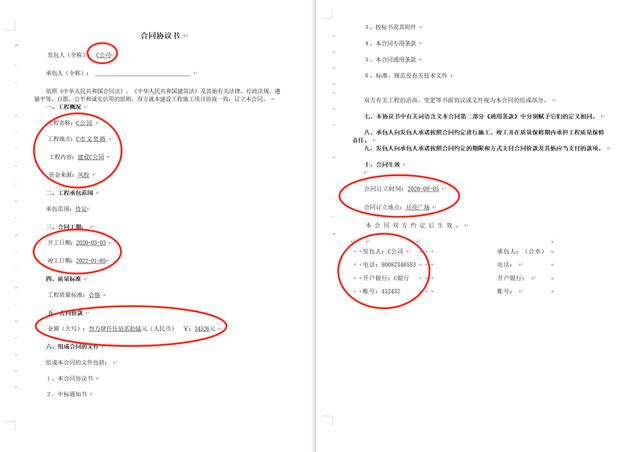
步骤分析
原本我们需要将Excel汇总表中每一行的信息填进word模板中,生成相应的合同。
现在我们需要交给Python来实现,就引出了一个问题:程序如何知道要将某个信息填到哪个下划线? 为了解决这个问题,我们需要对模板进行修改。
即将下划线改成某种标识,让程序可以看到标识就明白此处应该放什么信息,这里采取的策略是:将需要填写的下划线改成汇总表中的列名,即下图所示
这样程序就可以识别需要填写什么内容了。所谓的识别在这里可以换一个特别简单的词,即文本替换。只要检索到#xxxx#(excel中的列名),把这个替换成具体的信息就可以了。
出于这种策略,列名就需要用#xxxx#的格式,否则正常的无关文本中的信息也会被替换,就破坏了原有的需求,最后模板被修改成如下:
通过Excel表我们可以看到,一行为一个公司的信息,而每一列的列名就存在于模板中,用各个公司的实际信息替换到模板中的列名(程序识别和文本替换的依据)
用这样的方法就可以完成这个需求。整个大需求的实现可以按照下面的步骤:
分析后的步骤:
将 空白合同 调整成 合同模板,需要填写的下划线改成专属的列名
打开Excel表,按行循环,然后按单元格逐个循环各个信息,每个信息都找到模板中存在的对应列名并将其替换(如果不理解下文还有解释)
每次循环完一行的全部单元格后保存合同,生存各个公司单独的合同
分析清楚后逻辑就非常简单了,但有一个隐含的知识点没有提到,让我们边写代码边说!
代码实现
首先导入模块,设置路径,建立文件夹,本例中涉及Excel表的打开和Word的创建,因此需要从openpyxl导入load_workbook,而Word无论打开还是创建,用docx模块的Document均可
from docx import Document
from openpyxl import load_workbook
# 利用os模块建立文件夹,用于存放生成的合同
import os

# 给定合同模板和汇总表所在的文件夹路径,方便复用
path = r'C:\Users\chenx\Desktop\合同'

# 结合路径判断生成文件夹,规避程序报错而终止的风险
if not os.path.exists(path + '/' + '全部合同'):
    os.mkdir(path + '/' + '全部合同')
接着打开Excel文件
workbook = load_workbook(path + '/' + '合同信息表.xlsx')
sheet = workbook.active
现在遍历Excel,生成合同。前面也反复提到,Excel的每一行是一份特定合同的信息,因此docx针对Word文件的实例化和保存一定是在循环体里的,而不像Excel的实例化是在循环体外面
# 有效信息行是从第二行开始的,第二行是表头,包含列名,也是文本替换的依据
for table_row in range(2, sheet.max_row + 1):
    # 每循环一行实例化一个新的word文件
    wordfile = Document(path + '/' + '合同模板.docx')
    # 单元格需要逐个遍历,每一个都包含着有用的信息
    for table_col in range(1, sheet.max_column + 1):
        # 旧的文本也就是列名,已经在模板里填好了,用于文本替换,将row限定在第一行后就是列名
        old_text = str(sheet.cell(row=1, column=table_col).value)
        # 新的文本就是实际的信息,table_col循环到某个数值时,实际的单元格和列名就确定了
        new_text = str(sheet.cell(row=table_row, column=table_col).value)
        # 加上这个判断是因为日期信息读进程序是“日期 时间”格式的,如果要保留日期信息可以用字符串方法或者用time/datetime模块处理
        if ' ' in new_text:
            new_text = new_text.split()[0]
通过下图进一步理解这个替换:
例如程序已经进入第3个循环(循环到第3个公司),针对单元格的循环进入第4个循环,那么此时获取的实际值是建设C公园,对应的列名是#工程内容#。
此时就明确了需要被替换的内容了,只要在模板中找到#工程内容#把它替换为建设C公园即可!了解了这个替换后,下一步就是遍历Word模板,找到对应列名替换!
之前我们说过docx模块,Word文本存在文档Document-段落Paragraph-文字块Run的三级结构,需要遍历文本可以用以下代码:
all_paragraphs = wordfile.paragraphs
for paragraph in all_paragraphs:
    print(paragraph.text)
    for run in paragraph.runs:
        print(run.text)
针对段落和文字块均可用.text获取到文字信息。本需求隐含的陷阱就在这里,注意一下合同最后需要填写的内容:
这部分内容如果用上述代码是遍历不到的。为什么?因为这是Word文档中的表格!
遍历表格需要有专门的遍历逻辑:文档Document-表格Table-行Row/列Column-单元格Cell,遍历表格中文本的代码如下:
all_tables = wordfile.tables
for table in all_tables:
    # 也可按列遍历
    for row in table.rows:
        for cell in row.cells:
            print(cell.text)
有了这些补充的知识之后,本案例中最核心的代码就可以这么写
for table_row in range(2, sheet.max_row + 1):
    wordfile = Document(path + '/' + '合同模板.docx')
    for table_col in range(1, sheet.max_column + 1):
        old_text = str(sheet.cell(row=1, column=table_col).value)
        new_text = str(sheet.cell(row=table_row, column=table_col).value)
        if ' ' in new_text:
            new_text = new_text.split()[0]

        # 文档Document - 段落Paragraph - 文字块Run
        all_paragraphs = wordfile.paragraphs
        for paragraph in all_paragraphs:
            for run in paragraph.runs:
                run.text = run.text.replace(old_text, new_text)

        # 文档Document - 表格Table - 行Row/列Column - 单元格Cell
        all_tables = wordfile.tables
        for table in all_tables:
            for row in table.rows:
                for cell in row.cells:
                    cell.text = cell.text.replace(old_text, new_text)

    # 获取公司名用以生成合同的名称
    company = str(sheet.cell(row=table_row, column=1).value)
    wordfile.save(path + '/' + f'全部合同/{company}合同.docx')
写在最后
本次的案例具有较强的实用性,并且需求可以延伸成为:将一份信息汇总表Excel中的每一个单独信息(每一行或者每一列为个人、公司或者其他的信息)填写到指定的模板Eord中,生成单独的文档,不过在写自动化脚本之前也要先拆分任务,明确思路再进行!


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330