在MySQL数据库运维与开发工作中,当单表数据量达到千万级、亿级后,会出现查询卡顿、索引失效、写入性能下降等问题。为优化性能,企业普遍采用水平分表方案,将一张大表拆分为多张结构完全一致的子表,例如按时间分表、ID区间分表、哈希分表。
分表后最大的实操难题是:已知某条数据的ID、时间、手机号等条件,无法快速确定该数据存储在哪一张子表中。如果盲目遍历所有分表,会极大降低查询效率、浪费数据库性能。本文将结合主流分表规则,讲解精准定位数据所在分表的核心方法、通用查询方案、实战案例及避坑技巧,解决分表数据查询难题。
一、MySQL常见水平分表规则(定位数据的核心依据)
所有分表数据的定位,本质都是根据分表字段的规则反向计算所属子表。行业内99%的水平分表仅分为三类,不同规则对应专属的数据定位逻辑。
1. 时间分表(最常用)
按照年、月、日拆分数据表,适用于订单、日志、流水、记录等时序数据。
示例:user_log_202501、user_log_202502、user_log_202503,按月拆分日志表。
2. ID区间分表
按照自增ID的数值范围拆分,均匀分摊数据量,适用于用户表、商品表、订单主表。
示例:order_1(ID 1-10万)、order_2(ID10-20万)、order_3(ID20-30万)。
3. 哈希取模分表
对用户ID、手机号、订单ID取模运算,均匀打散数据,保证各表数据量均衡。
示例:总共有4张分表,规则为 ID % 4,结果0、1、2、3分别对应四张子表。
二、针对性定位:不同分表规则精准查询数据所在表
优先使用规则匹配定位,无需遍历全表,速度最快、性能最高,是生产环境首选方案。
(一)时间分表:通过时间字段直接匹配表名
时间分表的表名自带时间维度,只需提取数据的时间字段,即可精准锁定子表,无需查询数据库。
实战场景:查询2025年8月的用户登录日志,分表格式为user_log_YYYYMM。
定位逻辑:提取数据的create_time字段,格式化为年月,直接匹配对应表名。
示例:已知数据创建时间为2025-08-15,可直接判定数据存在 user_log_202508 表中,直接单表查询,无需遍历其他月份表。
(二)ID区间分表:通过数值范围锁定子表
提前定义好各分表的ID区间,根据目标数据的ID数值,比对区间即可定位对应数据表。
实战场景:订单表按ID区间分表,order_1(1~100000)、order_2(100001~200000)、order_3(200001~300000)。
定位示例:查询订单ID=150000的数据,数值落在100001~200000区间,数据必然在 order_2 表中。
(三)哈希取模分表:公式计算精准定位
哈希分表是开发最常用的均衡分表方式,通过固定取模公式,可100%精准算出数据所在分表,零误差。
通用公式:分表索引 = 分表字段值 % 分表总数
实战场景:用户表共4张分表user_0、user_1、user_2、user_3,分表规则为用户ID%4。
定位示例:用户ID=100,100%4=0,数据存储在 user_0 表中;用户ID=101,101%4=1,数据存储在 user_1 表中。
三、通用万能方案:未知分表规则,批量查询所有分表
若接手老旧项目、不清楚分表规则,或临时查询少量数据,可使用MySQL通用方案,批量查询所有分表,适配所有分表场景。
1. UNION ALL 拼接所有分表查询
将所有子表通过UNION ALL合并查询,直接检索所有分表数据,适合分表数量少的场景。
示例语句:查询ID=100的用户数据
SELECT * FROM user_0 WHERE id=100
UNION ALL
SELECT * FROM user_1 WHERE id=100
UNION ALL
SELECT * FROM user_2 WHERE id=100
UNION ALL
SELECT * FROM user_3 WHERE id=100;
查询有结果即对应所在分表,无结果则数据不存在。
2. 自动查询库内所有同名分表(高阶自动化)
通过information_schema数据库,批量查询当前库下所有符合分表前缀的数据表,无需手动拼接表名,适合分表数量多的场景,高效省力。
四、中间件自动化方案(企业生产最优解)
正规企业生产环境,不会手动计算分表,普遍使用Sharding-JDBC、MyCat等分库分表中间件,彻底解决分表查询难题。
中间件会自动维护分表规则,开发者只需编写普通单表SQL,中间件会自动根据字段值路由到对应子表,无需人工判断数据位置,完全屏蔽分表底层细节,是高并发、大数据量项目的标准方案。
五、分表数据查询常见误区与优化技巧
1. 禁止无脑遍历所有分表
大批量业务查询中,遍历全部分表会造成数据库CPU飙升、索引失效,优先使用分表规则计算定位,仅临时排查场景使用遍历查询。
2. 分表字段必须建立索引
用于分表的时间、ID、手机号字段必须建立索引,定位到子表后,可实现秒级精准查询,避免全表扫描。
3. 禁止跨表关联查询
分表设计本身为了拆分压力,跨多表关联查询会彻底丧失分表性能优势,业务设计需规避跨分表联查。
4. 留存分表规则文档
线上项目必须留存分表规则、分表数量、区间范围文档,避免后续运维人员无法定位数据,增加排查成本。
六、全文总结
MySQL分表后查询数据所在表,核心逻辑可总结为:已知规则靠计算,未知规则靠遍历,生产环境靠中间件。
时间分表、ID区间分表、哈希取模分表,均可通过对应规则精准反向定位数据所属子表,性能最优、效率最高;临时排查可使用UNION ALL遍历查询;企业级项目推荐使用Sharding-JDBC等中间件,实现自动路由查询,彻底屏蔽分表底层复杂度。
掌握分表数据定位方法,能够高效解决分表场景的数据查询、数据排查、数据修复问题,是MySQL运维、后端开发、数据分析师必备的核心实操技能。
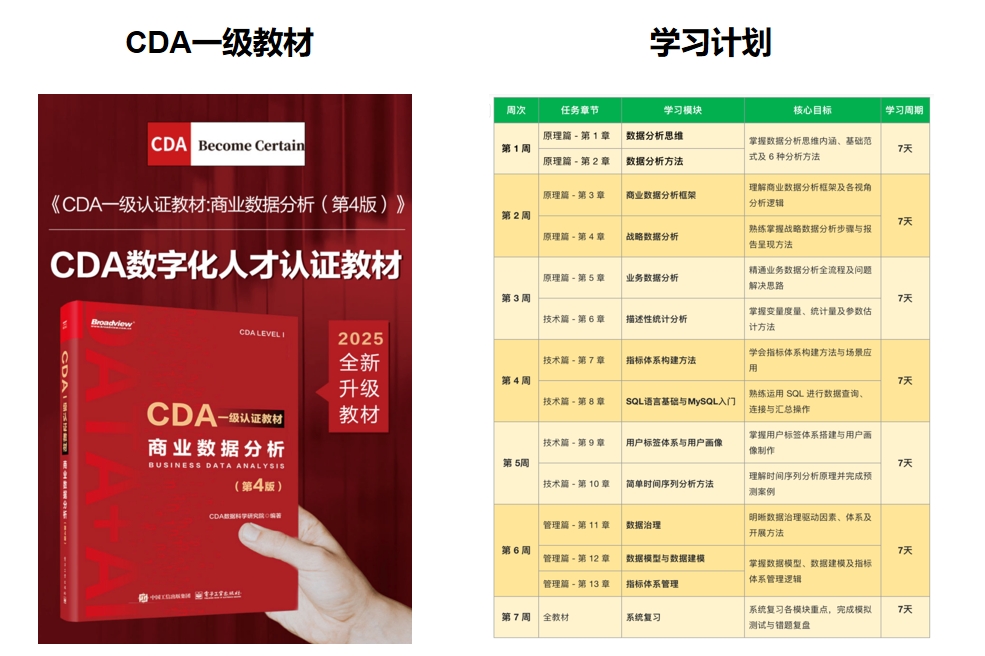
推荐学习书籍 《CDA一级教材》适合CDA一级考生备考,也适合业务及数据分析岗位的从业者提升自我。完整电子版已上线CDA网校,累计已有10万+在读~ !


 京公网安备 11010802034615号
经营许可证编号:京B2-20210330