京公网安备 11010802034615号
经营许可证编号:京B2-20210330
用R进行文本挖掘与分析:分词、画词云
要分析文本内容,最常见的分析方法是提取文本中的词语,并统计频率。频率能反映词语在文本中的重要性,一般越重要的词语,在文本中出现的次数就会越多。词语提取后,还可以做成词云,让词语的频率属性可视化,更加直观清晰。比如下图:
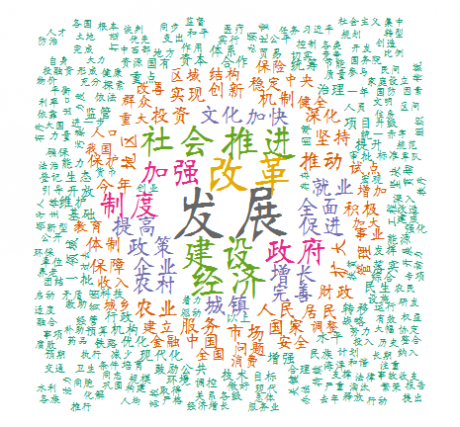
这是根据总理2014年的政府工作报告制作的可视化词云,分词和词云的制作都是用R,词频的统计用了其他软件。这个图能很直观看到,工作报告的重心是”发展”,这是大方向,围绕发展的关键要素有经济建设、改革、农村、城镇等要素。不过这张图中的词语还需要进行优化,因为有些术语或词组可能被拆分成了更小的词语,没有展示出来,为了演示,我就没再花更多时间去优化词库,主要是讲讲分析的方法。
下面是分析方法:
首先,要获得要分析的内容,做成txt文本文件。这个很简单,把要分析的内容粘贴到记事本,保存为txt文件就可以了。
其次,用R进行分词。这里要分几点来讲:
要用R进行分词,需要安装并装载两个library,一个是Rwordseg,另一个是rJava。rJava的作用是提供java的库,供Rwordseg调用。安装后,调用语句如下:
library(rJava)
library(Rwordseg)
说说Rwordseg,这是一个R环境下的中文分词工具,引用了Ansj包,Ansj是一个开源的java中文分词工具,基于中科院的ictclas中文分词算法,采用隐马尔科夫模型(HMM)。Rwordseg牛逼的地方三点,一是分词准确,二是分词速度超快,三是可以导入自定义词库,有意思的是还可以导入搜狗输入法的细胞词库(sqel格式),想想细胞词库有多庞大吧,这个真是太厉害了。
分词的语法。很简单,一个函数就搞定了,看下面:
segmentCN(“待分析文件的完整路径”,returnType=”tm”)
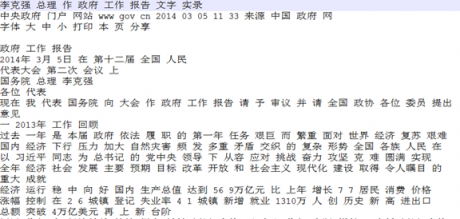
注意:R中的路径用”\\”分割文件夹。参数returnType表示返回的分词格式是按空格间隔的格式。执行完成后,会自动在相同目录生成一个”待分析文件名. .segment.txt”的文本文件,打开可以看到是酱紫:
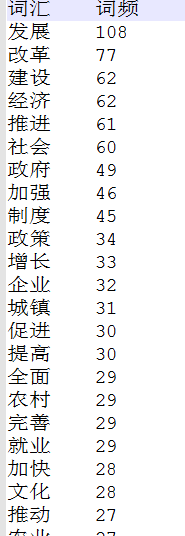
然后,要统计词频。到了这里,每个单词出现的频率是多少,需要统计出来。这个词频统计,我在R中找了一阵,没有找到合适的工具来统计,有人说lm可以统计,试了试不行。于是乎用了其他的软件。这方面的软件不少,大家可以找找,总之,统计出来是酱紫的:
最后,就是画成词云。R有工具可以画词云,当然互联网上有不少网站可以在线制作词云,做得也很漂亮,有兴趣可以去找找,我这里只谈R中的方法:
安装并装载画词云的工具包wordcloud:
library(wordcloud)
读取已经统计好词频的文件:
mydata<-read.table(“已统计好词频的文本文件的完整路径”,head=TRUE)
设置一个颜色系:
mycolors <- brewer.pal(8,”Dark2″)
画图:
wordcloud(mydata$词汇,mydata$词频,random.order=FALSE,random.color=FALSE,colors=mycolors,family=”myFont3″)
然后就可以看到最上面的那个图了。
补充说明:
1、安装rJava:需要先在电脑上下载安装JDK,即java devolop kit,然后再通过R从CRAN上选择安装rJava,否则,即使安装了rJava也用不了。前提是JDK必须先安装好;
2、安装Rwordseg,这个包不在CRAN上,所以不能在R中直接选择在线安装,需要用下面两种方式来安装,输入:
①
install.packages(“Rwordseg”, repos = “http://R-Forge.R-project.org”)
②(如果上面不能安装,则用下面的)
install.packages(“Rwordseg”, repos = “http://R-Forge.R-project.org”, type = “source”)
数据分析咨询请扫描二维码
若不方便扫码,搜微信号:CDAshujufenxi
CDA数据分析师 出品 作者:李诗怡 题目1 一家餐厅统计顾客的性别、年龄、消费金额等信息,在进行数据分析时,发现性别这一变量在 ...
2026-10-16核心资源推荐 CDA教材(2025):https://edu.cda.cn/goods/show/3151CDA模拟题(2025):https://edu.cda.cn/goods/show/2845CD ...
2026-10-16一、为什么要区分这两种分布 在数据分析和统计学中,拿到一组数据后第一件事通常就是看它的分布形态。分布形态决定了你能用什么 ...
2026-10-15一、问题现象 在实际使用 Excel 透视表做数据分析时,经常会遇到这样的情况:数据源表格里明明新增了一行或一列金额数据,数据源 ...
2026-10-15核心资源推荐 CDA教材(2025):https://edu.cda.cn/goods/show/3151CDA模拟题(2025):https://edu.cda.cn/goods/show/2845CD ...
2026-10-15一、什么是预测式发货 预测式发货(Anticipatory Shipping)是亚马逊于2013年12月获得授权的一项美国专利(专利号 US 8,615,473 ...
2026-10-14一、SQL在金融量化体系中的定位 量化投资的本质是用数据驱动决策,而数据处理贯穿量化研究的全生命周期。从原始行情数据清洗、因 ...
2026-10-14核心资源推荐 CDA教材(2025):https://edu.cda.cn/goods/show/3151CDA模拟题(2025):https://edu.cda.cn/goods/show/2845CD ...
2026-10-14CDA数据分析师 出品 作者:李诗怡 四层结构 · 零件与房子 · 六大易错点 一、什么是指标体系 定义:指标体系是整套完整框架 ...
2026-10-13写在开头 先还原一个你大概率见过的场面。 立项会上有人说:我们得做用户画像。 于是团队关进会议室,白板写满便利贴,两小时后 ...
2026-10-13 很多数据分析师每天都在计算指标、制作报表,但当被问到“什么叫指标数据元”“指标数据标准包含哪些核心维度”“指标数据质 ...
2026-10-13在统计学与数据分析研究中,相关性分析分为数值变量分析与分类变量分析两大类。针对身高、销量、分数等连续数值变量,通常采用皮 ...
2026-10-12在Power BI可视化分析体系中,常规表格仅能展示枯燥的数值数据,存在数据对比不直观、强弱规律不突出、维度交叉分析低效等问题。 ...
2026-10-12 很多数据分析师能熟练写SQL、做透视表,但当被问到“数据是从哪里来的?经过哪些加工才进入数据仓库?ETL具体做了什么?”时 ...
2026-10-12在传统零售行业同质化竞争激烈、大众营销转化率持续走低的背景下,依托经验与直觉的粗放式营销逐渐失效。美国塔吉特百货(Target ...
2026-10-10随着智能客服、数字化服务、用户精细化运营的快速普及,传统零散、非标准化的客户服务数据与业务体系逐渐难以支撑高效服务治理。 ...
2026-10-10 很多数据分析师能熟练地写SQL、做透视表、算描述性统计,但当被问到“如何预测用户流失概率”“如何归因销量下滑的关键因素 ...
2026-10-10CDA数据分析师 出品 作者:李诗怡 定义区别 · 场景举例 · 指标分类 · 计算方法 知识体系总览 模块 包含内容 一、核 ...
2026-10-09在数据分析工作流中,业务数据大多存储在各类关系型数据库内,例如MySQL、PostgreSQL、SQLite等。Pandas是Python生态中主流的数 ...
2026-10-09